Jev AI Tidak Mengobrol. Jev Memutuskan. Mengapa Ini Penting bagi Keamanan Siber
Jev menghasilkan keputusan bertipe, bukan prosa. Pendekatan ini dapat menempatkan penilaian semantik di alur kerja keamanan, dengan kebijakan, fallback, verifikasi, dan tinjauan manusia.

Beyond ASPM
Proof-Driven AppSec for teams building with AI
Plexicus uses AI Swarm Pentest to explore authorized application paths, validate what is exploitable, and give teams evidence they can use to prioritize remediation.
Explore AI Swarm PentestJev AI adalah model keputusan dari TypeSafe AI yang mengembalikan pilihan, skor, dan probabilitas bertipe, bukan teks yang digenerasi. Bagi AI untuk keamanan siber, hal ini penting karena sistem keamanan membuat jutaan keputusan kecil yang sensitif waktu, dan model yang memutuskan dalam waktu kurang dari satu detik dengan biaya sangat kecil dapat membawa konteks semantik ke tempat yang terlalu lambat atau mahal bagi LLM besar.
Selama bertahun-tahun, pertanyaan utama AI adalah model mana yang menghasilkan jawaban terbaik. TypeSafe mengajukan pertanyaan lain: bagaimana jika perangkat lunak tidak memerlukan jawaban, melainkan keputusan? Jev, yang dirilis 15 September 2026, menerima konteks dan pertanyaan yang sudah ditentukan lalu mengembalikan pilihan, skor, atau probabilitas bertipe.
LLM dapat menjelaskan alasan sebuah alert mencurigakan, tetapi perangkat lunak sering hanya memerlukan risiko = kritis, tindakan = contain, dan keyakinan = 0,97. Jev melewati tahap prosa: aplikasi menentukan keluaran dan model memberi probabilitas. Integrasi Vercel AI Gateway menjelaskan keputusan Choice, Score, dan Boolean yang dievaluasi paralel.
Evaluasi Security Incidents dari TypeSafe memakai konteks alert, aset, pemilik, tiket, perangkat, maintenance, dan otorisasi. Ia menilai aktivitas tidak sah, catatan yang menjelaskan kejadian, serta kekuatan bukti; kemudian dapat memeriksa kredensial, sesi, proses, jaringan, dan penyebaran sebelum memberi notifikasi, eskalasi, menghentikan proses, atau menonaktifkan akun. Model memperkirakan; kebijakan keamanan menegakkan.
Angka paling menarik dari TypeSafe, termasuk waktu respons 70–500 ms, adalah hasil vendor dan perusahaan mengakui bahwa angka tertinggi berada di ujung atas hasil dunia nyata. Evaluasi Nexus Agent melaporkan 19.118 momen nyata, 36.218 panggilan, serta 469 kasus guardrail. Jev mengambil keputusan pada 58% kasus dan menghasilkan 90 kesalahan total dengan fallback aturan; rules menghasilkan 148, Haiku 99, dan Sonnet 92.
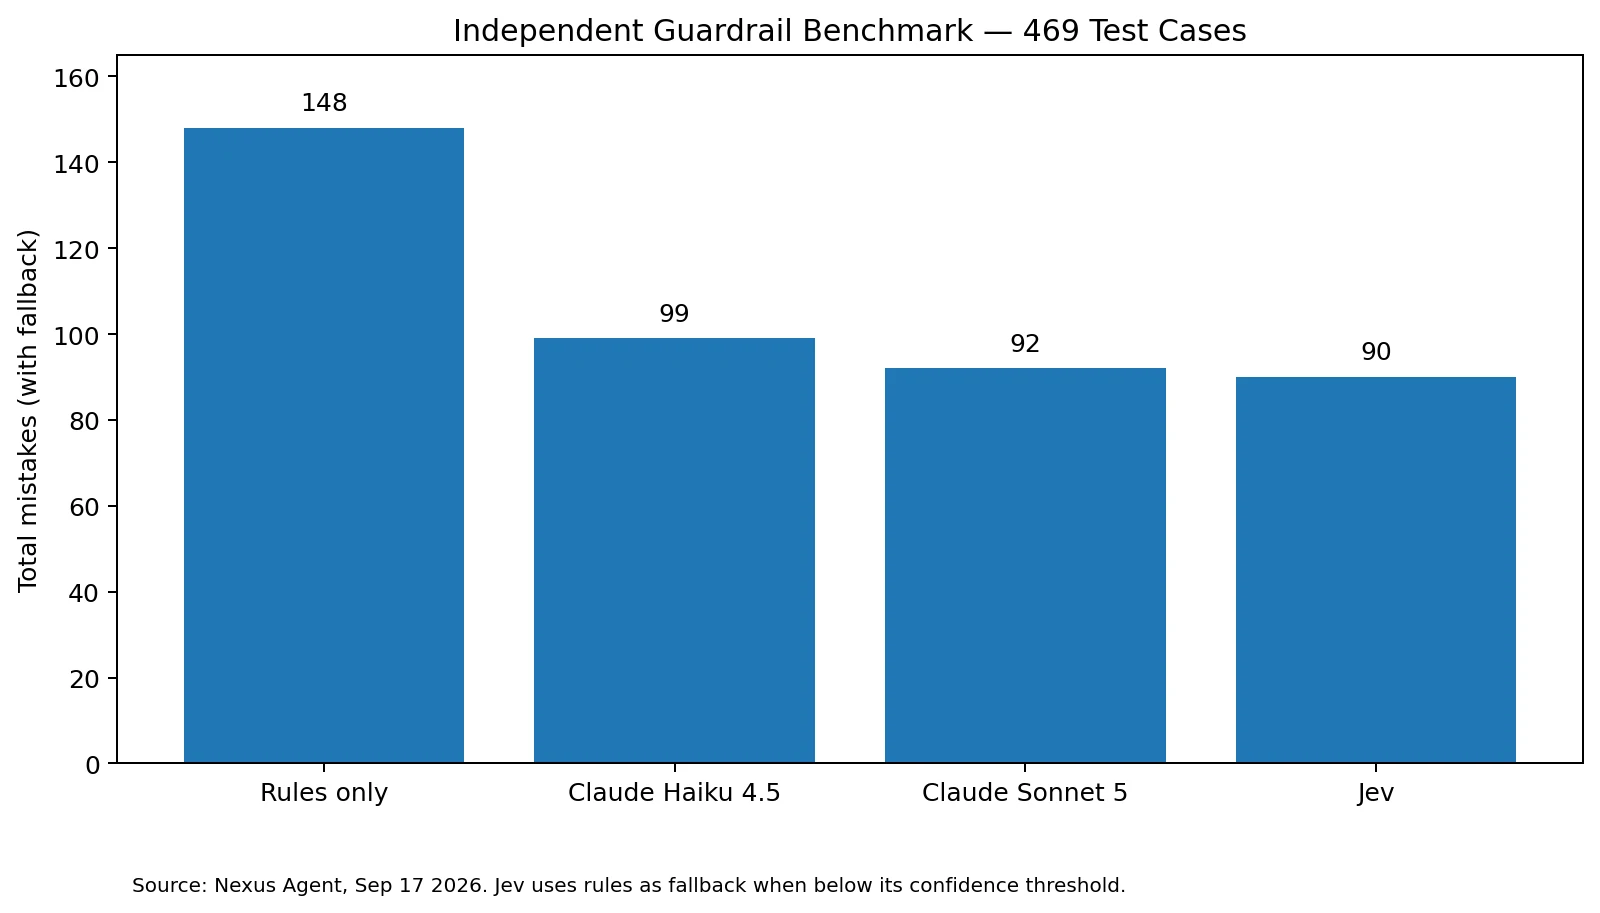
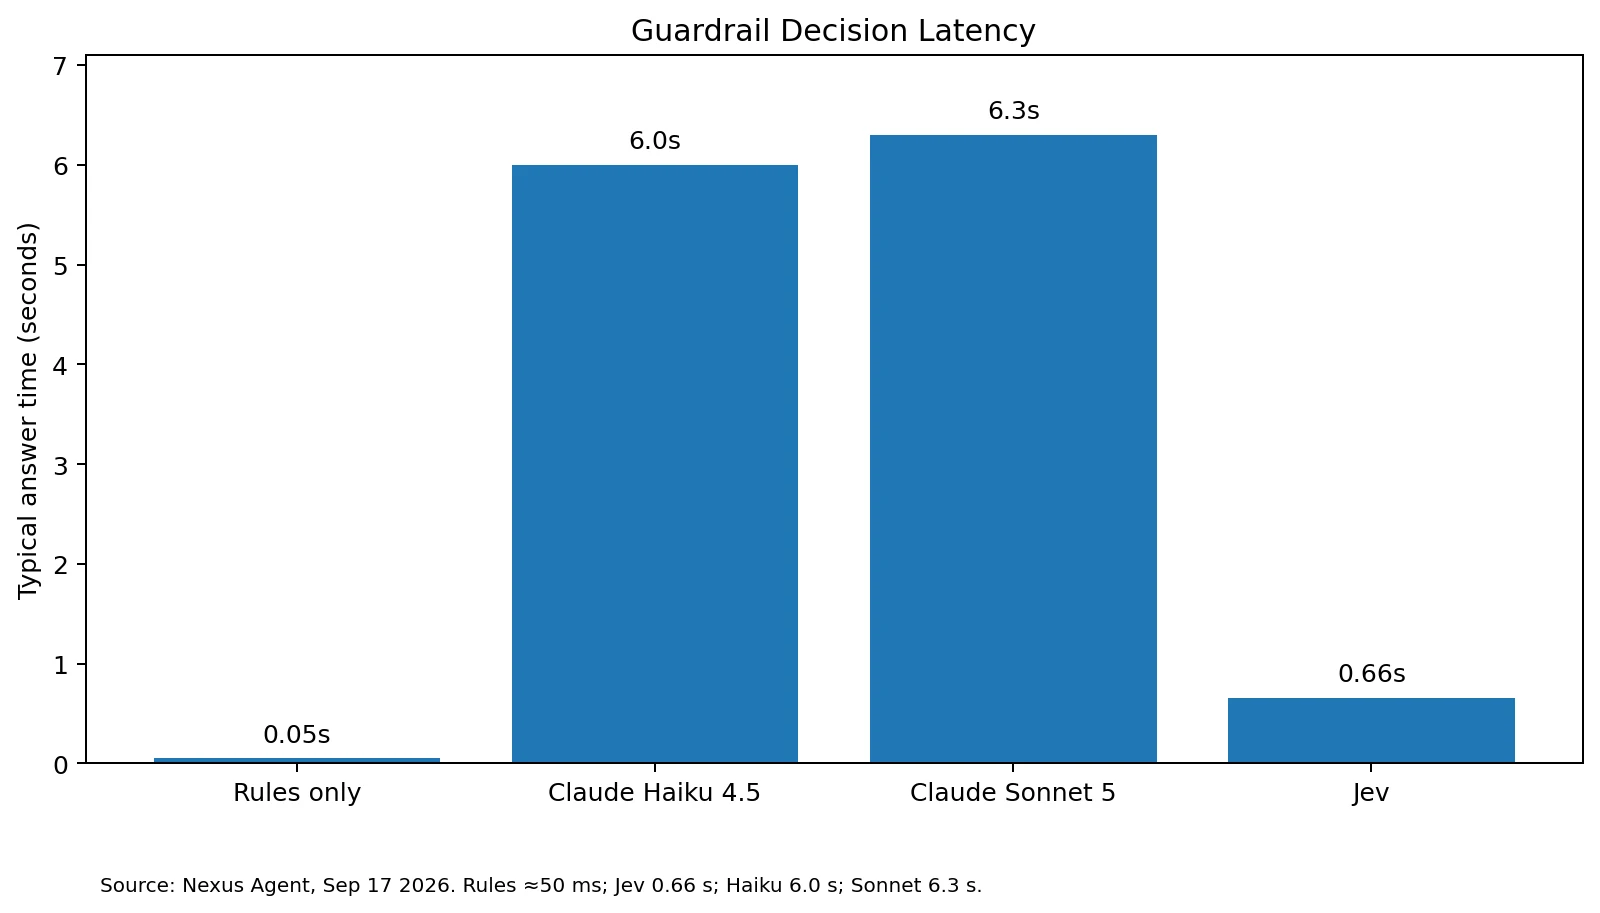
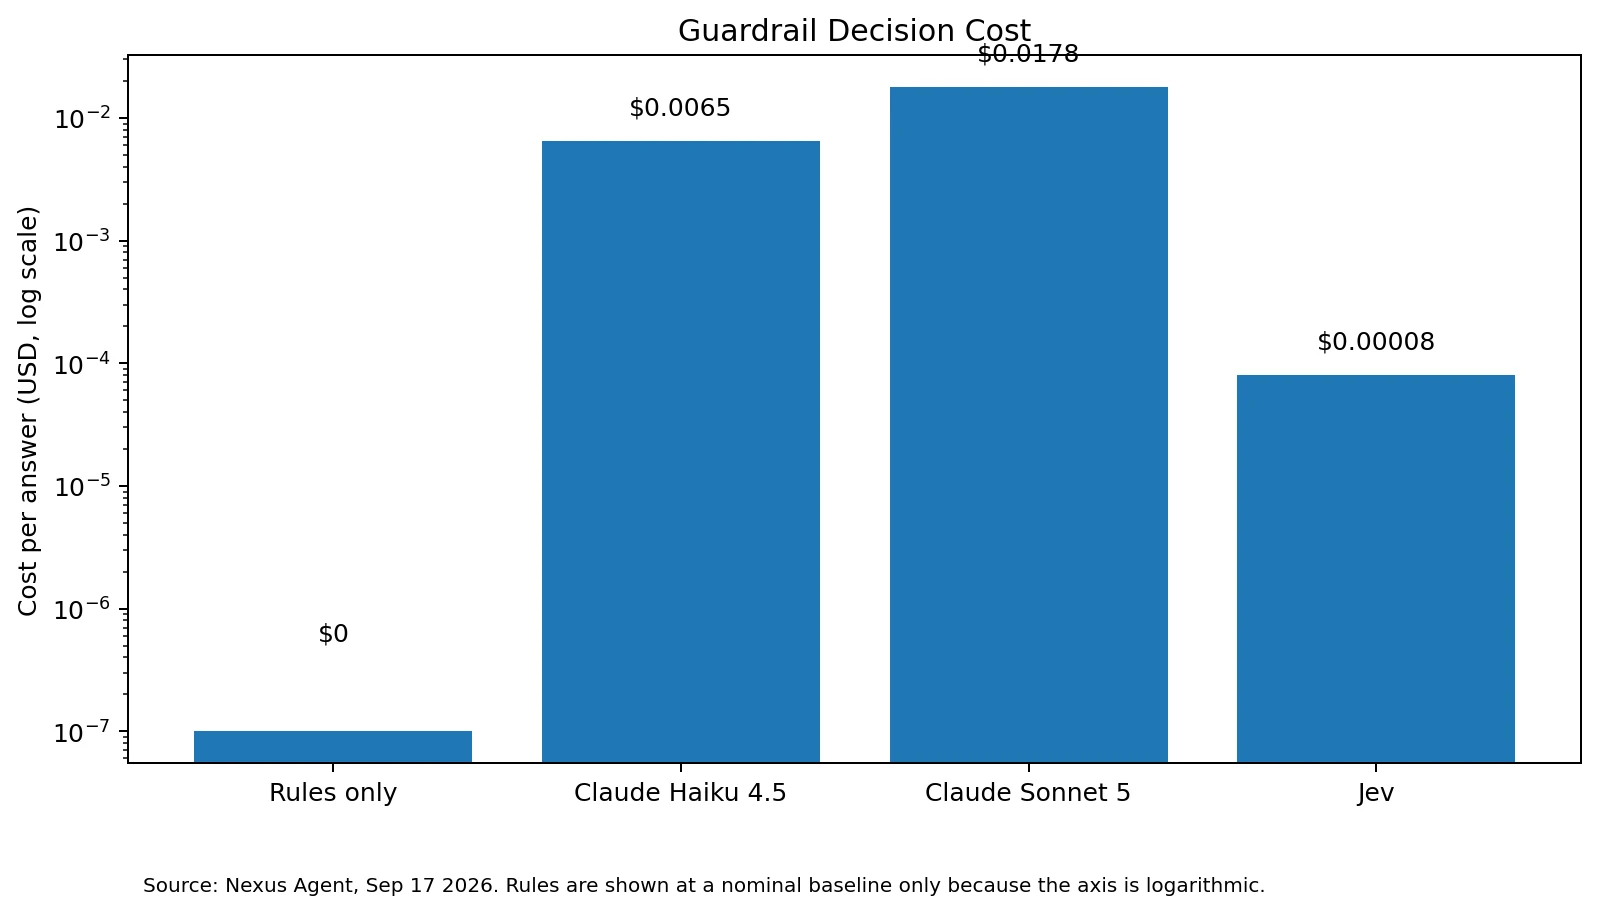
Yang penting adalah cakupan: kesalahan 1,8% saat model memutuskan bukan berarti akurasi universal. Pola yang aman adalah memutuskan ketika keyakinan tinggi dan meneruskan ketidakpastian ke rules, model yang lebih kuat, atau manusia. Kami membahas pertanyaan routing ini lebih dalam di artikel AI in Application Security: Automation vs. Augmentation (bahasa Inggris). Nexus melaporkan median 0,68 detik dan biaya US$0,00008 per keputusan.
Di mana Jev AI penting bagi AI untuk keamanan siber
Di SOC, model keputusan dapat memilah sinyal jinak, tidak pasti, dan berisiko tinggi lebih awal. Ini bukan pengganti analis; tujuannya menyimpan reasoning mahal dan perhatian manusia untuk kasus yang bernilai. Untuk agen AI, lapisan keputusan dapat menilai apakah tindakan bersifat destruktif, dapat dibalik, dan terotorisasi sebelum kebijakan memblokir atau mengeskalasinya. Ini menjawab langsung risiko Excessive Agency (LLM06) dalam OWASP Top 10 for LLM Applications. Pola yang sama berlaku untuk DLP semantik, phishing, IAM, fraud, dan prioritas kerentanan.
Type-safe bukan berarti benar: ALLOW tetap dapat salah saat BLOCK yang tepat. Perlakukan model ini sebagai sensor probabilistik, bukan policy engine yang tidak mungkin salah. Dampak rendah dan keyakinan tinggi dapat diotomatisasi; ketidakpastian, dampak tinggi, atau tindakan tidak dapat dibalik memerlukan investigasi, kontrol, dan otorisasi.
Jev tidak menggantikan reasoning mendalam atau penilaian manusia. Pekerjaan itu tetap milik sistem reasoning, seperti model frontier atau alat multi-agen seperti AI Swarm Pentest. Ia dapat menjadi lapisan khusus antara deteksi, reasoning, verifikasi, kebijakan, dan tindakan. Penilaian editorial: pertahankan batas otorisasi deterministik, verifikasi independen, fallback, dan tinjauan manusia untuk tindakan yang berdampak.
Pertanyaan yang Sering Diajukan
Apa itu Jev AI?
Jev adalah model keputusan yang diperkenalkan TypeSafe AI pada September 2026 sebagai yang pertama dari kategori yang disebut perusahaan sebagai System One Models. Alih-alih menghasilkan teks, Jev menerima konteks dan pertanyaan yang sudah ditentukan, lalu mengembalikan jawaban bertipe Choice, Score, atau Boolean beserta probabilitas yang dapat langsung dipakai perangkat lunak. TypeSafe melaporkan waktu respons 70–500 ms.
Apa bedanya Jev AI dengan LLM seperti GPT atau Claude?
LLM konvensional menghasilkan prosa token demi token yang kemudian harus di-parse oleh perangkat lunak. Jev mengevaluasi pertanyaan yang sudah ditentukan secara paralel dan hanya mengembalikan tipe jawaban yang diizinkan, sehingga tidak menghasilkan keluaran yang rusak. Jev menukar reasoning terbuka dan pembuatan teks dengan kecepatan, biaya rendah, dan keputusan terstruktur, sebagai pelengkap model reasoning.
Apakah Jev AI bisa dipakai untuk keamanan siber?
Kemungkinan besar bisa. TypeSafe telah menerbitkan evaluasi alur kerja untuk insiden keamanan, dan Nexus Agent menguji Jev sebagai guardrail untuk agen AI. Penggunaan yang mungkin mencakup triase SOC, pemeriksaan tindakan agen, DLP semantik, analisis phishing, dan prioritas kerentanan. Buktinya masih awal, jadi tim keamanan sebaiknya memvalidasinya dengan data sendiri.
Apakah “type-safe” berarti Jev AI tidak bisa salah?
Tidak. Type safety hanya menjamin keluaran sesuai skema yang ditentukan aplikasi, misalnya ALLOW, REVIEW, atau BLOCK, bukan bahwa pilihannya benar. Dalam evaluasi Nexus, Jev salah pada 1,8% kasus yang ia putuskan dan meneruskan 42% kasus ke rules fallback. Tindakan yang berdampak tetap memerlukan kebijakan, verifikasi, dan tinjauan manusia.
Bagaimana menerapkan AI untuk keamanan siber secara aman?
Perlakukan keluaran model sebagai sinyal probabilistik, bukan otoritas akhir. Tetapkan ambang keyakinan berdasarkan biaya kesalahan, pertahankan batas otorisasi yang deterministik, teruskan kasus yang tidak pasti ke model yang lebih kuat atau manusia, dan verifikasi hasil secara independen. NIST AI Risk Management Framework dan OWASP Top 10 for LLM Applications adalah titik awal yang baik.
Sumber




