Jev AI non conversa. Decide. Perché conta per la cybersecurity
Jev restituisce decisioni tipizzate, non prosa. Il giudizio semantico può entrare nei flussi di sicurezza con policy, fallback, verifica e revisione umana.

Beyond ASPM
Proof-Driven AppSec for teams building with AI
Plexicus uses AI Swarm Pentest to explore authorized application paths, validate what is exploitable, and give teams evidence they can use to prioritize remediation.
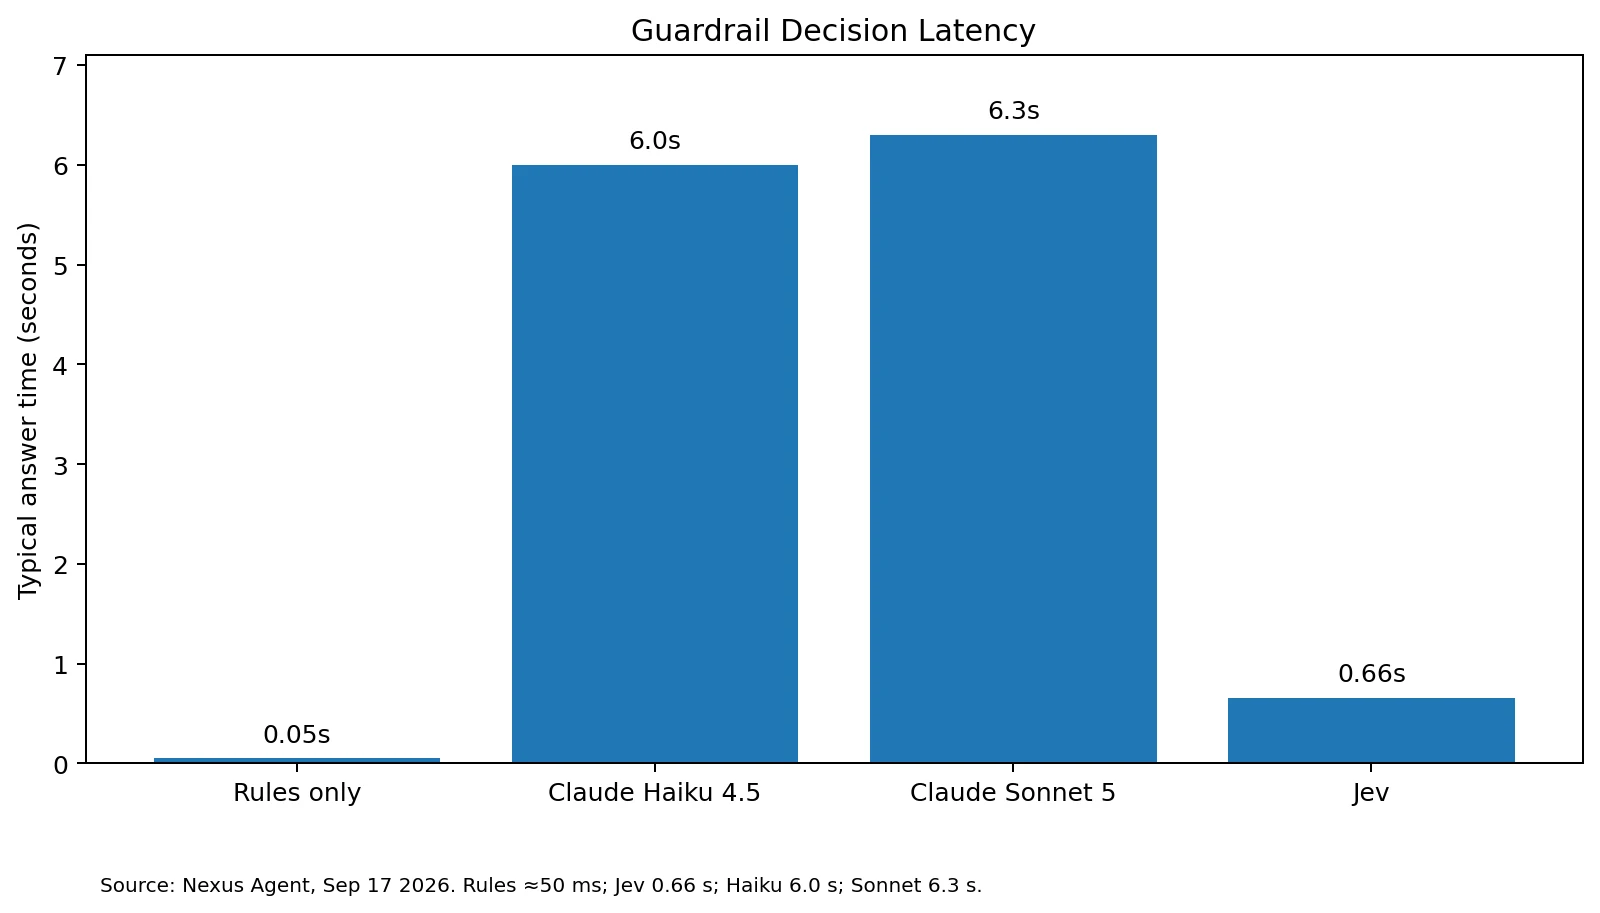
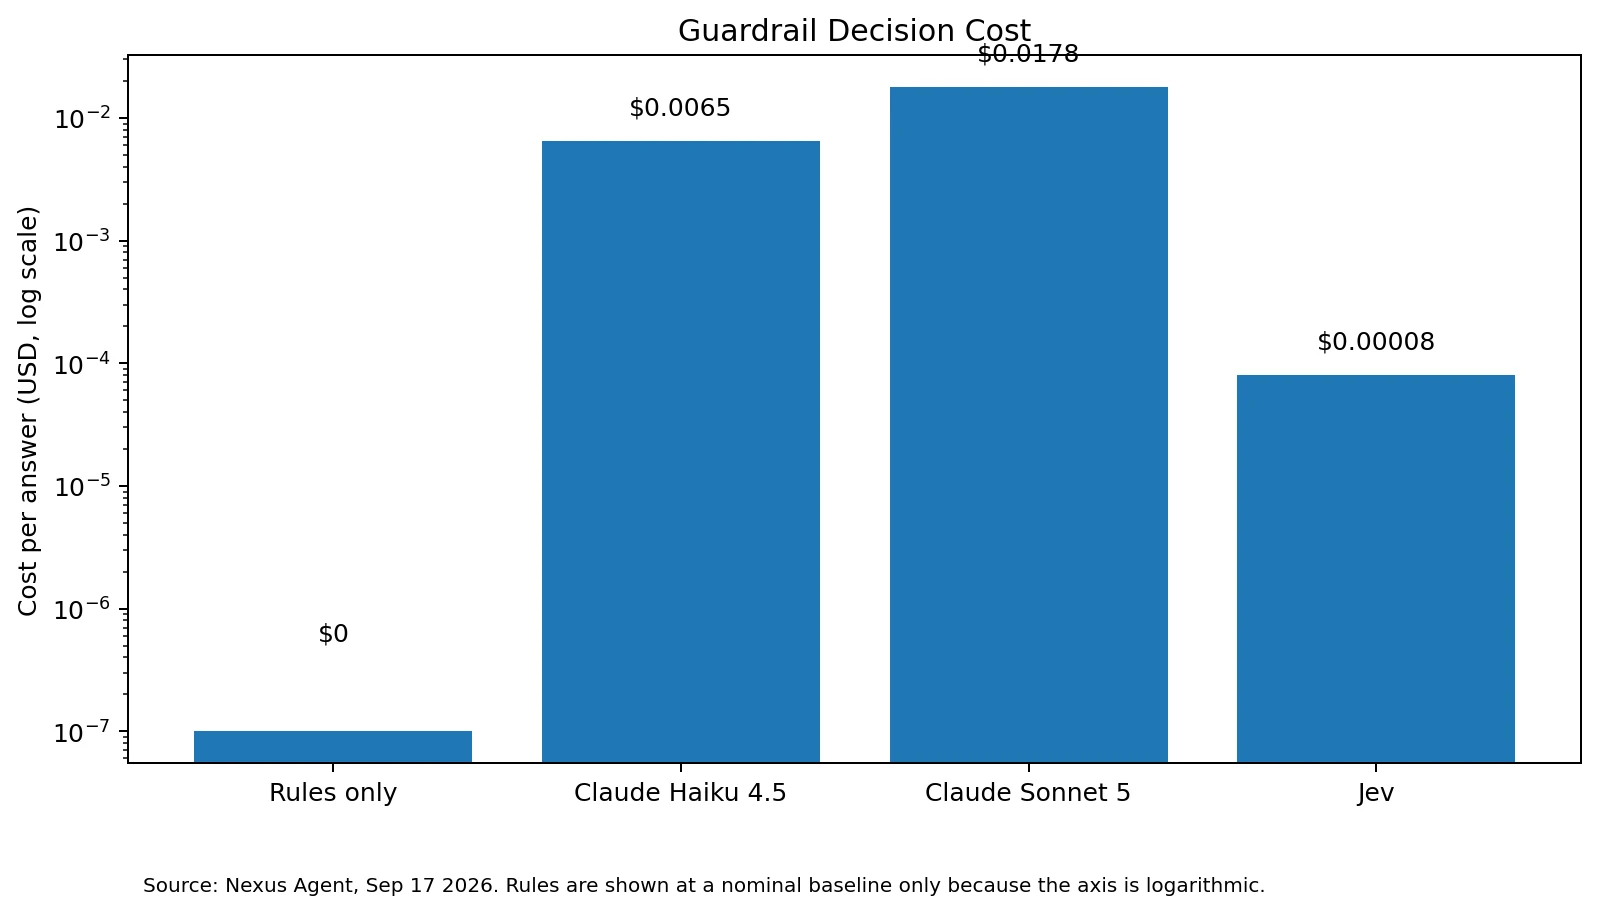
Explore AI Swarm PentestJev AI è un modello decisionale di TypeSafe AI che restituisce scelte, punteggi e probabilità tipizzate invece di testo generato. Per l’IA nella cybersecurity conta perché i sistemi di sicurezza prendono milioni di piccole decisioni urgenti, e un modello che decide in meno di un secondo, per una frazione di centesimo, potrebbe portare contesto semantico dove i grandi LLM sono troppo lenti o costosi.
La domanda dominante dell’IA è stata quale modello generi la risposta migliore. TypeSafe pone un’altra domanda: e se il software avesse bisogno di una decisione, non di testo? Jev, lanciato il 15 settembre 2026, riceve contesto e domande predefinite e restituisce scelte, punteggi o probabilità tipizzate.
Un LLM può spiegare un alert; il software spesso necessita soltanto di rischio = critico, azione = contenere, confidenza = 0,97. Jev salta la prosa: l’applicazione definisce gli output e il modello restituisce probabilità. L’integrazione Vercel AI Gateway descrive decisioni Choice, Score e Boolean in parallelo.
L’eval Security Incidents considera alert, asset, proprietario, ticket, dispositivi, manutenzione e autorizzazioni. Valuta attività non autorizzata, spiegazioni disponibili ed evidenza; poi può valutare credenziali, sessioni, processi, rete e diffusione prima di notificare, escalare, terminare un processo o disabilitare un account. Il modello stima; la policy di sicurezza applica.
I numeri più forti di TypeSafe, inclusi i 70–500 ms di risposta dichiarati, sono risultati del vendor e l’azienda riconosce che rappresentano l’estremo alto dei guadagni reali. Il Nexus Agent riporta 19.118 momenti reali, 36.218 chiamate e 469 casi di guardrail: Jev decide il 58% dei casi e totalizza 90 errori con fallback, contro 148 delle regole, 99 di Haiku e 92 di Sonnet.
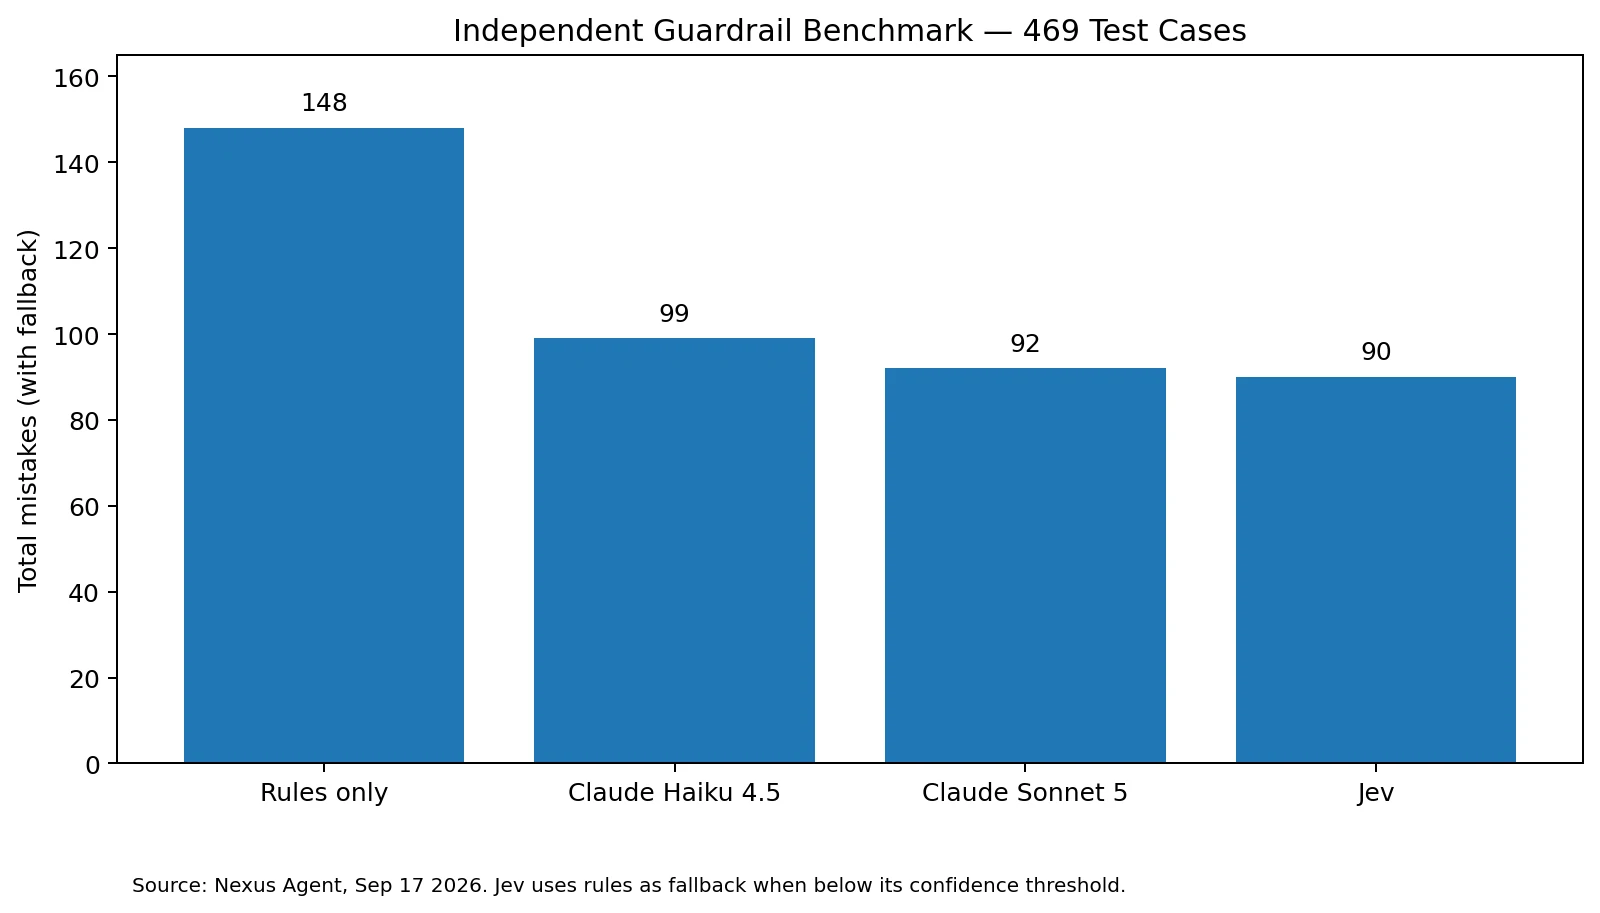
La copertura è fondamentale: 1,8% di errore quando decide non è accuratezza universale. Il pattern utile è decidere quando la confidenza è alta ed escalare l’incertezza a regole, un modello più forte o persone. Approfondiamo questa scelta di instradamento in AI in Application Security: Automation vs. Augmentation (in inglese). Nexus riporta 0,68 secondi di mediana e 0,00008 USD per decisione.
Dove Jev AI conta per l’IA nella cybersecurity
In un SOC, un modello decisionale può separare prima segnali benigni, incerti e ad alto rischio; non sostituisce gli analisti, ma riserva ragionamento costoso e attenzione umana ai casi utili. Per gli agenti IA può valutare se un’azione è distruttiva, reversibile e autorizzata prima che la policy la blocchi o la escali: una risposta diretta al rischio Excessive Agency (LLM06) dell’OWASP Top 10 for LLM Applications. Il modello vale anche per DLP semantico, phishing, IAM, frode e priorità delle vulnerabilità.
La type safety non è correttezza: ALLOW può essere sbagliato quando serve BLOCK. Questi modelli sono sensori probabilistici, non policy engine infallibili. Basso impatto e alta confidenza possono automatizzare; incertezza, impatto elevato o irreversibilità richiedono indagine, controlli e autorizzazione.
Jev non sostituisce ragionamento profondo o giudizio umano, che restano compito di sistemi di reasoning come i modelli frontier o strumenti multi-agente come un AI Swarm Pentest. Jev può essere uno strato fra rilevamento, ragionamento, verifica, policy e azione. Valutazione editoriale: mantenere confini di autorizzazione deterministici, verifica indipendente, fallback e revisione umana per azioni rilevanti.
Domande frequenti
Che cos’è Jev AI?
Jev è un modello decisionale presentato da TypeSafe AI a settembre 2026 come il primo di quelli che l’azienda chiama System One Models. Invece di generare testo, riceve contesto e domande predefinite e restituisce risposte tipizzate Choice, Score o Boolean con probabilità che il software può usare direttamente. TypeSafe dichiara tempi di risposta di 70–500 ms.
In cosa Jev AI differisce da un LLM come GPT o Claude?
Un LLM tradizionale genera prosa token per token, che il software deve poi interpretare. Jev valuta domande predefinite in parallelo e restituisce solo i tipi di risposta consentiti, quindi non produce output malformati. Scambia il ragionamento aperto e la generazione di testo con velocità, costi bassi e decisioni strutturate, affiancando i modelli di reasoning anziché sostituirli.
Jev AI si può usare per la cybersecurity?
Potenzialmente sì. TypeSafe ha pubblicato una valutazione di workflow sugli incidenti di sicurezza e Nexus Agent ha testato Jev come guardrail per agenti IA. Gli usi probabili includono triage nel SOC, controllo delle azioni degli agenti, DLP semantico, analisi del phishing e prioritizzazione delle vulnerabilità. Le evidenze sono ancora iniziali, quindi conviene validarlo sui propri dati.
«Type-safe» significa che Jev AI non sbaglia?
No. La type safety garantisce che l’output rispetti lo schema definito dall’applicazione, per esempio ALLOW, REVIEW o BLOCK, ma non che la scelta sia corretta. Nella valutazione di Nexus, Jev ha sbagliato l’1,8% dei casi decisi e ha passato il 42% dei casi a regole di fallback. Le azioni con conseguenze richiedono ancora policy, verifica e revisione umana.
Come adottare l’IA per la cybersecurity in modo sicuro?
Tratta gli output del modello come segnali probabilistici, non come autorità finale. Imposta soglie di confidenza in base al costo di un errore, mantieni confini di autorizzazione deterministici, inoltra i casi incerti a un modello più potente o a una persona e verifica i risultati in modo indipendente. Il NIST AI Risk Management Framework e l’OWASP Top 10 for LLM Applications sono buoni punti di partenza.
Fonti




