Was ist Deep Code Analysis? (Und warum SAST + LLM nicht ausreicht)
Regex-SAST liefert Tausende theoretische Findings. LLM-gestütztes Review liefert überzeugende Neuschreibungen, die vielleicht nicht einmal kompilieren. Deep Code Analysis ist die dritte Schicht: ein strukturelles Modell Ihres Codes, das beweist, welche Findings real, erreichbar und es wert sind, behoben zu werden.
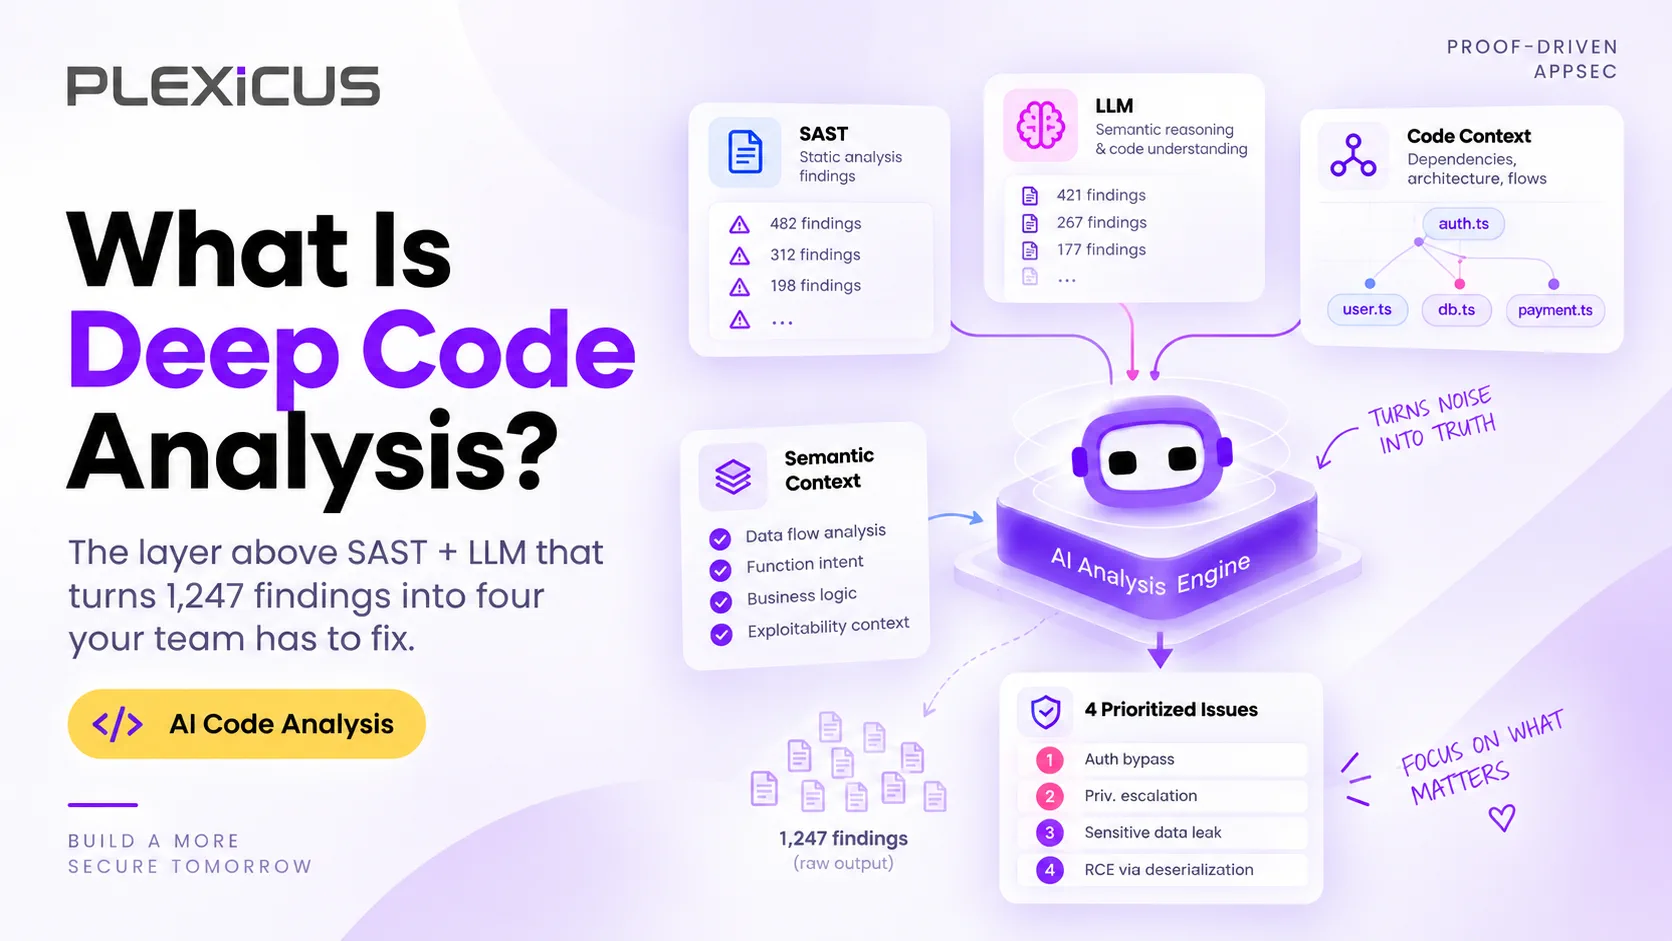
Wenn Sie jemals ein SAST-Dashboard geöffnet, zum Ende einer 12.000-zeiligen CSV gescrollt und gedacht haben “Ich werde das alles nie triagieren”, verstehen Sie bereits das Problem, für dessen Lösung Deep Code Analysis gebaut wurde. Sie verstehen auch, warum es nicht reicht, ein Large Language Model auf dieselbe Regex-Engine zu setzen.
Dieser Leitfaden erklärt, was Deep Code Analysis tatsächlich ist, warum SAST plus LLM-Wrapper Sie immer noch mit Tausenden nicht behebbaren Findings zurücklässt, und was sich ändert, wenn Sie eine strukturelle Schicht vor Ihre Scanner setzen. Wenn Sie den Unterschied zwischen SAST, DAST und SCA bereits kennen, springen Sie zu dem Abschnitt, der beschreibt, wie die Schicht darüber aussieht.
Die Kurzfassung
Deep Code Analysis ist die Praxis, ein strukturelles Modell der Hosts, Endpunkte, Parameter und Fähigkeiten Ihrer Anwendung aufzubauen und dann jedes Sicherheits-Finding an einen konkreten Punkt in diesem Modell zu binden. Ein Finding ohne Erreichbarkeitspfad, Fähigkeitsklasse und Zeilennummer ist kein Finding. Es ist Rauschen.
Das unterscheidet die Praxis von Legacy-SAST und von den “SAST + LLM”-Wrapper-Produkten, die 2024–2025 den Markt fluteten. Beide sind im Kern Pattern-Matcher. Der eine nutzt Regex. Der andere nutzt einen Transformer, der die Regex-Ausgabe in besserem Englisch zusammenfasst.
Keiner von beiden beantwortet die einzige Frage, die Ihrem Security-Team wichtig ist:
Von den Tausenden von Schwachstellen, die mein Scanner gerade gefunden hat, welche wenigen kann ein Angreifer tatsächlich gegen den Produktionscode ausnutzen, den wir letzten Dienstag ausgeliefert haben?
Deep Code Analysis beantwortet diese Frage. Alles andere ist Klempnerei.
Was SAST falsch gemacht hat
SAST — Static Application Security Testing — ist seit Anfang der 2000er das Arbeitspferd der Anwendungssicherheit. Die Kategorie hat sich ihren Platz verdient. Aber die Engines haben sich nicht viel verändert. Die meisten funktionieren immer noch so:
- Sie parsen die Quelldatei.
- Sie wenden eine Reihe von regulären Ausdrücken oder AST-Besuchern an, die nach bekanntermaßen schlechten Mustern suchen (
eval,innerHTML,string.format, hartcodierte Anmeldedaten, schwache Kryptografie und einige hundert weitere). - Sie emittieren ein Finding mit CVSS-Score, CWE, Dateipfad und Zeilennummer.
Dieses Modell hat drei strukturelle Probleme, die keine noch so “KI-erweiterte” Hülle übertünchen kann.
Problem 1 — Pattern-Matcher lesen keinen Code
Eine Regex sieht eval(input) und markiert es. Sie sieht nicht, dass input bereits zwei Funktionen weiter oben in der Aufrufkette bereinigt wurde. Sie sieht nicht, dass dieser konkrete Zweig nur von einem Konfigurationsendpunkt aus erreichbar ist, der an localhost gebunden ist. Sie sieht nicht die Guard-Klausel, die Ihr Senior-Engineer vor sechs Monaten hinzugefügt hat.
Das Ergebnis: Die meisten SAST-Findings sind unerreichbar, niedrig in der Auswirkung oder bereits mitigiert. Die interessanten Fehler — Broken Object Level Authorization, fehlende Rate Limits, ein Business-Logic-Fehler im neuen Stripe-Webhook — sind genau die, die die Regex nicht trifft.
Problem 2 — Es gibt kein Erreichbarkeitsmodell
Ein Finding auf Zeile 117 von src/routes/users.js ist bedeutungslos, ohne zu wissen, wie Nutzereingaben dorthin gelangen, was sie tun, wenn sie ankommen, und ob die Route überhaupt exponiert ist.
Legacy-SAST stoppt am Call-Site. Es kann Ihnen nicht sagen:
- Welche HTTP-Route diese Funktion bedient
- Ob die Route öffentlich oder nur hinter einem VPN exponiert ist
- Ob die Authentifizierung vor dem Call-Site läuft
- Ob der Eingabeparameter tatsächlich vom Nutzer kontrolliert wird
- Ob der Datensenke, die er erreicht (eine Datenbank, eine Shell, eine Datei), von diesem konkreten Einstiegspunkt ausnutzbar ist
Sie bekommen ein Finding. Sie bekommen keinen Pfad.
Problem 3 — Es gibt kein Fähigkeitsmodell
Eine Datei zu lesen ist nicht dasselbe wie Identitätserlangung. Netzwerk-Reach ist nicht dasselbe wie Code-Ausführung. Eine parametrisierte Abfrage zu erreichen ist nicht dasselbe wie eine nicht bereinigte zu erreichen.
Legacy-SAST kollabiert diese Unterscheidungen in einen einzigen Schweregrad-Score. Es behandelt jedes readFile gleich, unabhängig davon, ob die Datei ein statisches Asset oder ein privater Schlüssel ist. Das macht die Prioritätenliste nutzlos.
Was das Aufsetzen eines LLMs auf SAST nicht behoben hat
2024 war die offensichtliche Antwort auf das SAST-Rauschen, ein Large Language Model hinzuzufügen. Den Scanner in einen Agent einwickeln. Das Modell den Befund zusammenfassen, einen Patch vorschlagen oder die Findings nach “realer Ausnutzbarkeit” ordnen lassen.
Das half bei einer Sache: Die Wand aus CSV-Text wurde zu einer Wand aus lesbaren Zusammenfassungen. Es löste keines der drei strukturellen Probleme oben. Es machte sie nur lesbarer.
Die harten Grenzen bleiben:
- LLMs führen Code nicht zuverlässig aus. Wenn ein LLM ein Snippet “reviewt”, pattern-matcht es auf Tokens. Es führt das Programm nicht aus. Es kann nicht beweisen, dass das Snippet erreichbar ist, nur dass es aussieht wie die Art von Snippet, die es oft ist.
- LLMs halluzinieren Korrekturen. Wenn ein LLM gebeten wird, eine Schwachstelle zu patchen, schreibt es die Call-Site manchmal so um, dass sie kompiliert, aber nicht mehr der ursprünglichen Geschäftslogik entspricht. Ein menschlicher Reviewer muss das erkennen. Die meisten Teams können nicht jeden KI-vorgeschlagenen Patch reviewen.
- LLMs erben SASTs blinde Flecken. Wenn der zugrundeliegende Scanner die Broken Object Level Authorization nicht sieht, wird keine Menge nachträglicher Zusammenfassung sie hervorbringen.
Das Ergebnis der “SAST + LLM”-Welle war ein überzeugenderes, polierteres und immer noch unbegründetes Signal. Der Auditor kann das Finding immer noch nicht erneut ausführen. Der Entwickler weiß immer noch nicht, ob er dem vorgeschlagenen Patch vertrauen soll. Der CISO bekommt immer noch ein Dashboard voller grüner Häkchen, die in der Produktion nichts bedeuten.
Das erzeugte die Nachfrage nach Deep Code Analysis als Kategorie.
Was Deep Code Analysis tatsächlich ist
Deep Code Analysis hat einen anderen Ausgangspunkt. Statt “scan die Datei auf schlechte Muster” lautet die Frage “was ist diese Anwendung, von oben bis unten, und was kann was erreichen?”.
Konkret hat die Praxis vier Verschiebungen:
1. Aufbau eines strukturellen Modells der Anwendung
Die erste Passage geht die gesamte Codebasis (und das IaC, das die Runtime definiert) durch und erzeugt ein strukturelles Modell der Anwendung:
- Hosts — Dienste, serverlose Funktionen, Drittanbieter-APIs
- Endpunkte — HTTP-Routen, gRPC-Methoden, Message-Queue-Handler
- Parameter — jede Eingabe, die eine Endpunktgrenze überschreitet
- Fähigkeiten — was jeder Knoten lesen, schreiben, ausführen, exfiltrieren oder eskalieren kann
Das Modell ist die Quelle der Wahrheit. Findings sind Positionen darin, nicht Zeilen in einer Datei.
2. Bindung jedes Findings an einen Pfad
Wenn die Engine ein Finding vorschlägt (ob aus einem Pattern, einem erlernten Modell oder einer von Menschen verfassten Regel), muss sie Folgendes anhängen:
- Den Erreichbarkeitspfad — Endpunkt, Parameter, Handler, Senke
- Die Fähigkeitsklasse — Lesen, Schreiben, Impersonation, RCE, Exfiltration
- Die Zeilennummer — für den menschlichen Reviewer
Ein Finding ohne alle drei wird verworfen. Das ist das Gegenteil von Legacy-SAST, das ein Finding emittiert, sobald es ein Pattern trifft, und die Pfadentdeckung dem Menschen überlässt.
3. Erreichbarkeit mit einer unabhängigen Passage verifizieren
Das ist der entscheidende Unterschied. Die Engine, die ein Finding vorschlägt, ist nicht dieselbe, die es bestätigt. Eine zweite Passage spielt den vorgeschlagenen Exploit gegen eine in einer Sandbox isolierte Kopie des Ziels erneut ab. Nur Findings, die sich reproduzieren lassen, werden behalten.
Es ist dieselbe Logik wie die wissenschaftliche Methode. Eine Behauptung ist kein Finding, bis sie einen unabhängigen Test überlebt.
4. Dem Engineer ein reproduzierbares Artefakt übergeben
Jedes überlebende Finding wird mit Evidenz ausgeliefert, die ein Auditor ausführen kann, ein Entwickler ausführen kann und ein CI-Gate ausführen kann. Eine Anfrage, ein Skript oder ein Sandbox-Zustand.
Wenn ein Finding nicht reproduziert werden kann, ist es kein Finding.
Die Audit-Spur, die ein Auditor tatsächlich lesen kann
Die Ausgabe von Deep Code Analysis ist für die Leute strukturiert, die die Arbeit nachgelagert verteidigen müssen. Für jedes Finding enthält der Bericht:
| Feld | Was es dem Auditor sagt |
|---|---|
| Graphknoten | Welcher Host, Endpunkt, Parameter |
| Erreichbarkeitspfad | Die vollständige Kette von Anfrage zu Senke |
| Fähigkeitsklasse | Lesen, Schreiben, Impersonation, RCE, Exfiltration |
| Verifiziert durch | Welche unabhängige Passage es reproduziert hat |
| Evidenzreferenz | Die Anfrage, der Job oder der Sandbox-Zustand zur erneuten Ausführung |
| Zeilen | Genauer Dateipfad und Zeilennummer |
| Tainted via | Wie die Nutzereingabe durch das System fließt |
Ein Auditor, der das liest, kann das Finding erneut ausführen, die Trace prüfen und die Schwere bestätigen. Er muss nicht auf das Wort des Anbieters vertrauen.
Warum die reinen LLM-Tools nicht aufholen können
Die Versuchung ist, anzunehmen, dass der “SAST + LLM”-Wrapper mit besseren Foundation-Modellen irgendwann gleichwertig zu Deep Code Analysis wird. Wird er nicht, aus drei Gründen:
- LLMs bauen keine strukturellen Modelle. Sie konsumieren sie als Eingabe. Ohne den vorgelagerten Schritt des Modellaufbaus fasst das LLM flachen Text zusammen und erfindet den Pfad zwischen zwei Knoten.
- LLMs können ihre eigenen Findings nicht verifizieren. Der Verifikationsschritt erfordert, tatsächlich Code gegen das Ziel auszuführen. LLMs können Code nicht zuverlässig ausführen, und ihre Selbstkonsistenzprüfungen sind schwächer als eine unabhängige Reproduktions-Passage.
- LLMs halluzinieren die Geschäftslogik. Ein LLM weiß nicht, dass
/api/users/:iddie Eigentümerschaft am Datensatz erzwingen soll, bevor es ihn zurückgibt. Das strukturelle Modell kodiert diese Einschränkung auf Endpunktebene. Das Sprachmodell kann sie nicht aus Token-Statistiken ableiten.
Deep Code Analysis ersetzt das LLM nicht. Sie gibt dem LLM die strukturierte Eingabe, die es braucht, um nützlich zu sein — und sie gibt dem Engineer die Wahrheit, die er braucht, um den Vorschlägen des Modells zu vertrauen.
Wie Deep Code Analysis mit AI Swarm Pentest zusammenspielt
Bei Plexicus ist Deep Code Analysis die erste Hälfte der Schleife. AI Swarm Pentest ist die zweite. Zusammen sehen sie so aus:
- Deep Code Analysis baut das strukturelle Modell auf und schlägt Findings vor.
- AI Swarm Pentest sondiert jedes vorgeschlagene Finding innerhalb des vereinbarten Scopes.
- Eine unabhängige Passage spielt den ursprünglichen Exploit gegen den vorgeschlagenen Patch erneut ab und fordert Evidenz.
- Nur Findings, die beide Passagen überleben — vorschlagen und verifizieren — landen im Bericht.
Was überlebt, ist klein, präzise und reproduzierbar. Ihr Team behebt eine Handvoll Dinge, statt Tausende zu triagieren. Ihr Auditor spielt eine Handvoll Reproduktionen erneut ab, statt ein 90-seitiges PDF zu lesen.
Das ist die Messlatte. Alles andere ist Rauschen.
Die praktische Frage: Ist das nur Marketing?
Die ehrliche Antwort ist: Vor einem Jahr war es teilweise Marketing. Die Kategorie hatte keinen Namen, die Produkte, die behaupteten, es zu tun, wickelten Regex-Engines in LLM-Zusammenfassungen ein, und der Beweis für “tief” war ein längeres PDF.
2026 ist die Praxis auf vier operative Signale konvergiert:
- Das Werkzeug kann “ist das erreichbar?” mit einem Pfad beantworten, nicht mit einer Vermutung. Wenn Ihr aktueller Scanner das nicht kann, macht er keine Deep Code Analysis.
- Das Werkzeug kann “was ist die Fähigkeitsklasse?” mit einer echten Taxonomie beantworten. Nicht CVSS. Nicht “hoch/mittel/niedrig”. Eine Fähigkeit.
- Das Werkzeug kann ein reproduzierbares Artefakt für jedes überlebende Finding erzeugen. Ausführbar von einem Auditor, einem CI-Gate und einem Entwickler.
- Das Werkzeug kombiniert Vorschlagen und Verifizieren. Wer das Finding vorschlägt, ist nicht dasselbe wie das, was es bestätigt.
Wenn Ihr aktueller Stack alle vier erfüllt, haben Sie bereits Deep Code Analysis — egal wie der Anbieter es nennt. Wenn er drei erfüllt, sind Sie nahe dran. Wenn er zwei oder weniger erfüllt, haben Sie ein SAST-Dashboard mit besserem Marketingtext.
Wo Sie anfangen
Wenn Sie den Unterschied sehen wollen, brauchen Sie keine sechsmonatige Evaluierung. Wählen Sie ein Repository, einen Branch, einen produktionsähnlichen Build. Führen Sie Ihren aktuellen Scanner aus. Zählen Sie die Findings. Führen Sie dann eine Deep Code Analysis-Passage gegen dasselbe Ziel aus. Zählen Sie die Findings, die eine unabhängige Reproduktion überleben.
Der Abstand zwischen diesen beiden Zahlen ist das Budget, das Sie für Triage ausgegeben haben, die nie hätte stattfinden müssen.
Weiterführende Lektüre:
- Deep Code Analysis — Produktseite
- 78 % der KI-generierten PRs enthalten eine Schwachstelle — wie die tatsächliche Fehlerrate in der Produktion aussieht
- Das autonome Remediation-Playbook — was passiert, nachdem ein Finding die Reproduktion überlebt hat