Jev chattet nicht. Es entscheidet. Warum das für Cybersicherheit zählt.
Jev liefert typisierte Entscheidungen statt Prosa. Das kann verändern, wo semantisches Urteilsvermögen in Sicherheitsabläufe gehört – mit Richtlinien, Fallbacks, Verifikation und menschlicher Prüfung.

Seit Jahren lautet die zentrale KI-Frage: Welches Modell erzeugt die beste Antwort? TypeSafe AI stellt eine andere: Was, wenn Software keine Antwort, sondern eine Entscheidung braucht?
Am 15. September 2026 stellte TypeSafe Jev vor. Das Modell nimmt Kontext und vordefinierte Fragen entgegen und gibt typisierte Auswahlwerte, Scores oder Wahrscheinlichkeiten zurück. Für die Sicherheit kann das bedeutsam sein: Systeme müssen fortlaufend beurteilen, ob ein Login verdächtig ist, ein Prozess beendet werden soll oder eine Agentenaktion die Berechtigung überschreitet.
Vom Sprachgenerieren zum Entscheiden
Ein LLM kann eine verdächtige Warnung begründen. Software benötigt oft nur:
risiko = kritisch
aktion = eindämmen
konfidenz = 0,97
Jev überspringt die Prosa. Die Anwendung definiert mögliche Ausgaben, das Modell liefert Wahrscheinlichkeiten. TypeSafe beschreibt dies als unstrukturierten Zustand hinein, typisierte probabilistische Entscheidungen heraus. Die Vercel-AI-Gateway-Integration nennt Choice-, Score- und Boolean-Entscheidungen, die parallel ausgewertet werden.
Ein Sicherheits-Workflow als Testfall
Die TypeSafe-Evaluierung Security Incidents berücksichtigt Warnung, Asset, Eigentümer, Tickets, Geräte, Wartung und Berechtigungen. Zuerst bewertet sie unberechtigte Aktivität, erklärende Aufzeichnungen und Evidenzstärke. Bei möglicher Eindämmung folgen Fragen zu Zugangsdaten, Sitzungen, E-Mail, Persistenz, Prozessen, Netzwerk und Ausbreitung. Mögliche Maßnahmen sind Benachrichtigung, Eskalation, Prozessbeendigung und Kontosperre.
Das ähnelt SIEM-, SOAR- und Triage-Abläufen. Bei einem verwalteten Gerät, einer genehmigten Reise und einer VPN-Änderung reichen starre Schwellenwerte oft nicht. Ein Entscheidungsmodell könnte Wahrscheinlichkeiten für unberechtigte Aktivität, zulässige Erklärung, Kompromittierung und nötige Eindämmung liefern. Das Modell schätzt; die Sicherheitsrichtlinie setzt durch.
Frühe externe Evidenz
TypeSafe nennt 70–500 ms und 0,042 USD pro Million Eingabetokens sowie sehr große Workflow-Vorteile. Das sind Herstellerangaben. TypeSafe weist selbst darauf hin, dass die größten Gewinne das obere Ende realer Ergebnisse darstellen und eigene Spezialisten die Workflows erstellten.
Die Nexus-Agent-Auswertung berichtet von 19.118 realen Momenten und 36.218 Jev-Aufrufen. In 469 Guardrail-Fällen entschied Jev 58% der Fälle und kam mit Regel-Fallback auf 90 Gesamtfehler; Regeln hatten 148, Haiku 99 und Sonnet 92.
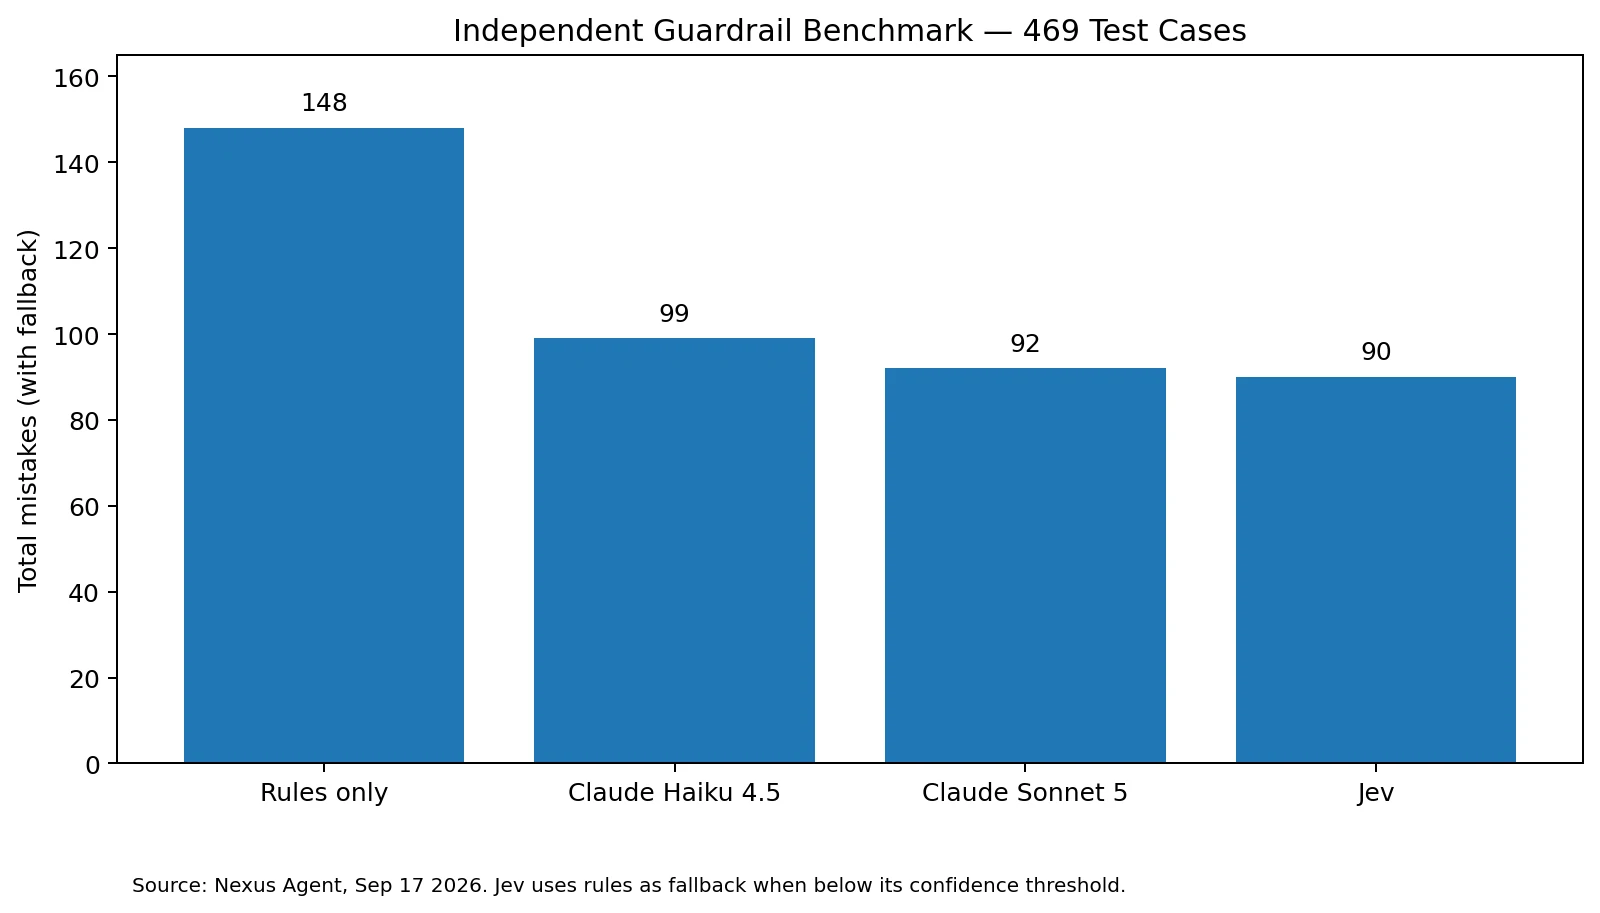
Abbildung 1. Gesamtfehler mit Fallback. Quelle: Nexus Agent, 17. September 2026.
Entscheidend ist die Abdeckung: 1,8% Fehler bei eigenen Entscheidungen bedeutet keine universelle Genauigkeit. Das sinnvolle Muster lautet: nur bei ausreichender Sicherheit entscheiden und Unklares an Regeln, ein stärkeres Modell oder Menschen weitergeben.
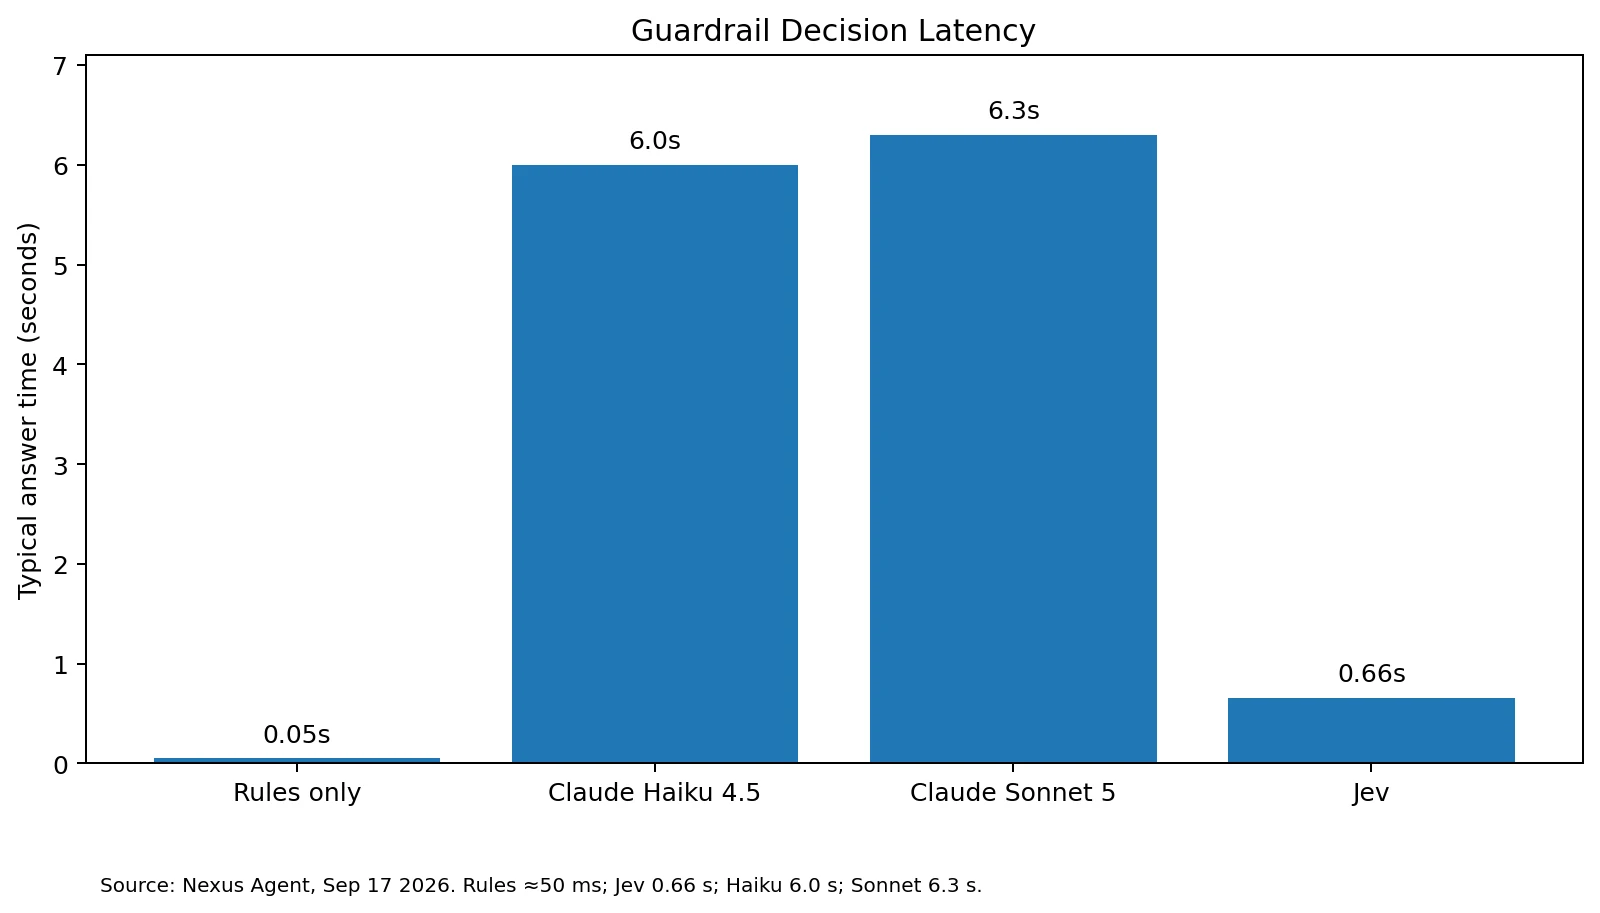
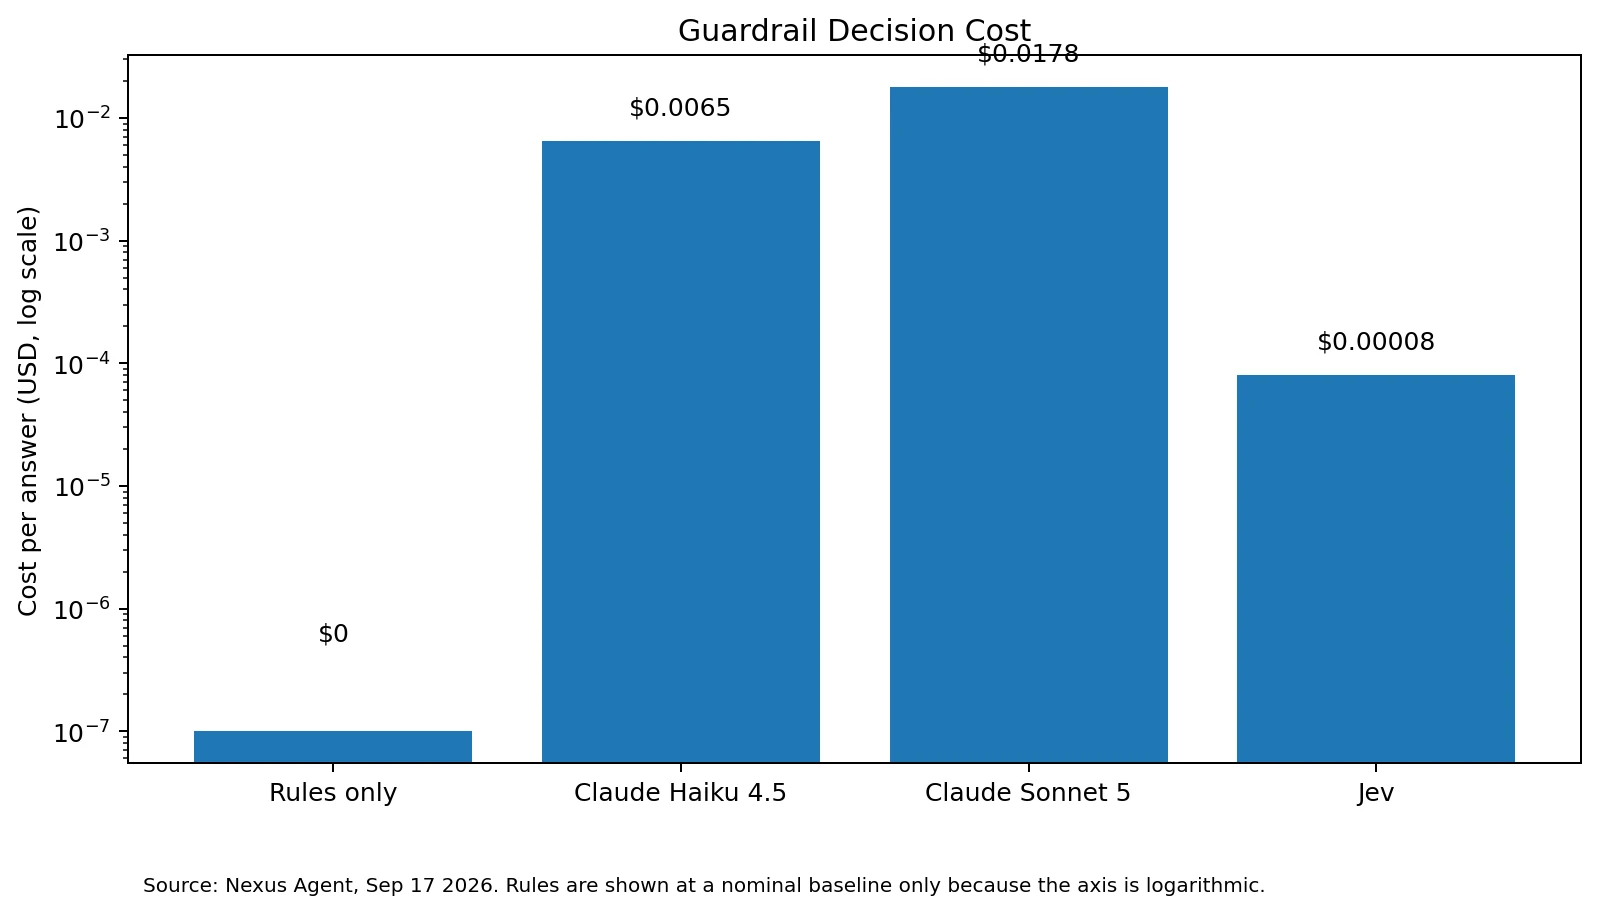
Nexus berichtet in diesem Szenario eine Medianlatenz von 0,68 Sekunden und 0,00008 USD je Jev-Entscheidung.
Relevante Sicherheitsfälle
In einem SOC könnte ein Entscheidungsmodell Signale früher in harmlos, unklar und hochriskant einordnen. Es ersetzt keine Analysten, sondern reserviert teures Reasoning und menschliche Aufmerksamkeit für die Fälle mit echtem Mehrwert.
Es kann außerdem eine Guardrail-Schicht für KI-Agenten bilden. Vor einer irreversiblen Aktion kann es Destruktivität, Umkehrbarkeit, Autorisierung und notwendige menschliche Freigabe bewerten. Die Richtlinie kann eine Aktion blockieren, selbst wenn das primäre Reasoning-Modell sie ausführen möchte. Das Muster passt auch zu semantischem DLP, Phishing, IAM, Betrug und Schwachstellenpriorisierung.
Typsicher ist nicht korrekt
Dass Jev keine Ausgabe außerhalb des Schemas erzeugt, ist wertvoll, beweist aber nicht die inhaltliche Richtigkeit. Das Modell kann ALLOW liefern, wenn BLOCK richtig wäre. Sicherheitsverantwortliche sollten solche Modelle als probabilistische Sensoren, nicht als unfehlbare Richtlinien-Engines behandeln.
Entscheidung + Konfidenz → Sicherheitsrichtlinie
hohe Konfidenz + geringe Auswirkung → automatisieren
Unsicherheit → untersuchen
hohe Auswirkung oder Irreversibilität → stärkere Kontrollen und Freigabe
Der Schaden einer Fehlentscheidung muss die Schwelle bestimmen: Spam zu löschen und eine Produktionsdatenbank zu löschen dürfen niemals dieselbe Schwelle haben.
Die richtige Frage
Jev ersetzt weder tiefes Reasoning noch Forschung oder menschliches Urteil. Es ist eine mögliche spezialisierte Schicht zwischen Erkennung, Reasoning, Verifikation, Richtlinie und Aktion.
Für einen endgültigen Durchbruch ist es zu früh: die stärksten Kennzahlen bleiben Herstellerwerte, und Nexus testete eine konkrete Agentenumgebung. Relevant ist dennoch die Frage: Welche Sicherheitsentscheidungen sind heute zu häufig, zu schnell oder zu günstig für KI – und was verändert sich, wenn diese Grenze fällt?
Redaktionelle Bewertung: Sicherheitskritische Implementierungen brauchen weiterhin deterministische Autorisierungsgrenzen, unabhängige Verifikation, Fallbacks und menschliche Prüfung bei folgenreichen Aktionen.
Quellen





