Jev não conversa. Decide. Por que isso importa para a cibersegurança.
Jev entrega decisões tipadas, não prosa. Isso pode colocar julgamento semântico em fluxos de segurança, sempre com política, fallback, validação e revisão humana.

A pergunta dominante da IA tem sido qual modelo gera a melhor resposta. A TypeSafe pergunta outra coisa: e se o software precisa de uma decisão, não de texto? Lançado em 15 de setembro de 2026, Jev recebe contexto e perguntas pré-definidas e devolve escolhas, pontuações ou probabilidades tipadas.
De gerar linguagem a decidir
Um LLM pode explicar uma alerta; o sistema geralmente precisa de risco = crítico, ação = conter, confiança = 0,97. Jev elimina a prosa: a aplicação define as saídas e o modelo devolve probabilidades. A integração no Vercel AI Gateway descreve Choice, Score e Boolean em paralelo.
A avaliação Security Incidents reúne alerta, ativo, proprietário, tickets, dispositivos, manutenção e autorizações. Ela avalia atividade não autorizada, explicação disponível e força da evidência; depois pode examinar credenciais, sessões, processos, rede e propagação antes de notificar, escalar, encerrar processo ou desabilitar conta. O modelo estima; a política de segurança impõe.
Evidência inicial
Os números mais fortes da TypeSafe são resultados do fornecedor, e a empresa reconhece que representam o limite superior dos ganhos reais. A análise do Nexus Agent relata 19.118 momentos reais, 36.218 chamadas e 469 casos de guardrail. Jev decidiu 58% e registrou 90 erros totais com fallback de regras; regras tiveram 148, Haiku 99 e Sonnet 92.
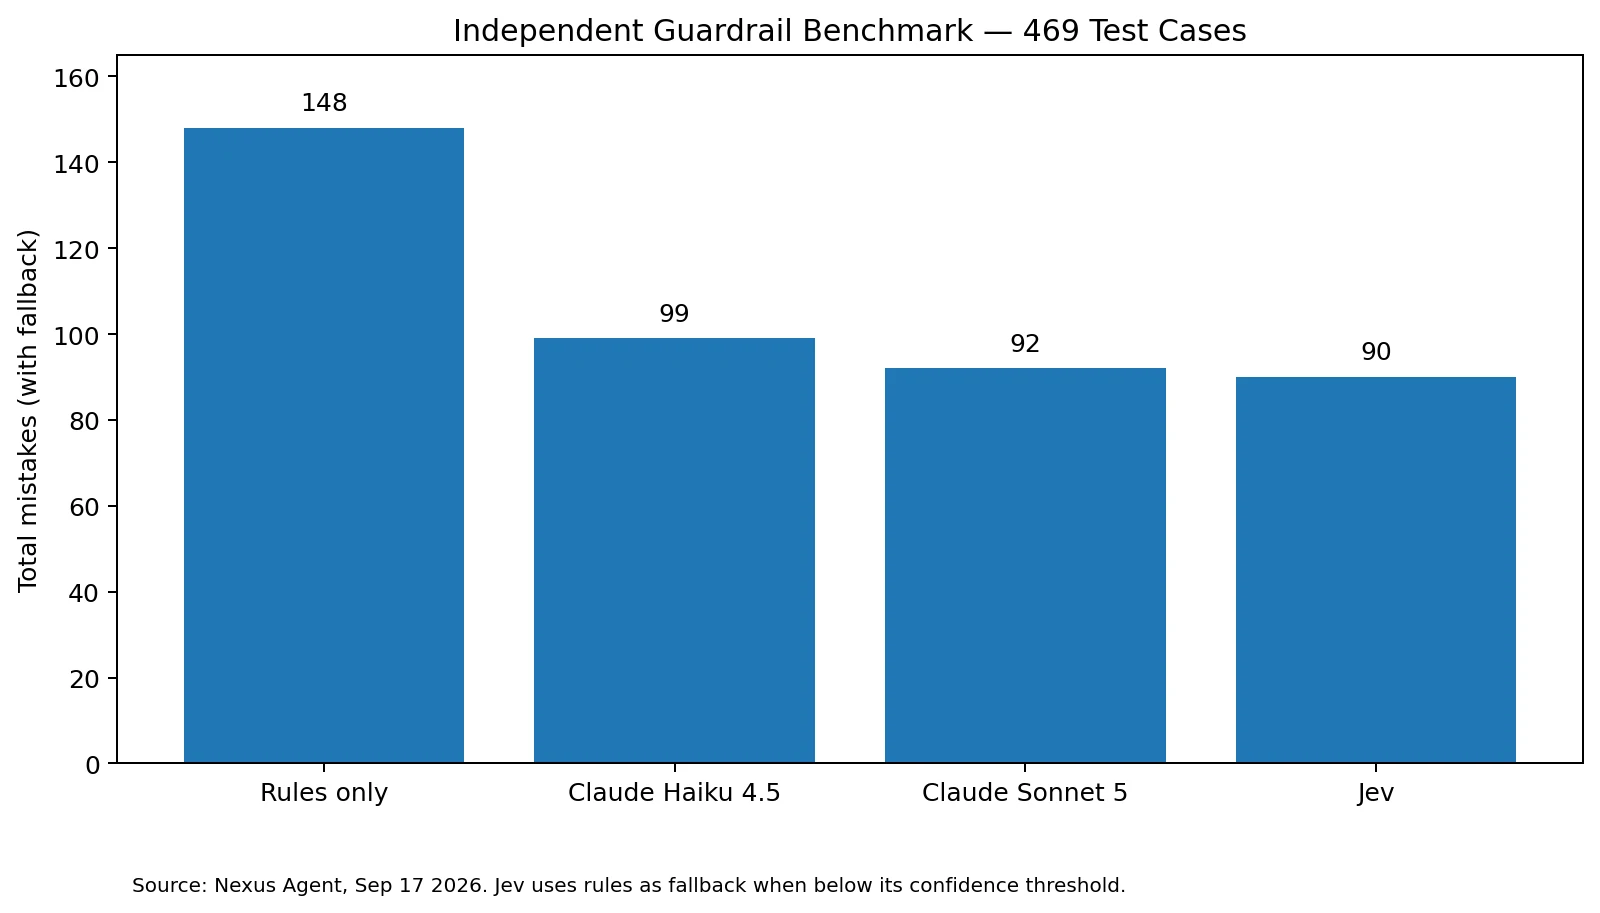
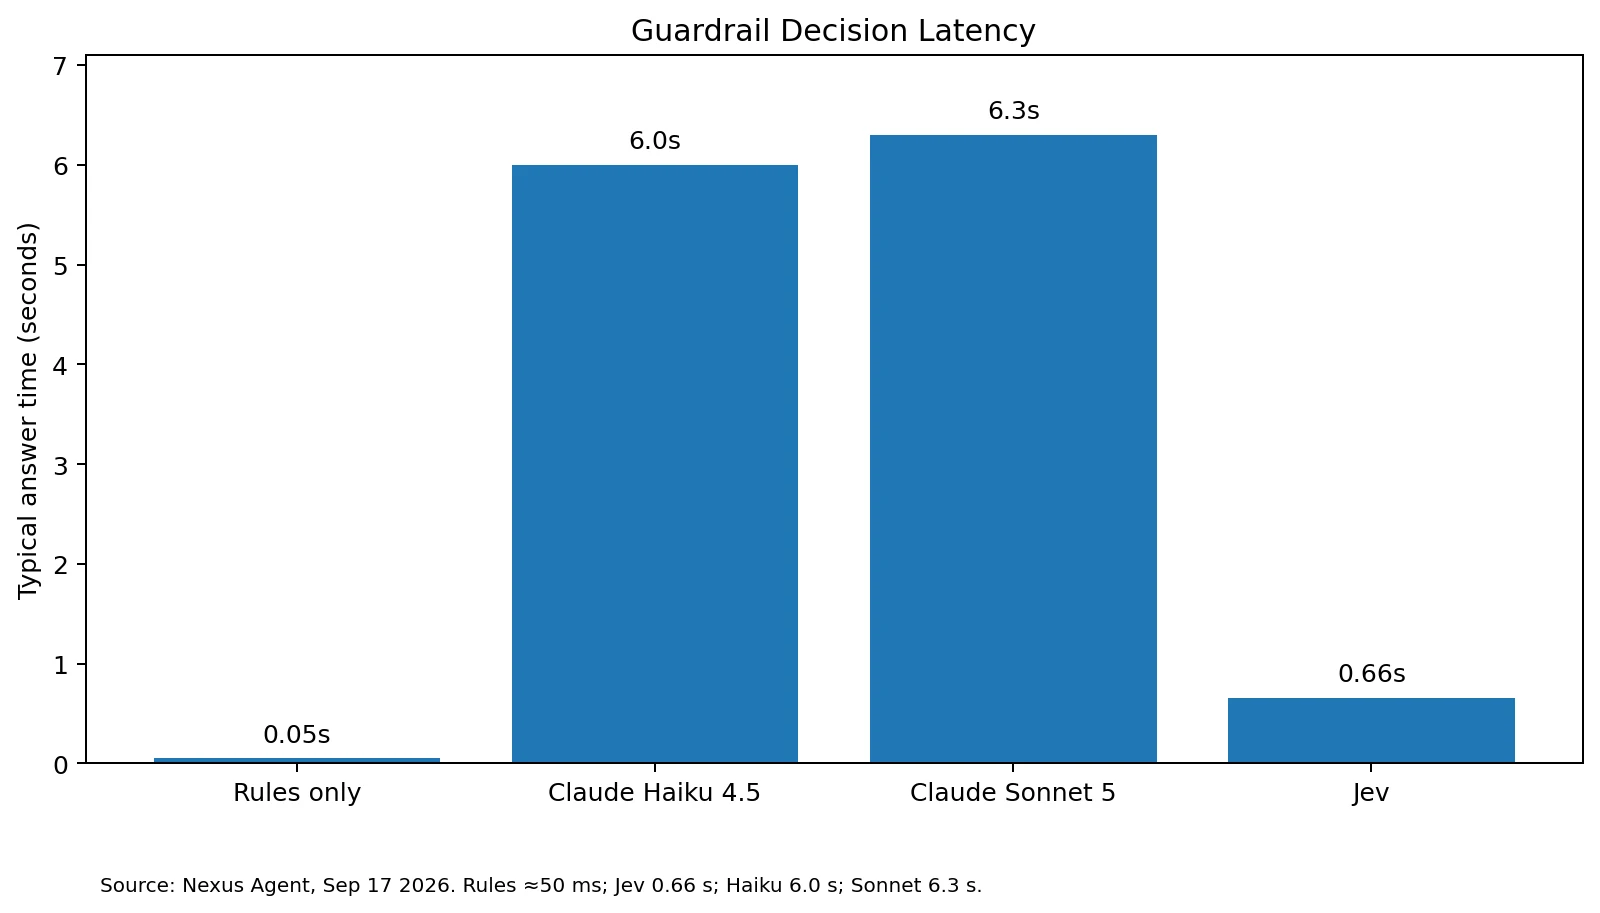
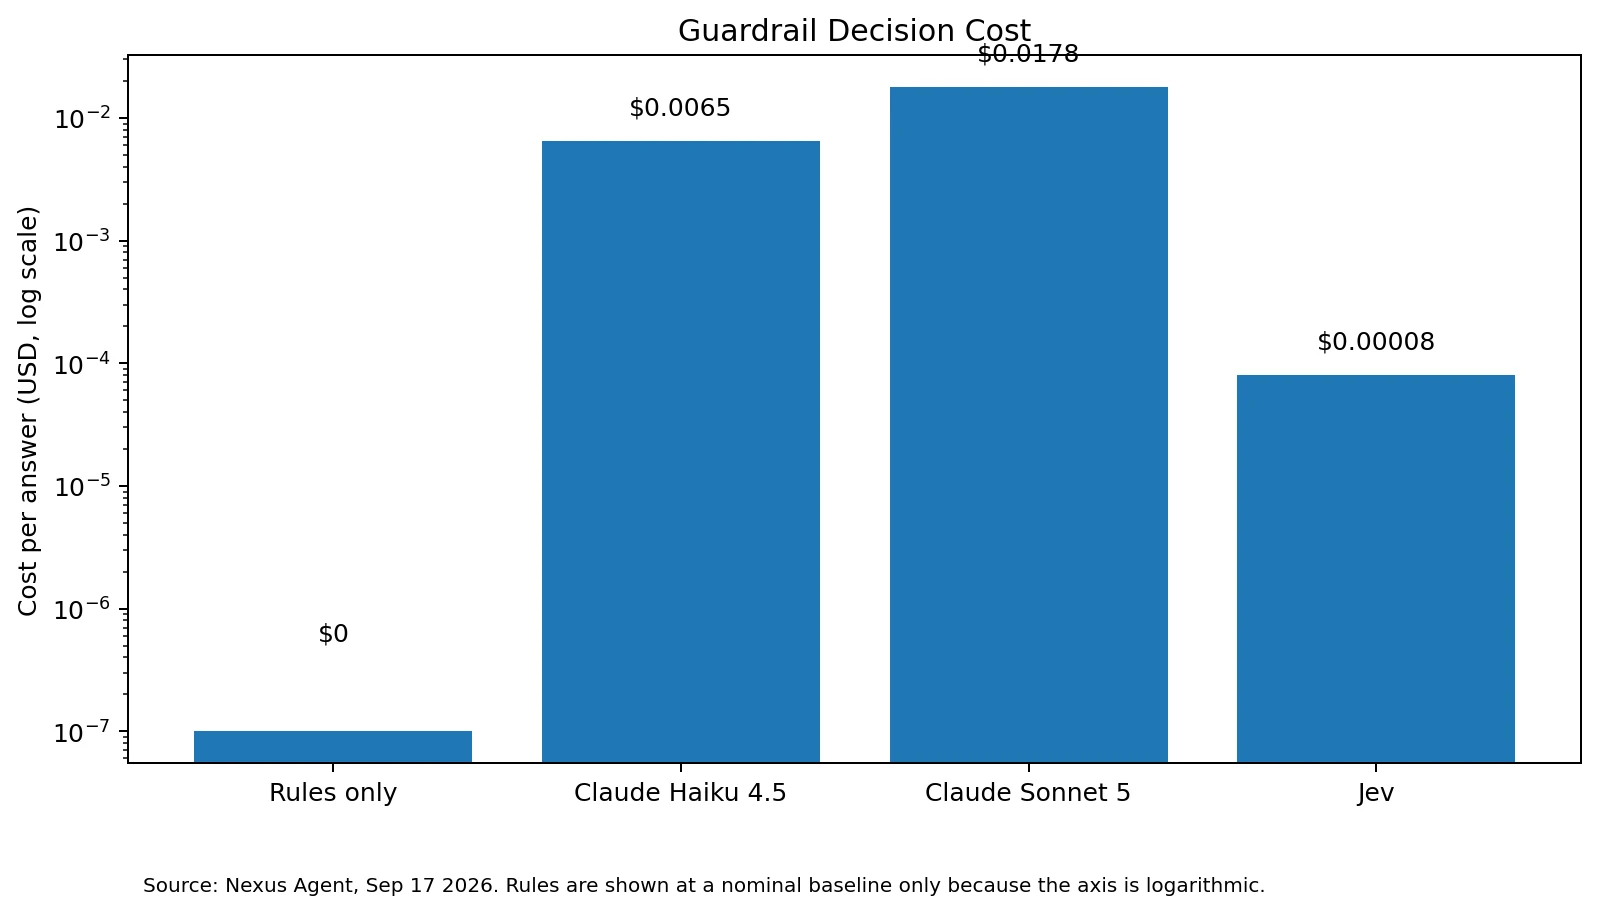
O detalhe essencial é cobertura: 1,8% de erro quando decide não é precisão universal. O padrão útil é responder com confiança e encaminhar incerteza para regras, modelo mais forte ou pessoas. Nexus informa 0,68 segundo de mediana e US$ 0,00008 por decisão.
Onde isso pode importar
Um SOC pode separar sinais benignos, incertos e de alto risco mais cedo. Isso não substitui analistas: reserva raciocínio caro e atenção humana para onde têm valor. Para agentes de IA, uma camada de decisão pode avaliar se a ação é destrutiva, reversível e autorizada antes de a política bloqueá-la ou escalá-la. O mesmo padrão vale para DLP semântico, phishing, IAM, fraude e priorização de vulnerabilidades.
Segurança de tipos não é correção: ALLOW pode ser errado quando BLOCK é necessário. Trate esses modelos como sensores probabilísticos, não como mecanismos infalíveis de política. Baixo impacto e alta confiança podem automatizar; incerteza, alto impacto ou irreversibilidade exigem investigação, controles e autorização.
Jev não substitui raciocínio profundo nem julgamento humano. Pode ser uma camada entre detecção, raciocínio, validação, política e ação. Avaliação editorial: preserve limites determinísticos de autorização, validação independente, fallbacks e revisão humana para ações consequentes.
Fontes





