Qu'est-ce que Deep Code Analysis ? (Et pourquoi SAST + LLM ne suffit pas)
SAST par regex vous donne des milliers de findings théoriques. La revue assistée par LLM vous donne des réécritures confiantes qui ne s'exécutent parfois même pas. Deep Code Analysis est la troisième couche : un modèle structurel de votre code qui prouve quels findings sont réels, atteignables et méritent d'être corrigés.
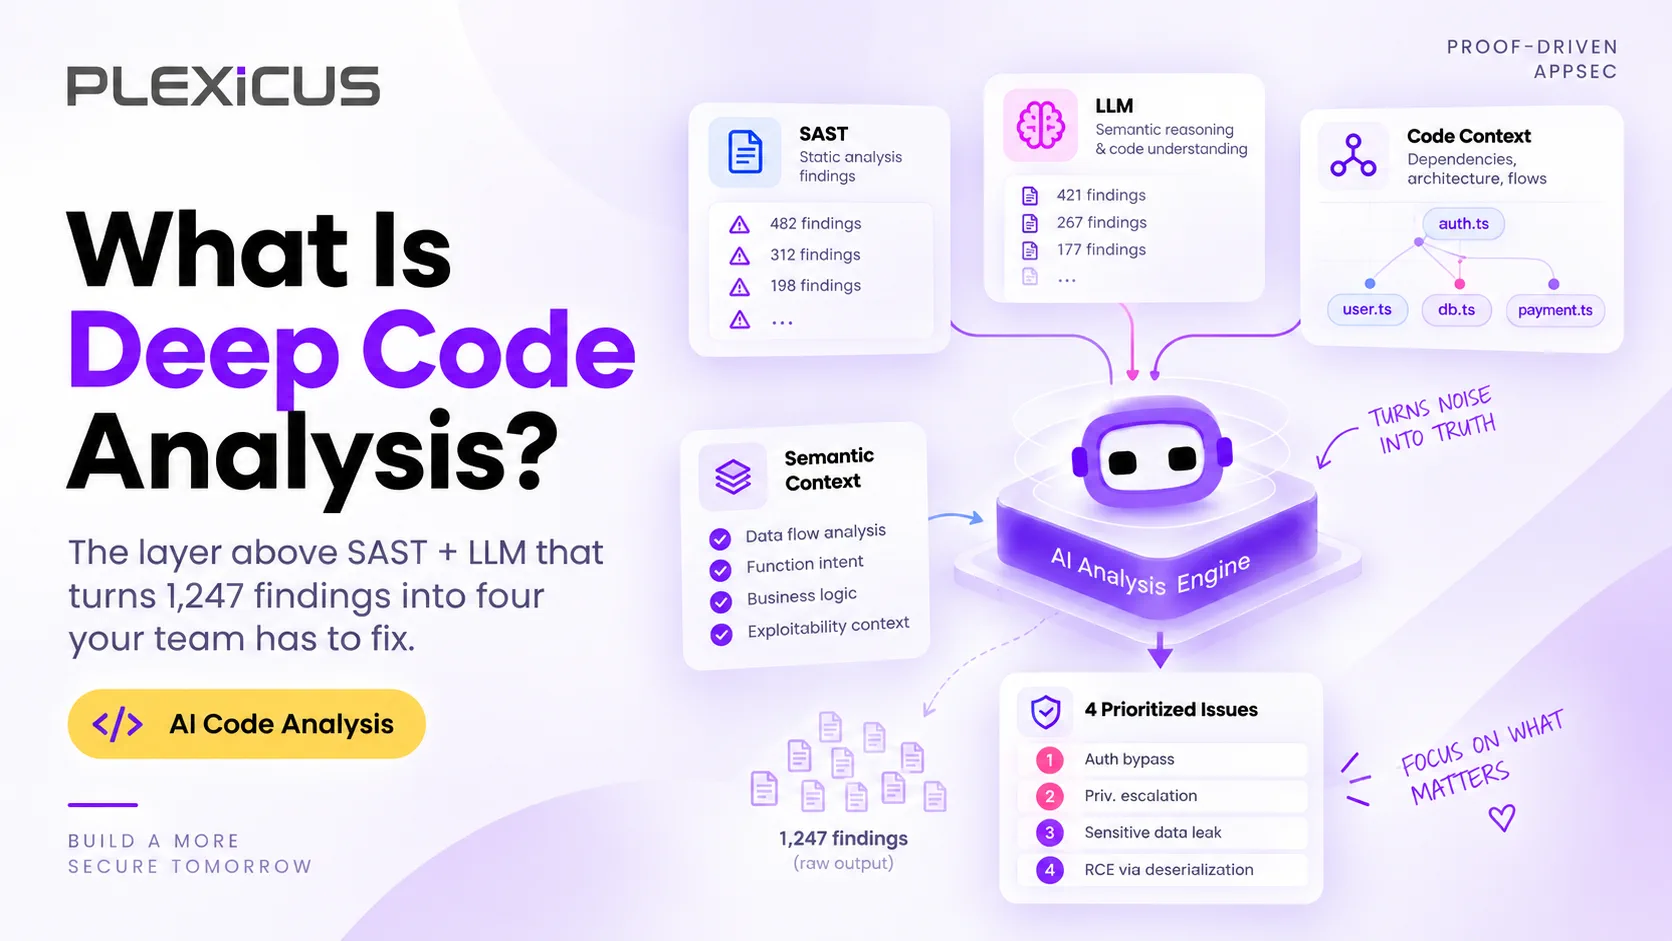
Si vous avez déjà ouvert un tableau de bord SAST, défilé jusqu’en bas d’un CSV de 12 000 lignes et pensé « je ne vais jamais tout trier », vous comprenez déjà le problème que Deep Code Analysis est conçue pour résoudre. Vous comprenez aussi pourquoi greffer un grand modèle de langage sur le même moteur de regex ne le règle pas.
Ce guide explique ce qu’est réellement Deep Code Analysis, pourquoi SAST plus un wrapper LLM vous laisse toujours avec des milliers de findings infixables, et ce qui change quand vous placez une couche structurelle devant vos scanners. Si vous connaissez déjà la différence entre SAST, DAST et SCA, sautez à la section sur la couche au-dessus de tout cela.
La version courte
Deep Code Analysis est la pratique consistant à construire un modèle structurel des hôtes, endpoints, paramètres et capacités de votre application, puis à lier chaque finding de sécurité à un point précis de ce modèle. Un finding sans chemin d’accessibilité, sans classe de capacité et sans numéro de ligne n’est pas un finding. C’est du bruit.
C’est ce qui distingue la pratique du SAST classique et des produits « SAST + LLM » qui ont inondé le marché en 2024–2025. Les deux sont des matchers de patterns sous le capot. L’un utilise des regex. L’autre utilise un transformer qui résume la sortie regex en meilleur anglais.
Aucun des deux ne répond à la seule question qui importe à votre équipe sécurité :
Sur les milliers de vulnérabilités que mon scanner vient de trouver, lesquelles un attaquant peut-il réellement exploiter contre le code de production que nous avons livré mardi dernier ?
Deep Code Analysis répond à cette question. Tout le reste est de la plomberie.
Ce que SAST a raté
SAST — Static Application Security Testing — est le cheval de bataille de la sécurité applicative depuis le début des années 2000. La catégorie a mérité sa place. Mais les moteurs n’ont pas beaucoup changé. La plupart fonctionnent encore ainsi :
- Ils parsent le fichier source.
- Ils appliquent un ensemble d’expressions régulières ou de visiteurs AST qui cherchent des motifs connus comme mauvais (
eval,innerHTML,string.format, identifiants en dur, crypto faible, et quelques centaines d’autres). - Ils émettent un finding avec un score CVSS, un CWE, un chemin de fichier et un numéro de ligne.
Ce modèle a trois problèmes structurels qu’aucune quantité de « wrapper IA améliorée » ne peut dissimuler.
Problème 1 — Les matchers de patterns ne lisent pas le code
Une regex voit eval(input) et le signale. Elle ne voit pas que input est déjà assaini deux fonctions plus haut dans la pile d’appels. Elle ne voit pas que cette branche particulière n’est atteignable que depuis un endpoint de configuration lié à localhost. Elle ne voit pas la clause de garde que votre ingénieur senior a ajoutée il y a six mois.
Le résultat : la plupart des findings SAST sont inatteignables, à faible impact ou déjà mitigés. Les failles intéressantes — autorisation cassée au niveau objet, limites de débit manquantes, un défaut de logique métier dans le nouveau webhook Stripe — sont précisément celles que la regex ne matche pas.
Problème 2 — Il n’y a pas de modèle d’accessibilité
Un finding à la ligne 117 de src/routes/users.js est dénué de sens sans savoir comment l’entrée utilisateur l’atteint, ce qu’elle fait une fois arrivée, et si la route est même exposée.
Le SAST classique s’arrête au site d’appel. Il ne peut pas vous dire :
- Quelle route HTTP sert cette fonction
- Si la route est exposée publiquement ou seulement derrière un VPN
- Si l’authentification s’exécute avant le site d’appel
- Si le paramètre d’entrée est réellement contrôlé par l’utilisateur
- Si le puits de données qu’il atteint (une base, un shell, un fichier) est exploitable depuis ce point d’entrée précis
Vous obtenez un finding. Vous n’obtenez pas un chemin.
Problème 3 — Il n’y a pas de modèle de capacités
Lire un fichier n’est pas obtenir une identité. La portée réseau n’est pas l’exécution de code. Atteindre une requête paramétrée n’est pas atteindre une requête non assainie.
Le SAST classique effondre ces distinctions en un score de sévérité unique. Il traite chaque readFile de la même façon, que le fichier soit un asset statique ou une clé privée. Cela rend la liste de priorités inutile.
Ce que brancher un LLM sur SAST n’a pas corrigé
En 2024, la réponse évidente au bruit de SAST fut d’ajouter un grand modèle de langage. Envelopper le scanner dans un agent. Demander au modèle de résumer le finding, suggérer un patch, ou classer les findings par « exploitabilité réelle ».
Cela a aidé sur un point : le mur de CSV est devenu un mur de résumés lisibles. Cela n’a résolu aucun des trois problèmes structurels ci-dessus. Cela les a juste rendus plus lisibles.
Les limites dures sont toujours là :
- Les LLMs n’exécutent pas le code de manière fiable. Quand un LLM « revoit » un snippet, il fait du pattern-matching sur des tokens. Il n’exécute pas le programme. Il ne peut pas prouver que le snippet est atteignable, seulement qu’il ressemble au type de snippet qui l’est souvent.
- Les LLMs hallucinent les correctifs. Quand on lui demande de patcher une vulnérabilité, un LLM réécrit parfois le site d’appel d’une manière qui compile mais ne correspond plus à la logique métier d’origine. Un relecteur humain doit le détecter. La plupart des équipes ne peuvent pas relire chaque patch suggéré par l’IA.
- Les LLMs héritent des angles morts de SAST. Si le scanner sous-jacent ne voit pas l’autorisation cassée au niveau objet, aucune quantité de résumé post-hoc ne la fera apparaître.
Le résultat de la vague « SAST + LLM » fut un signal plus confiant, plus poli, et toujours sans fondement. L’auditeur ne peut toujours pas ré-exécuter le finding. Le développeur ne sait toujours pas s’il peut faire confiance au patch suggéré. Le CISO reçoit toujours un dashboard plein de coches vertes qui ne signifient rien en production.
C’est ce qui a créé la demande pour Deep Code Analysis en tant que catégorie.
Ce qu’est réellement Deep Code Analysis
Deep Code Analysis part d’un autre point. Au lieu de « scanner le fichier à la recherche de mauvais motifs », la question est « qu’est-ce que cette application, de haut en bas, et qu’est-ce qui peut atteindre quoi ? ».
Concrètement, la pratique a quatre déplacements :
1. Construire un modèle structurel de l’application
La première passe parcourt toute la base de code (et l’IaC qui définit le runtime) et produit un modèle structurel de l’application :
- Hôtes — services, fonctions serverless, APIs tierces
- Endpoints — routes HTTP, méthodes gRPC, gestionnaires de files de messages
- Paramètres — toute entrée qui franchit la limite d’un endpoint
- Capacités — ce que chaque nœud peut lire, écrire, exécuter, exfiltrer, escalader
Le modèle est la source de vérité. Les findings sont des positions à l’intérieur, pas des lignes dans un fichier.
2. Lier chaque finding à un chemin
Quand le moteur propose un finding (que ce soit à partir d’un pattern, d’un modèle appris ou d’une règle écrite par un humain), il doit joindre :
- Le chemin d’accessibilité — endpoint, paramètre, handler, puits
- La classe de capacité — lecture, écriture, impersonation, RCE, exfiltration
- Le numéro de ligne — pour le relecteur humain
Un finding sans les trois est écarté. C’est l’opposé du SAST classique, qui émet un finding dès qu’un motif est matché et laisse la découverte du chemin à l’humain.
3. Vérifier l’accessibilité par une passe indépendante
C’est la différence critique. Le moteur qui propose le finding n’est pas le même que celui qui le confirme. Une seconde passe rejoue l’exploit proposé contre une copie en sandbox de la cible. Seuls les findings qui se reproduisent sont conservés.
C’est la même logique que la méthode scientifique. Une affirmation n’est pas un finding tant qu’elle ne survit pas à un test indépendant.
4. Remettre à l’ingénieur un artefact reproductible
Chaque finding survivant est livré avec une preuve qu’un auditeur peut exécuter, qu’un développeur peut exécuter et qu’une porte CI peut exécuter. Une requête, un script, un état de sandbox.
Si un finding ne peut pas être reproduit, ce n’est pas un finding.
La piste d’audit qu’un auditeur peut vraiment lire
La sortie de Deep Code Analysis est structurée pour les personnes qui doivent défendre le travail en aval. Pour chaque finding, le rapport inclut :
| Champ | Ce qu’il dit à l’auditeur |
|---|---|
| Nœud du graphe | Quel hôte, endpoint, paramètre |
| Chemin d’accessibilité | La chaîne complète de la requête au puits |
| Classe de capacité | Lecture, écriture, impersonation, RCE, exfiltration |
| Vérifié par | Quelle passe indépendante l’a reproduit |
| Référence de preuve | La requête, le job ou l’état de sandbox à ré-exécuter |
| Lignes | Chemin de fichier et numéro de ligne exacts |
| Tainted via | Comment l’entrée utilisateur circule dans le système |
Un auditeur qui lit cela peut ré-exécuter le finding, vérifier la trace, et confirmer la sévérité. Il n’a pas à prendre le fournisseur pour parole.
Pourquoi les outils purement LLM ne peuvent pas rattraper
La tentation est de supposer qu’à mesure que les modèles fondationnels s’améliorent, le wrapper « SAST + LLM » deviendra équivalent à Deep Code Analysis. Il ne le deviendra pas, pour trois raisons :
- Les LLMs ne construisent pas de modèles structurels. Ils les consomment comme entrée. Sans l’étape amont de construction du modèle, le LLM résume du texte plat et invente le chemin entre deux nœuds.
- Les LLMs ne peuvent pas vérifier leurs propres findings. L’étape de vérification exige d’exécuter réellement du code contre la cible. Les LLMs n’exécutent pas le code de manière fiable, et leurs contrôles d’autocohérence sont plus faibles qu’une passe de reproduction indépendante.
- Les LLMs hallucinent la logique métier. Un LLM ne sait pas que
/api/users/:idest censé imposer la propriété de l’enregistrement avant de le renvoyer. Le modèle structurel encode cette contrainte au niveau de l’endpoint. Le modèle de langage ne peut pas l’inférer à partir de statistiques de tokens.
Deep Code Analysis ne remplace pas le LLM. Elle lui donne l’entrée structurée dont il a besoin pour être utile — et elle donne à l’ingénieur la vérité de terrain dont il a besoin pour faire confiance aux suggestions du modèle.
Comment Deep Code Analysis s’associe à AI Swarm Pentest
Chez Plexicus, Deep Code Analysis est la première moitié de la boucle. AI Swarm Pentest est la seconde. Les deux ensemble ressemblent à ceci :
- Deep Code Analysis construit le modèle structurel et propose des findings.
- AI Swarm Pentest sonde chaque finding proposé dans le périmètre convenu.
- Une passe indépendante rejoue l’exploit original contre le patch proposé et exige une preuve.
- Seuls les findings qui survivent aux deux passes — proposer et vérifier — entrent dans le rapport.
Ce qui survit est petit, précis et reproductible. Votre équipe corrige une poignée de choses au lieu d’en trier des milliers. Votre auditeur rejoue une poignée de reproductions au lieu de lire un PDF de 90 pages.
C’est la barre. Tout le reste est du bruit.
La question pratique : est-ce juste du marketing ?
La réponse honnête : il y a un an, c’était en partie du marketing. La catégorie n’avait pas de nom, les produits qui prétendaient le faire enveloppaient des moteurs regex dans des résumés LLM, et la preuve de « profondeur » était un PDF plus long.
En 2026, la pratique a convergé vers quatre signaux opérationnels :
- L’outil peut répondre « est-ce atteignable ? » avec un chemin, pas une supposition. Si votre scanner actuel ne le peut pas, il ne fait pas de Deep Code Analysis.
- L’outil peut répondre « quelle est la classe de capacité ? » avec une vraie taxonomie. Pas CVSS. Pas « haut/moyen/bas ». Une capacité.
- L’outil peut produire un artefact reproductible pour chaque finding survivant. Exécutable par un auditeur, une porte CI et un développeur.
- L’outil associe proposer et vérifier. Ce qui propose le finding n’est pas la même chose que ce qui le confirme.
Si votre stack actuel coche les quatre, vous avez déjà Deep Code Analysis — quel que soit le nom que lui donne le fournisseur. S’il en coche trois, vous êtes proche. S’il en coche deux ou moins, vous avez un dashboard SAST avec un meilleur copy.
Par où commencer
Si vous voulez voir la différence, vous n’avez pas besoin d’une évaluation de six mois. Choisissez un dépôt, une branche, un build proche de la production. Lancez votre scanner actuel. Comptez les findings. Lancez ensuite une passe de Deep Code Analysis sur la même cible. Comptez les findings qui survivent à la reproduction indépendante.
L’écart entre ces deux nombres, c’est le budget que vous avez dépensé en triage qui n’avait pas besoin d’arriver.
Lectures associées :
- Deep Code Analysis — page produit complète
- 78 % des PR générées par IA contiennent une vulnérabilité — à quoi ressemble le taux d’échec réel en production
- Le playbook de remédiation autonome — ce qui se passe après qu’un finding survit à la reproduction