De l'alerte au correctif : fermer la boucle avec l'AppSec pilotée par les preuves
La plupart des programmes de sécurité sont une série de boucles déconnectées — alerte, tri, correctif, audit, nouveau correctif, nouvel audit. L'AppSec pilotée par les preuves ferme la boucle une fois et rend chaque étape démontrable. Voici la définition canonique, la structure à quatre boucles et ce que cela donne en production.
La plupart des programmes d’AppSec se ressemblent. Un scanner trouve une vulnérabilité. Le résultat atterrit dans une file. Un humain le trie, à un moment. Un ticket s’ouvre. Un développeur prend le ticket, quand il peut. Le développeur ouvre une PR. La PR reste en revue. La revue prend une semaine parce que le diff est volumineux et que le développeur est le seul à comprendre le fichier. La PR est mergée. La porte CI passe. Le résultat est clos.
Pendant ce temps, les attaquants exécutent une exploitation automatisée à quelques centimes par tentative et compromettent un nouvel appareil toutes les quelques minutes. La médiane de plusieurs semaines pour corriger n’est pas une métrique de sécurité. C’est un argument commercial pour les attaquants.
L’AppSec pilotée par les preuves est la discipline opérationnelle qui ferme la boucle une fois, rend chaque étape démontrable et fait passer la médiane de correction de plusieurs semaines à quelques jours. Voici la définition canonique.
Ce qu’est l’AppSec pilotée par les preuves
L’AppSec pilotée par les preuves est la discipline qui consiste à exécuter des programmes de sécurité applicative où chaque affirmation s’appuie sur une preuve qu’un auditeur, un développeur ou une porte CI peut ré-exécuter. Pas de scores CVSS. Pas d’étiquettes de sévérité. Pas de « haut/moyen/bas ». Un artefact reproductible joint au résultat.
Trois propriétés définissent la pratique :
- Chaque résultat a un chemin. Pas une correspondance regex. Pas un match de motif. Un chemin d’accessibilité depuis une source d’entrée réelle jusqu’à un puits portant une capacité réelle, lié à un fichier et un numéro de ligne précis.
- Chaque résultat a une preuve. Une requête qu’on peut ré-exécuter, un job CI qu’on peut rejouer, un état de bac à sable qu’on peut reprendre. Si un résultat ne peut pas être reproduit, ce n’est pas un résultat — c’est une hypothèse.
- Chaque correctif a une chaîne de preuves. Le patch vient du même résultat. Le patch ferme l’exploit initial. Le patch a été revu avec la preuve initiale jointe. Le test de régression du patch est l’exploit initial, inversé.
C’est cela la pratique. Tout ce qui ne coche pas les trois est une capture d’écran d’un programme d’AppSec, pas un programme d’AppSec.
La structure à quatre boucles
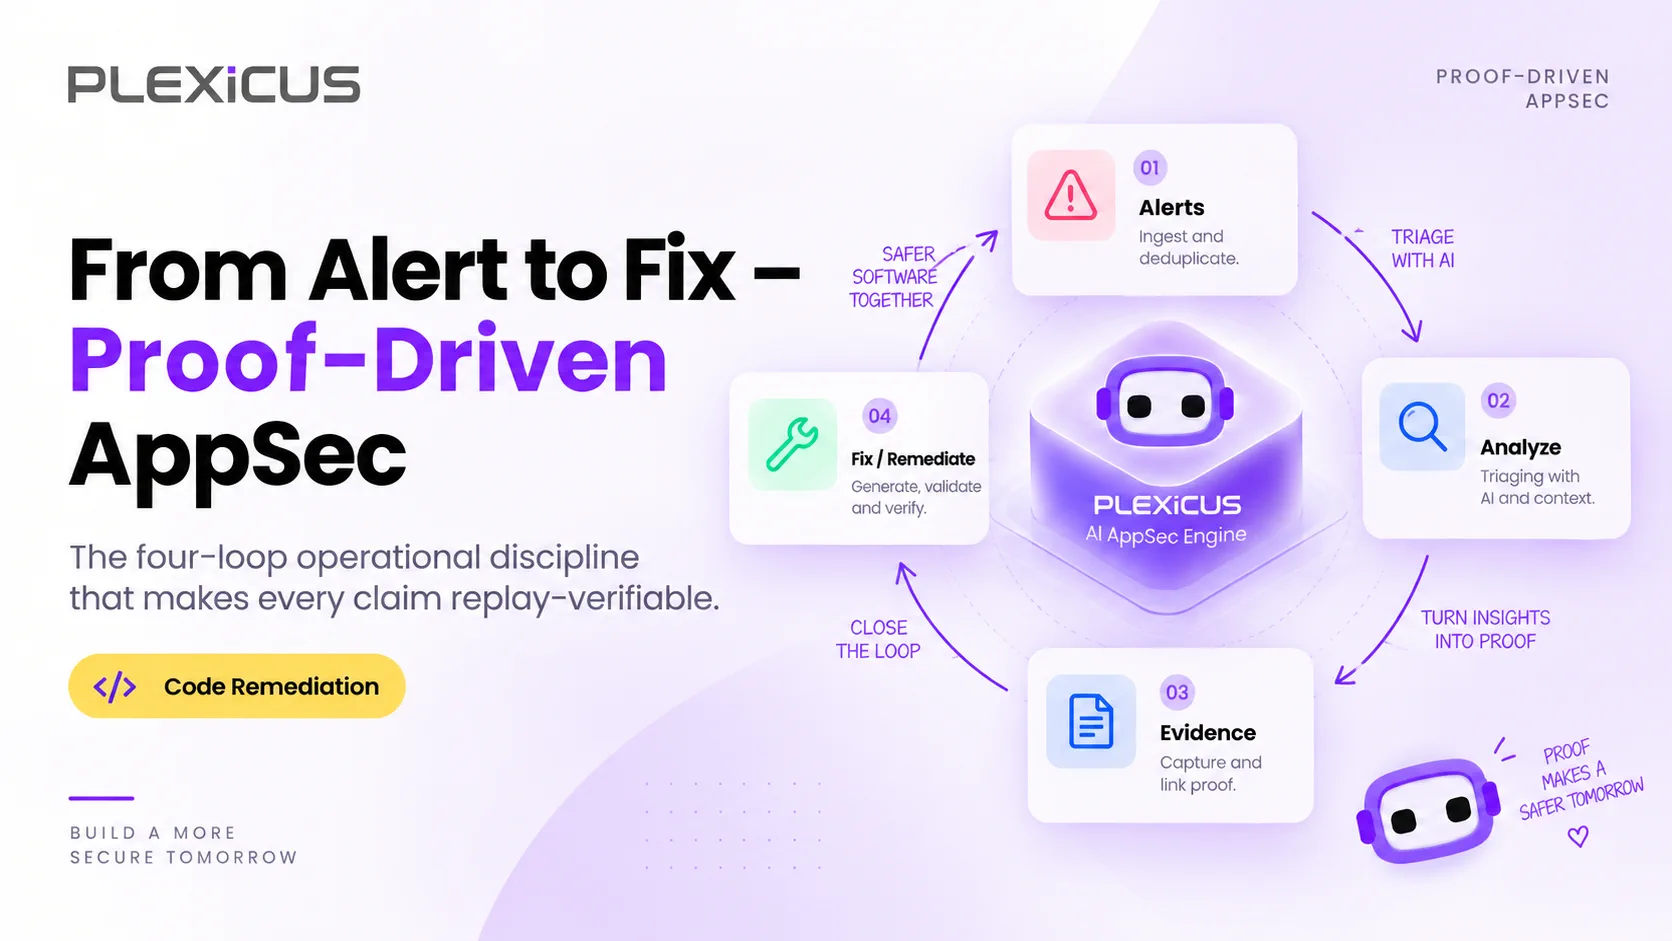
Le schéma opérationnel comporte quatre boucles. Chaque boucle a un travail. Chaque transfert préserve la preuve.
Boucle 1 — Détecter
La première passe scanne la base de code (et l’IaC qui définit le runtime) et produit un graphe d’hôtes, d’endpoints, de paramètres et de capacités. Les résultats sont des positions dans le graphe, pas des lignes dans un fichier.
C’est ce que fait Deep Code Analysis. La sortie est un ensemble de résultats proposés, chacun lié à un nœud du graphe, un chemin d’accessibilité, une classe de capacité et un numéro de ligne.
Boucle 2 — Vérifier
La deuxième passe prend chaque résultat proposé et tente de le reproduire. L’agent qui effectue cette passe n’est pas l’agent qui a proposé le résultat. C’est l’étape critique. L’autocohérence n’est pas une vérification.
La sortie de la Boucle 2 est un ensemble plus restreint de résultats vérifiés, chacun accompagné de sa preuve. Les résultats qui ne se reproduisent pas sont écartés avec un motif documenté. Les codes de motif comptent — c’est ainsi que votre équipe débogue le pipeline plus tard. Les motifs courants : pas de chemin réel d’un endpoint public vers le puits, un contrôle en amont qui rend le résultat inerte, un contrôle runtime qui le neutralise, ou le deuxième agent n’a pas pu reproduire le résultat.
Boucle 3 — Corriger
La troisième passe prend chaque résultat vérifié et rédige un patch prêt à être revu. Le patch n’est pas un correctif générique. C’est le changement minimum qui supprime le chemin d’accessibilité tout en préservant la logique métier. Le patch inclut des tests de régression (l’exploit initial devient un test). Le patch inclut les mises à jour de la documentation.
C’est ce que fait un flux de remédiation structuré. La sortie est une pull request, pas un snippet de code.
Boucle 4 — Auditer
La quatrième passe s’assure que le patch ferme le résultat initial. Le vérificateur ré-exécute l’exploit initial contre la branche patchée. Si l’exploit se reproduit, le patch est annulé. Si l’exploit est mitigé, le patch est signé et le résultat est clos.
La sortie de la Boucle 4 est un enregistrement d’audit : résultat initial, nœud du graphe, référence à la preuve, diff du patch, résultat du test de régression, approbation du relecteur, horodatage du déploiement. Un enregistrement par résultat. Signé. Rejouable.
Pourquoi ce n’est pas de l’« AppSec native IA » avec un meilleur marketing
Le terme « AppSec native IA » était utile lorsqu’il signifiait « les scanners utilisent des modèles de machine learning ». Aujourd’hui, tous les scanners utilisent des modèles de machine learning. Le différenciateur n’est pas de savoir si l’IA est impliquée. C’est de savoir si l’IA est fondée.
Trois modes d’échec de l’ère native IA :
- IA qui résume les résultats sans les fonder. Le modèle lit la sortie SAST et produit un PDF plus lisible. L’auditeur ne peut toujours rien ré-exécuter.
- IA qui propose des correctifs sans vérification. Le modèle écrit un patch. Le patch compile. Le patch change le sens du code. Un relecteur humain est censé s’en apercevoir. Il ne peut pas, à l’échelle.
- IA qui tourne sans preuve. Le modèle explore l’application. Il trouve quelque chose d’intéressant. Il le signale comme un résultat. Le rapport n’est pas reproductible.
L’AppSec pilotée par les preuves est la réponse aux trois. La structure est la barre :
- La détection doit produire un chemin, pas un motif.
- La vérification doit être indépendante, pas autocohérente.
- Le correctif doit s’appuyer sur la même preuve, pas sur une suggestion générique.
- L’audit doit être rejouable, pas narratif.
Tout ce qui ne coche pas les quatre est le même programme d’AppSec avec un logo différent.
La boucle opérationnelle en pratique
Sur la base de clients Plexicus qui exécutent le schéma complet à quatre boucles, l’effet pratique a la même forme : le temps de triage se compresse de quelques jours à quelques minutes, les faux positifs diminuent après la vérification, et le délai jusqu’au merge baisse parce que le relecteur lit un diff petit et étayé par des preuves au lieu d’une liste non vérifiée.
Deux chiffres définissent si la pratique fonctionne : à quelle fréquence l’auditeur peut ré-exécuter la preuve et confirmer le résultat, et à quelle fréquence l’auditeur accepte que le patch corrige ce que le résultat affirmait. Tout le reste n’est que débit.
Les médianes exactes varient selon la base de code, le mix de langages et la maturité du CI. C’est le schéma qui scale.
Ce qu’exige le paysage des menaces
Le paysage des menaces en 2026 est structurellement plus rapide que le cycle du défenseur :
- Le time-to-exploit des vulnérabilités nouvellement publiées s’est compressé de plusieurs années à quelques heures. Sous la journée est désormais la norme pour les cibles à forte visibilité.
- L’arsenal offensif open-source dopé à l’IA s’est multiplié. La montée la plus rapide d’une classe d’outils dans l’histoire de la sécurité offensive.
- Des équipes de ransomware opérées par une seule personne ont compromis des centaines d’appareils dans des dizaines de pays lors d’une seule campagne.
- Une part significative des vulnérabilités exploitées étaient actives avant la publication d’un CVE.
Le pipeline de l’attaquant est déjà piloté par les preuves. Il vérifie ses exploits avant de les envoyer. Il rejoue ses payloads. Il audite ses résultats. L’asymétrie n’est pas « les attaquants utilisent l’IA et les défenseurs non ». L’asymétrie est « les attaquants utilisent une boucle fermée et les défenseurs une série de files ouvertes ».
L’AppSec pilotée par les preuves est le schéma opérationnel qui ferme la boucle du défenseur.
À quoi cela ressemble pour une vraie équipe d’ingénierie
La structure à quatre boucles n’est pas spécifique à un éditeur. Le schéma peut être implémenté avec les outils que votre équipe a déjà :
- Boucle 1 (Détecter) — analyse statique qui produit des chemins d’accessibilité. Plexicus Deep Code Analysis, ou tout scanner qui lie les résultats au graphe d’appels plutôt qu’au numéro de ligne.
- Boucle 2 (Vérifier) — un engagement de pentest au périmètre signé. Plexicus AI Swarm Pentest, ou un engagement de pentest manuel avec capture de preuves.
- Boucle 3 (Corriger) — un générateur de patchs avec tests de régression. Tout workflow de code avec IA assorti d’instructions explicites de fonder les patchs sur le résultat initial.
- Boucle 4 (Auditer) — un hook CI de re-test qui exécute l’exploit initial contre la branche patchée.
Les quatre boucles doivent être câblées ensemble. La preuve de la Boucle 2 doit atterrir dans la Boucle 3. Le patch de la Boucle 3 doit être re-vérifié par la Boucle 2. L’enregistrement d’audit de la Boucle 4 doit inclure les références de preuves des Boucles 1, 2 et 3.
Si l’un de ces transferts perd la preuve, la boucle est cassée. La pratique cesse d’être pilotée par les preuves.
La barre pour 2026
Trois questions à poser à votre programme de sécurité :
- Votre scanner peut-il produire un chemin d’accessibilité pour chaque résultat ? Si la réponse est « non, juste un numéro de ligne », votre file de triage continuera à grossir.
- Votre pentester peut-il ré-exécuter le résultat sur un build propre ? Si la réponse est « il faudrait monter un nouvel engagement », votre piste de preuve n’est pas reproductible.
- Votre développeur peut-il ouvrir la PR avec l’exploit initial joint ? Si la réponse est « il devrait redemander à l’équipe sécurité de le retrouver », votre piste d’audit n’est pas continue.
Si les trois réponses sont « oui », vous exécutez de l’AppSec pilotée par les preuves. Si l’une d’elles est « non » ou « à peu près », la faille est dans le transfert de preuves, pas dans l’outillage.
Où cela mène
Dans les deux prochaines années, chaque régulateur posera la même question : pouvez-vous ré-exécuter la preuve qui démontrait que ce contrôle fonctionnait au moment de l’incident ? Les équipes qui exécutent l’AppSec pilotée par les preuves répondront « oui » avec l’artefact original. Les équipes avec l’ancien schéma répondront « nous avons un PDF ».
L’investissement pour fermer l’écart n’est pas élevé. La discipline pour le maintenir fermé l’est.
Lectures associées :
- Qu’est-ce que Deep Code Analysis ? — Boucle 1
- 78 % des PR générées par IA contiennent une vulnérabilité — pourquoi la vérification est le nouveau goulot d’étranglement
- Le playbook de remédiation autonome — Boucle 3 en détail
- Guide terrain OWASP MAESTRO pour modélisateurs de menaces — l’architecture de référence pour les agents qui exécutent les boucles