O que é Deep Code Analysis? (E por que SAST + LLM não é suficiente)
SAST por regex dá milhares de achados teóricos. A revisão assistida por LLM dá reescritas confiantes que às vezes nem sequer compilam. Deep Code Analysis é a terceira camada: um modelo estrutural do seu código que prova quais achados são reais, alcançáveis e valem a pena corrigir.
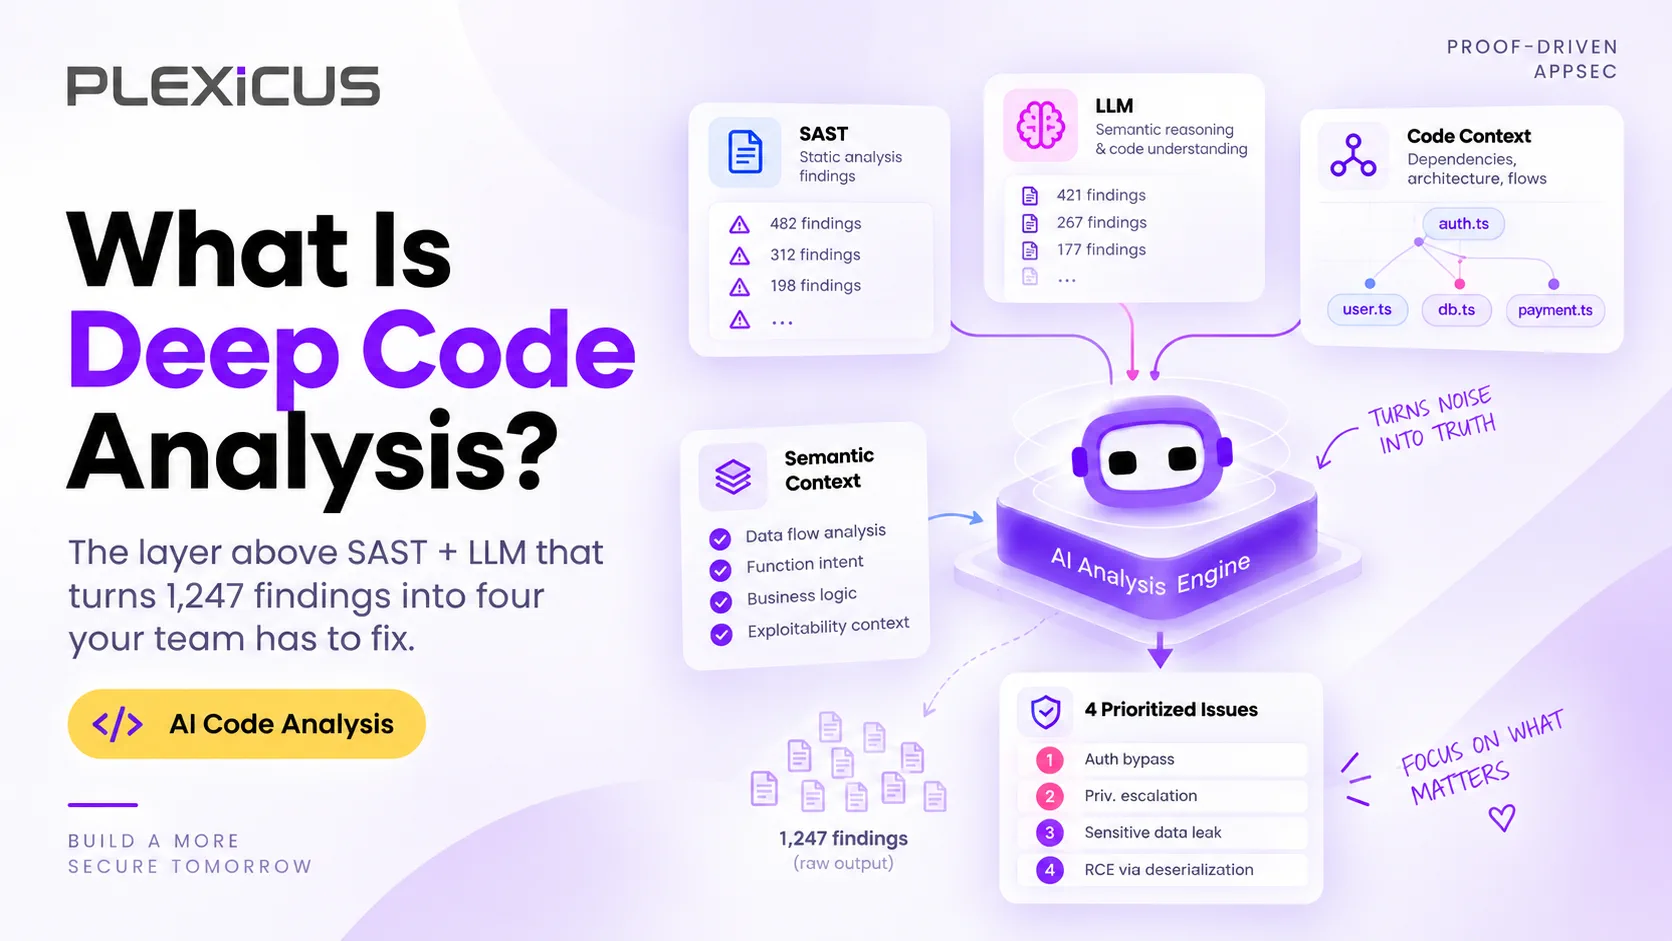
Se você já abriu um painel de SAST, rolou até o fim de um CSV de 12 000 linhas e pensou “nunca vou triar tudo isso”, você já entende o problema que Deep Code Analysis foi criada para resolver. Você também entende por que plugar um modelo de linguagem grande no mesmo motor de regex não resolve.
Este guia explica o que Deep Code Analysis realmente é, por que SAST mais um wrapper de LLM ainda deixa você com milhares de achados incorrigíveis e o que muda quando você coloca uma camada estrutural na frente dos seus scanners. Se você já conhece a diferença entre SAST, DAST e SCA, pule para a seção sobre como é a camada acima de todos.
A versão curta
Deep Code Analysis é a prática de construir um modelo estrutural dos hosts, endpoints, parâmetros e capacidades da sua aplicação e, em seguida, vincular cada achado de segurança a um ponto específico desse modelo. Um achado sem caminho de alcançabilidade, classe de capacidade e número de linha não é um achado. É ruído.
Isso é o que separa a prática do SAST tradicional e dos produtos “SAST + LLM” que inundaram o mercado em 2024–2025. Os dois são combinadores de padrões por baixo. Um usa regex. O outro usa um transformer que resume a saída do regex em inglês melhor.
Nenhum dos dois responde à única pergunta que importa para o seu time de segurança:
Dos milhares de vulnerabilidades que meu scanner acabou de encontrar, quais um atacante consegue realmente explorar contra o código de produção que entregamos na terça passada?
Deep Code Analysis responde essa pergunta. Todo o resto é encanamento.
O que o SAST fez de errado
SAST — Static Application Security Testing — é o cavalo de batalha da segurança de aplicações desde o início dos anos 2000. A categoria ganhou seu lugar. Mas os motores não mudaram muito. A maioria ainda funciona assim:
- Parseia o arquivo de código.
- Aplica um conjunto de expressões regulares ou visitantes de AST que procuram padrões conhecidos como ruins (
eval,innerHTML,string.format, credenciais hardcoded, criptografia fraca e algumas centenas de outros). - Emite um achado com uma pontuação CVSS, um CWE, um caminho de arquivo e um número de linha.
Esse modelo tem três problemas estruturais que nenhuma quantidade de “IA melhorada” consegue disfarçar.
Problema 1 — Combinadores de padrão não leem código
Um regex vê eval(input) e marca. Não vê que input já está saneado duas funções acima na pilha de chamadas. Não vê que esse ramo específico só é alcançável a partir de um endpoint de configuração atrelado a localhost. Não vê a cláusula de guarda que seu engenheiro sênior adicionou seis meses atrás.
O resultado: a maioria dos achados de SAST são inalcançáveis, de baixo impacto ou já mitigados. As falhas interessantes — autorização quebrada em nível de objeto, limites de taxa ausentes, um defeito de lógica de negócio no novo webhook do Stripe — são exatamente as que o regex não casa.
Problema 2 — Não há modelo de alcançabilidade
Um achado na linha 117 de src/routes/users.js não significa nada sem saber como a entrada do usuário chega até ele, o que ela faz uma vez lá e se a rota sequer está exposta.
O SAST tradicional para no call site. Ele não consegue te dizer:
- Qual rota HTTP serve essa função
- Se a rota está exposta publicamente ou só atrás de uma VPN
- Se a autenticação roda antes do call site
- Se o parâmetro de entrada é realmente controlado pelo usuário
- Se o sink de dados que ele alcança (um banco, um shell, um arquivo) é explorável a partir desse ponto de entrada específico
Você recebe um achado. Você não recebe um caminho.
Problema 3 — Não há modelo de capacidades
Ler um arquivo não é o mesmo que obter uma identidade. Alcance de rede não é execução de código. Alcançar uma query parametrizada não é alcançar uma não saneada.
O SAST tradicional colapsa essas distinções em um único score de severidade. Trata todo readFile da mesma forma, independentemente de o arquivo ser um asset estático ou uma chave privada. Isso torna a lista de prioridade inútil.
O que plugar um LLM no SAST não consertou
Em 2024, a resposta óbvia ao ruído de SAST foi adicionar um modelo de linguagem grande. Embrulhar o scanner num agente. Pedir ao modelo que resumisse o achado, sugerisse um patch ou classificasse os achados por “explotabilidade real”.
Isso ajudou em uma coisa: o muro de CSV virou um muro de resumos legíveis. Não resolveu nenhum dos três problemas estruturais acima. Só os tornou mais legíveis.
Os limites duros continuam lá:
- LLMs não executam código de forma confiável. Quando um LLM “revisa” um snippet, ele faz pattern-matching em tokens. Não executa o programa. Não consegue provar que o snippet é alcançável, apenas que parece com o tipo de snippet que costuma ser.
- LLMs alucinam as correções. Quando pedido para corrigir uma vulnerabilidade, um LLM às vezes reescreve o call site de um jeito que compila, mas que não bate mais com a lógica de negócio original. Um revisor humano precisa pegar isso. A maioria dos times não consegue revisar cada patch sugerido por IA.
- LLMs herdam os pontos cegos do SAST. Se o scanner subjacente não enxerga a autorização quebrada em nível de objeto, nenhuma quantidade de sumarização posterior vai produzi-la.
O resultado da onda “SAST + LLM” foi um sinal mais convincente, mais polido e ainda sem fundamento. O auditor continua sem poder re-executar o achado. O desenvolvedor continua sem saber se pode confiar no patch sugerido. O CISO continua recebendo um painel cheio de checks verdes que não significam nada em produção.
Isso foi o que criou a demanda por Deep Code Analysis como categoria.
O que Deep Code Analysis realmente é
Deep Code Analysis parte de outro ponto. Em vez de “escaneie o arquivo atrás de padrões ruins”, a pergunta é “o que é essa aplicação, de cima a baixo, e o que consegue alcançar o quê?”.
Concretamente, a prática tem quatro deslocamentos:
1. Construir um modelo estrutural da aplicação
A primeira passada percorre toda a base de código (e o IaC que define o runtime) e produz um modelo estrutural da aplicação:
- Hosts — serviços, funções serverless, APIs de terceiros
- Endpoints — rotas HTTP, métodos gRPC, handlers de filas de mensagem
- Parâmetros — cada entrada que cruza a fronteira de um endpoint
- Capacidades — o que cada nó consegue ler, escrever, executar, exfiltrar, escalar
O modelo é a fonte da verdade. Achados são posições dentro dele, não linhas em um arquivo.
2. Vincular cada achado a um caminho
Quando o motor propõe um achado (seja a partir de um padrão, de um modelo aprendido ou de uma regra escrita por humanos), ele precisa anexar:
- O caminho de alcançabilidade — endpoint, parâmetro, handler, sink
- A classe de capacidade — leitura, escrita, impersonation, RCE, exfiltração
- O número de linha — para o revisor humano
Um achado sem os três é descartado. Isso é o oposto do SAST tradicional, que emite um achado sempre que casa um padrão e deixa a descoberta do caminho para o humano.
3. Verificar a alcançabilidade com uma passada independente
Essa é a diferença crítica. O motor que propõe o achado não é o mesmo que o confirma. Uma segunda passada reproduz o exploit proposto contra uma cópia em sandbox do alvo. Só os achados que se reproduzem ficam.
É a mesma lógica do método científico. Uma afirmação não é um achado até sobreviver a um teste independente.
4. Entregar ao engenheiro um artefato reproduzível
Cada achado sobrevivente vem com evidência que um auditor pode rodar, um desenvolvedor pode rodar e um gate de CI pode rodar. Uma requisição, um script, um estado de sandbox.
Se um achado não pode ser reproduzido, não é um achado.
A trilha de auditoria que um auditor realmente consegue ler
A saída de Deep Code Analysis é estruturada para as pessoas que precisam defender o trabalho adiante. Para cada achado, o relatório inclui:
| Campo | O que ele diz ao auditor |
|---|---|
| Nó do grafo | Qual host, endpoint, parâmetro |
| Caminho de alcançabilidade | A cadeia completa da requisição ao sink |
| Classe de capacidade | Leitura, escrita, impersonation, RCE, exfiltração |
| Verificado por | Qual passada independente o reproduziu |
| Referência de evidência | A requisição, o job ou o estado de sandbox para re-executar |
| Linhas | Caminho de arquivo e número de linha exatos |
| Tainted via | Como a entrada do usuário flui pelo sistema |
Um auditor lendo isso consegue re-executar o achado, conferir a trace e confirmar a severidade. Não precisa acreditar na palavra do fornecedor.
Por que as ferramentas só-LLM não conseguem acompanhar
A tentação é assumir que, conforme os modelos fundação melhoram, o wrapper “SAST + LLM” vai virar equivalente a Deep Code Analysis. Não vai, por três razões:
- LLMs não constroem modelos estruturais. Eles os consomem como entrada. Sem o passo anterior de construção do modelo, o LLM está resumindo texto plano e inventando o caminho entre dois nós.
- LLMs não conseguem verificar seus próprios achados. O passo de verificação exige rodar código de verdade contra o alvo. LLMs não rodam código de forma confiável, e suas checagens de autoconsistência são mais fracas que uma passada de reprodução independente.
- LLMs alucinam a lógica de negócio. Um LLM não sabe que
/api/users/:idé para impor propriedade do registro antes de devolvê-lo. O modelo estrutural codifica essa restrição a nível de endpoint. O modelo de linguagem não consegue inferi-la a partir de estatísticas de tokens.
Deep Code Analysis não substitui o LLM. Dá ao LLM a entrada estruturada que ele precisa para ser útil — e dá ao engenheiro a verdade fundamental que ele precisa para confiar nas sugestões do modelo.
Como Deep Code Analysis se combina com AI Swarm Pentest
Na Plexicus, Deep Code Analysis é a primeira metade do ciclo. AI Swarm Pentest é a segunda. Os dois juntos se parecem com isto:
- Deep Code Analysis constrói o modelo estrutural e propõe achados.
- AI Swarm Pentest sonda cada achado proposto dentro do escopo acordado.
- Uma passada independente reproduz o exploit original contra o patch proposto e exige evidência.
- Só entram no relatório os achados que sobrevivem às duas passadas — propor e verificar.
O que sobrevive é pequeno, preciso e reproduzível. Seu time corrige um punhado de coisas em vez de triar milhares. Seu auditor re-executa um punhado de reproduções em vez de ler um PDF de 90 páginas.
Esse é o padrão. Todo o resto é ruído.
A pergunta prática: é só marketing?
A resposta honesta: um ano atrás, era em parte marketing. A categoria não tinha nome, os produtos que diziam fazer isso estavam embrulhando motores de regex em resumos de LLM, e a prova de “profundidade” era um PDF mais longo.
Em 2026, a prática convergiu em quatro sinais operacionais:
- A ferramenta consegue responder “isso é alcançável?” com um caminho, não com um palpite. Se o seu scanner atual não consegue, ele não está fazendo Deep Code Analysis.
- A ferramenta consegue responder “qual é a classe de capacidade?” com uma taxonomia real. Não CVSS. Não “alto/médio/baixo”. Uma capacidade.
- A ferramenta consegue produzir um artefato reproduzível para cada achado sobrevivente. Executável por um auditor, um gate de CI e um desenvolvedor.
- A ferramenta combina propor e verificar. Quem propõe o achado não é a mesma coisa que o confirma.
Se o seu stack atual atende os quatro, você já tem Deep Code Analysis — chame como o fornecedor chamar. Se atende três, você está perto. Se atende dois ou menos, você tem um painel de SAST com copy melhor.
Por onde começar
Se você quer ver a diferença, não precisa de uma avaliação de seis meses. Escolha um repositório, uma branch, um build parecido com produção. Rode o seu scanner atual. Conte os achados. Depois rode uma passada de Deep Code Analysis no mesmo alvo. Conte os achados que sobrevivem à reprodução independente.
A distância entre esses dois números é o orçamento que você vem gastando em triagem que não precisava acontecer.
Leitura relacionada:
- Deep Code Analysis — página completa do produto
- 78% dos PRs gerados por IA contêm uma vulnerabilidade — como é a taxa real de falha em produção
- O playbook de remediação autônoma — o que acontece depois que um achado sobrevive à reprodução