Jev ne discute pas. Il décide. Pourquoi cela compte pour la cybersécurité.
Jev produit des décisions typées plutôt que de la prose. Cette approche peut placer le jugement sémantique dans les flux de sécurité, avec politique, repli, vérification et revue humaine.

La course à l’IA a longtemps demandé quel modèle écrit la meilleure réponse. TypeSafe pose une autre question : que se passe-t-il si le logiciel a besoin d’une décision, pas d’un texte ? Jev, lancé le 15 septembre 2026, reçoit un contexte et des questions définies à l’avance puis renvoie des choix, scores ou probabilités typés.
De la génération à la décision
Un LLM peut expliquer une alerte ; un système a souvent besoin de risque = critique, action = contenir, confiance = 0,97. Jev évite l’étape de prose : l’application définit les sorties et le modèle fournit les probabilités. Son intégration Vercel AI Gateway décrit des décisions Choice, Score et Boolean évaluées en parallèle.
L’évaluation Security Incidents de TypeSafe réunit alerte, actif, propriétaire, tickets, appareils, maintenance et autorisations. Elle estime activité non autorisée, explication disponible et force des preuves, puis peut examiner sessions, identifiants, processus, réseau et propagation avant de notifier, escalader, tuer un processus ou désactiver un compte. Le modèle estime ; la politique de sécurité applique.
Ce que disent les premières mesures
Les chiffres les plus spectaculaires de TypeSafe restent des résultats fournisseur ; l’entreprise reconnaît que ses plus grands gains représentent le haut de la plage réelle. L’étude de Nexus Agent fournit une preuve externe précoce : 19 118 moments réels, 36 218 appels, puis 469 cas de guardrails. Jev décide 58% des cas et totalise 90 erreurs avec repli sur les règles, contre 148 pour les règles, 99 pour Haiku et 92 pour Sonnet.
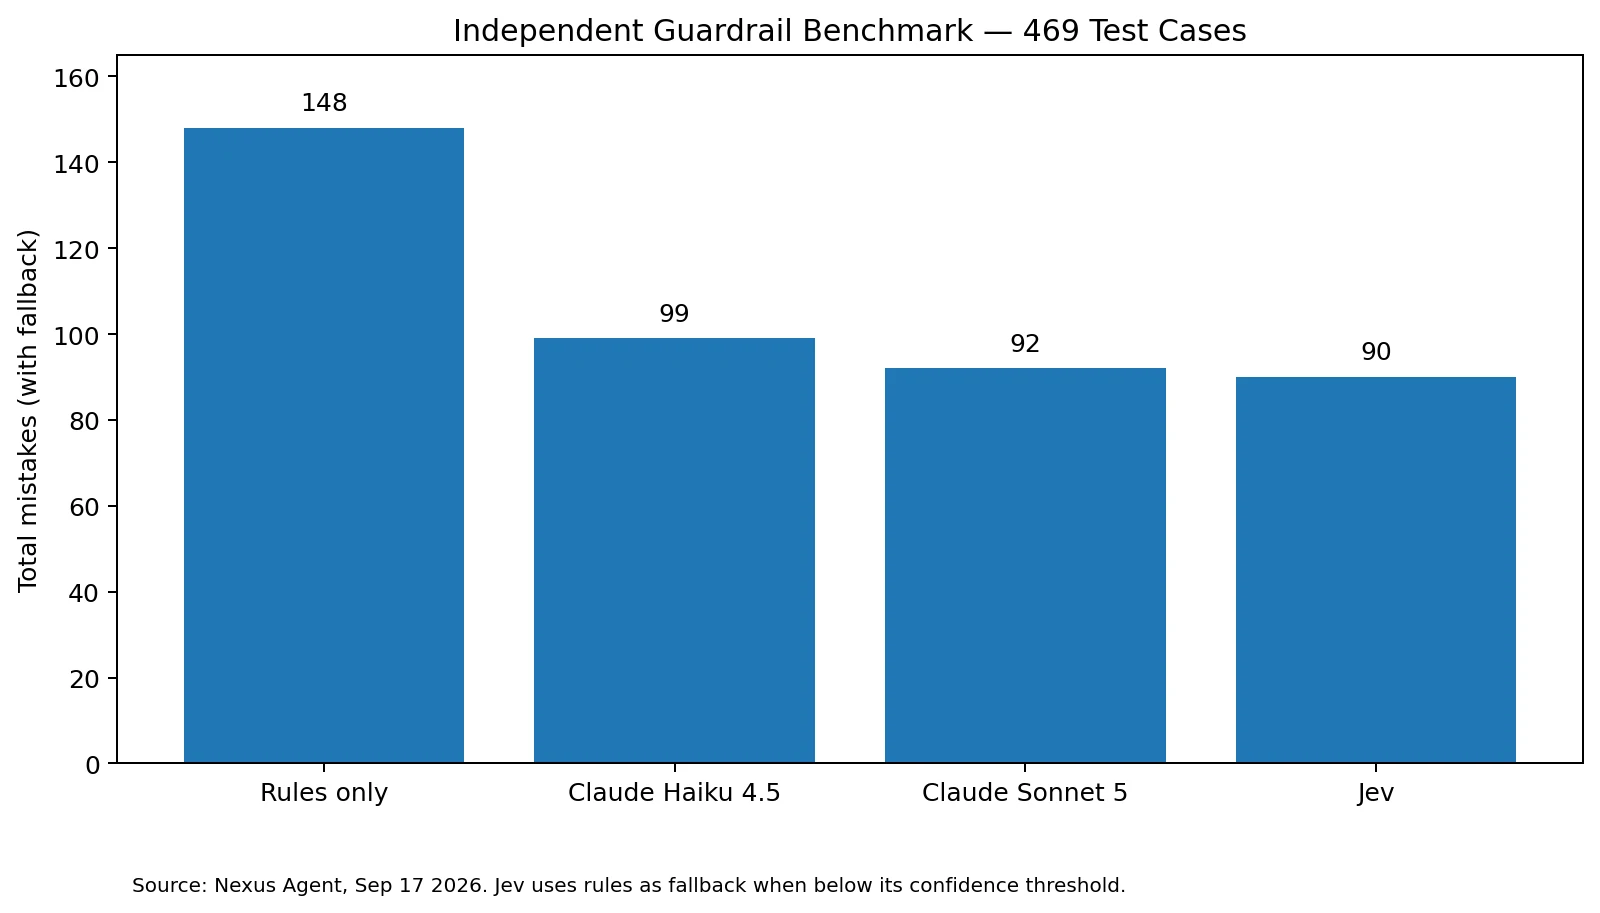
Figure 1. Source : Nexus Agent, 17 septembre 2026.
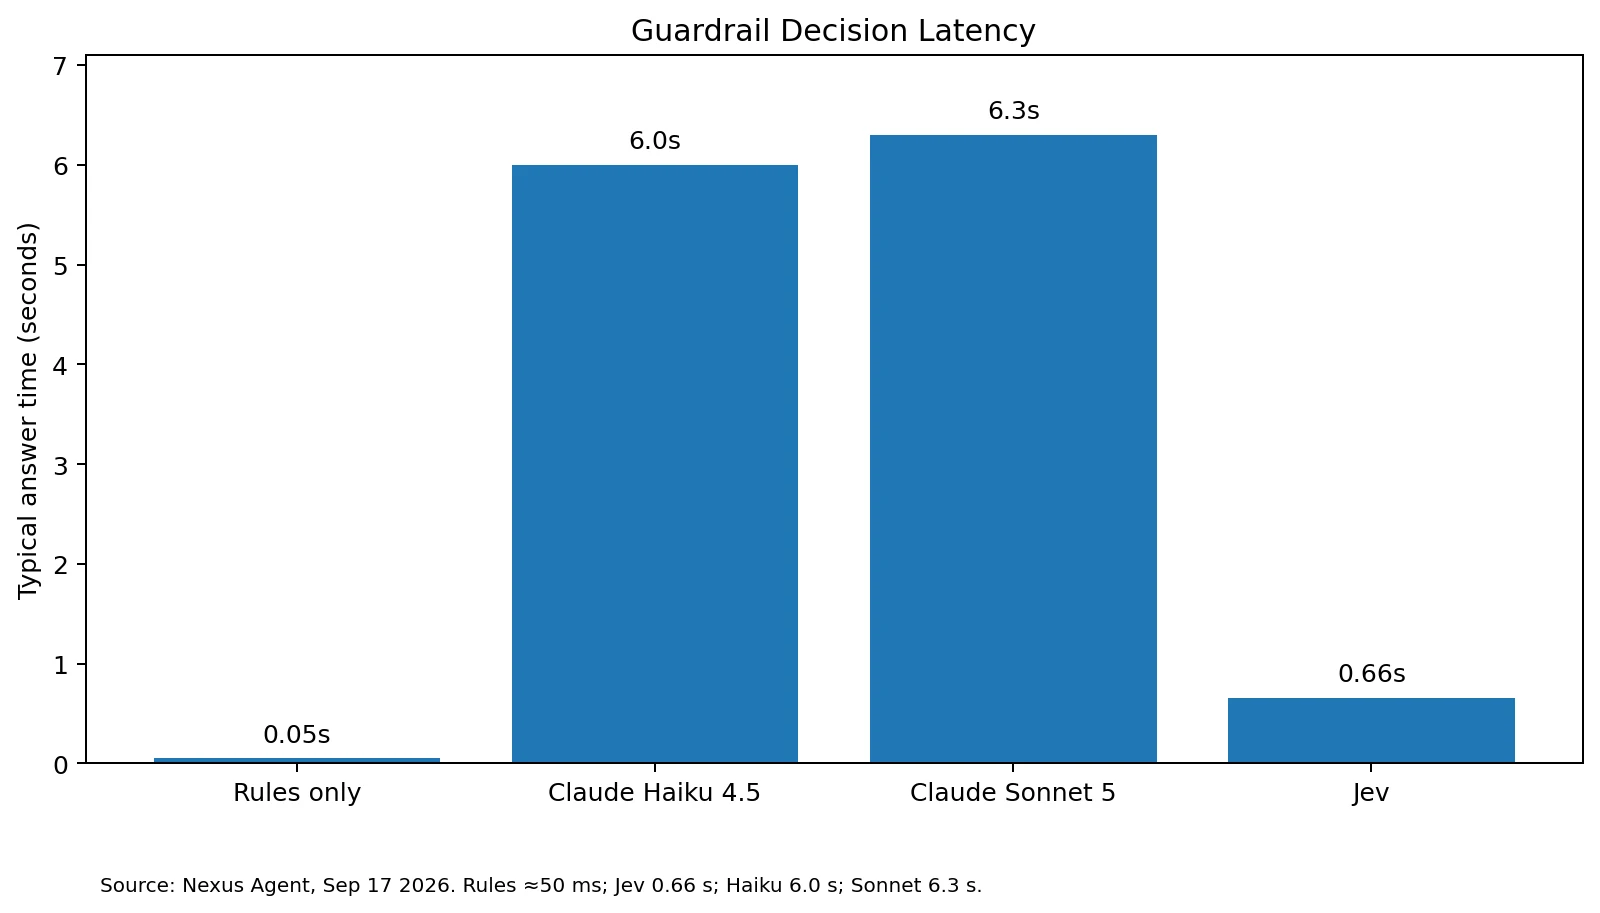
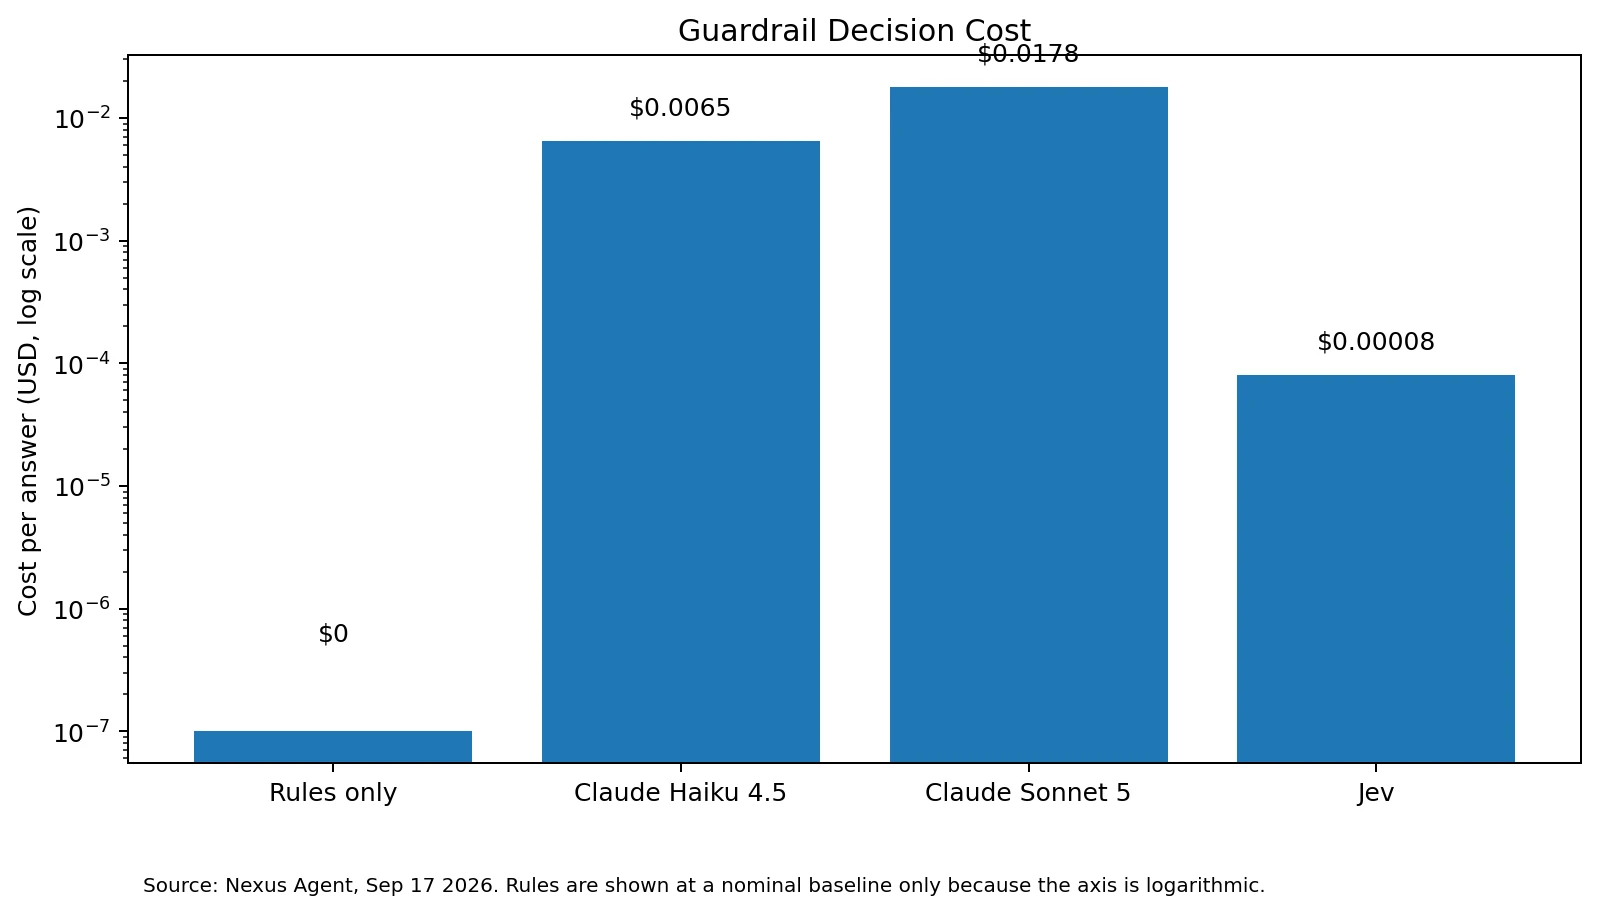
Le point important est la couverture : 1,8% d’erreur lorsqu’il décide ne signifie pas une précision universelle. Le modèle doit répondre lorsqu’il est confiant et remettre les cas incertains à des règles, un modèle plus puissant ou une personne. Nexus rapporte 0,68 seconde de latence médiane et 0,00008 USD par décision dans ce scénario.
Pourquoi la sécurité est un test important
Un SOC pourrait classer plus tôt les signaux en bénins, incertains et à haut risque. L’objectif n’est pas de remplacer les analystes, mais de réserver le raisonnement coûteux et l’attention humaine aux cas utiles. Pour les agents IA, une couche de décision peut évaluer le caractère destructeur, réversible et autorisé d’une action avant que la politique ne la bloque ou l’escalade. Le même modèle s’applique au DLP sémantique, au phishing, à l’IAM, à la fraude et à la priorisation des vulnérabilités.
La sûreté de type n’est pas la justesse : ALLOW peut rester faux quand BLOCK est nécessaire. Ces modèles sont des capteurs probabilistes, pas des moteurs de politique infaillibles. Le coût d’une erreur fixe le seuil : faible impact et forte confiance peuvent être automatisés ; incertitude, impact élevé ou irréversibilité exigent enquête, contrôles et autorisation.
Jev ne remplace ni le raisonnement profond ni le jugement humain. Il peut devenir une couche spécialisée entre détection, raisonnement, vérification, politique et action. Évaluation éditoriale : conserver des limites d’autorisation déterministes, une vérification indépendante, des replis et une revue humaine pour toute action conséquente.
Sources





