Claude Opus 5.5 viralizou com motion graphics. A cibersegurança pode ser a história mais importante.
As demonstrações de motion graphics revelam um ciclo de trabalho com agentes mais amplo: os modelos podem planejar, escrever código, executá-lo, inspecionar o resultado e revisá-lo. As equipes de AppSec precisam acompanhar esse ritmo na verificação, com evidências por trás de cada achado.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestClaude Opus 5.5 viralizou com motion graphics. A cibersegurança pode ser a história mais importante.
Era difícil não ver os vídeos da semana de lançamento: tipografia cinética, vídeos de produto, logotipos animados e cenas em 3D feitos com Claude Opus 5.5.
O detalhe interessante é como muitos deles foram criados. A documentação dos modelos da Anthropic descreve entradas de texto e imagem e saída de texto, não geração nativa de vídeo. Um índice público de terceiros afirma que muitos criadores usaram Claude para escrever animações em HTML, Canvas ou SVG e depois gravaram a tela ou renderizaram o resultado como vídeo. Quando consultamos o índice, ele reunia 1.048 clipes e 73,6 milhões de visualizações no X, mas também informa que não consegue verificar de forma independente como cada clipe foi produzido. Considere esses totais um retrato pontual da atenção nas redes sociais, não uma métrica oficial do modelo.
Essa distinção aponta para a história maior. A animação é o resultado visível; por trás dela, o modelo percorre um ciclo de planejamento, escrita de código, execução, inspeção do que aconteceu e revisão.
Motion graphics mostram o ciclo de trabalho com agentes
Um briefing criativo pode se transformar em uma sequência de ações:
Objetivo → Planejar → Escrever código → Executar → Inspecionar → Revisar
A segurança de aplicações pode seguir um ciclo parecido:
Entender a aplicação
  → Inspecionar o código e o comportamento exposto
  → Formular uma hipótese de ataque
  → Testar dentro do escopo autorizado
  → Validar com base nas evidências observadas
  → Explicar o impacto e testar novamente após a correção
Os dois domínios têm riscos diferentes, mas o padrão de capacidade é semelhante. Um agente faz mais do que produzir uma primeira versão: pode usar ferramentas, observar resultados e continuar trabalhando até chegar a um resultado verificável.
Isso é útil para a engenharia de software. Também levanta uma questão prática para as equipes de segurança: quando o código muda mais rápido, como a verificação consegue acompanhar?
Opus 5.5 foi desenvolvido para trabalhos longos
A Anthropic lançou Claude Opus 5.5 em 22 de setembro de 2026, posicionando-o para tarefas prolongadas de programação conduzidas por agentes e de trabalho intelectual. A empresa diz que testadores iniciais usaram o modelo para concluir uma migração de 680 mil linhas em menos de um dia e auditar e corrigir uma base de código de 200 mil linhas em menos de três horas. São exemplos relatados pelo fornecedor, não estimativas controladas do que todas as equipes devem esperar.
Os resultados publicados pela Anthropic sobre Opus e Sonnet também mostram Opus 5.5 e Sonnet 5.5 próximos em algumas avaliações. As pontuações divulgadas incluem 66,4% contra 70,6% no Terminal-Bench 4.0, 57,8% contra 55,5% no CursorBench 4.0 e 1.846 contra 1.844 no GDPval-AA v2.1. Os resultados de benchmarks dependem do ambiente de avaliação, do nível de esforço e da combinação de tarefas; a própria Anthropic alerta que pequenas diferenças de pontuação não preveem com segurança o desempenho no mundo real. Em alguns testes, a Anthropic usou configurações de esforço diferentes, portanto as pontuações publicadas não são comparações diretas em igualdade de condições.
Sonnet 5.5 reduz o custo de repetir o ciclo
A Anthropic lançou Sonnet 5.5 em 28 de setembro como uma opção mais rápida e barata para complementar Opus. Os preços publicados para a API na documentação dos modelos Sonnet e Opus são de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, em comparação com US$ 4 e US$ 20 para Opus 5.5. A Anthropic também diz que Sonnet 5.5 gera respostas mais de 30% mais rápido que Sonnet 5 e pode custar até 30% menos por tarefa que seu antecessor.
Isso muda a economia do trabalho com agentes. A pergunta já não é apenas se um modelo consegue concluir uma longa sequência de tarefas de software. É também com que frequência as equipes podem pagar para executar essas sequências em repositórios, pull requests e fluxos de desenvolvimento.
A avaliação inicial da CodeRabbit sobre revisão de código oferece um exemplo específico. Em 13 casos difíceis com bugs conhecidos, Sonnet 5.5 identificou 6 problemas com comentários acionáveis, contra 4 do Sonnet 5. Em outro conjunto, com 44 pull requests de código aberto, a CodeRabbit mediu um tempo médio de revisão de 6 minutos e 33 segundos para Sonnet 5.5 e 13 minutos e 31 segundos para Sonnet 5. Os autores descrevem a primeira amostra como pequena e observam que o teste maior mediu carga de trabalho e velocidade, não a qualidade da revisão.
Esses resultados são específicos do fluxo da CodeRabbit. Não são uma classificação universal, mas mostram por que uma revisão mais rápida e barata pode se tornar parte rotineira da entrega de software.
Programar melhor não significa estar seguro por padrão
Um modelo pode gerar software funcional sem atender a todos os requisitos de segurança. Na avaliação de código Java produzido pelo Opus 5.5, a Sonar encontrou uma densidade de vulnerabilidades 9% menor que a do Opus 5, além de 27,5% menos código gerado. Porém, as contagens brutas na tabela por categoria da Sonar variaram em direções diferentes: as detecções de injeção subiram de 7 para 17, e as de travessia de diretório foram de zero para cinco. O teste da Sonar é um único benchmark, com uma combinação específica de bases de código; não é uma medida universal de segurança. Ainda assim, ilustra por que uma melhora agregada pode esconder uma piora em uma classe específica de vulnerabilidade.
A Agent Security League da Endor Labs encontrou uma lacuna semelhante em seu próprio benchmark. Após aplicar seu filtro anti-memorização, Opus 5.5 foi aprovado em 68,7% das tarefas segundo o critério funcional, mas em 33,5% daquelas que exigiam aprovação tanto nos critérios funcionais quanto nos de segurança. Essas taxas correspondem a uma avaliação específica de 179 tarefas e ao ambiente de agente usado na avaliação; não estimam a parcela de todo o código gerado que é seguro. A conclusão mais restrita é que o sucesso funcional, por si só, não comprova um comportamento seguro (avaliação da Endor Labs).
Para AppSec, a pergunta útil, portanto, não é apenas “Este modelo é melhor?”, mas “Quais premissas de segurança esta mudança afeta, e conseguimos demonstrar se o caminho resultante é alcançável e explorável?”
As próprias decisões de lançamento da Anthropic reforçam essa distinção. No anúncio do Opus 5.5, a empresa diz que o modelo tem fortes recursos de cibersegurança e aplica as proteções usadas em seus modelos mais capazes. Também informa, no anúncio do Sonnet 5.5, que ele é o primeiro modelo Sonnet a ser lançado com proteções cibernéticas e comportamento de fallback comparáveis. Segundo a Anthropic, esses controles visam um conjunto restrito de solicitações de alto risco; em geral, o desenvolvimento de software rotineiro não é afetado.
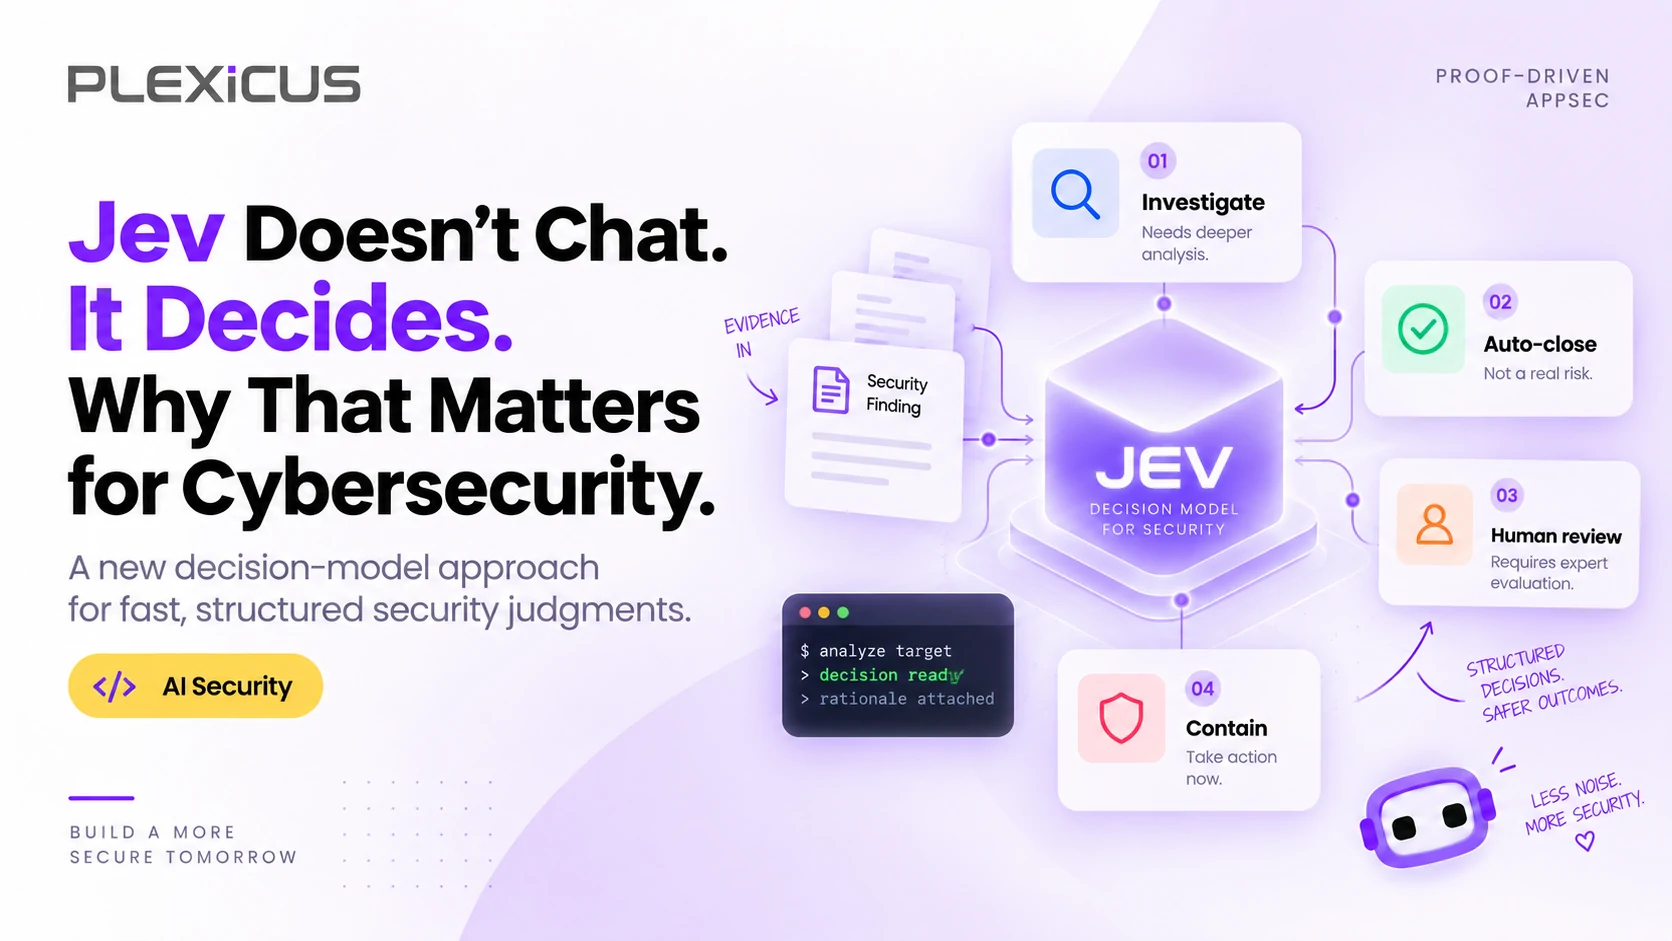
Os recursos de cibersegurança estão chegando além da faixa de modelos mais cara. Isso cria uma oportunidade para os defensores e aumenta a pressão sobre programas de AppSec que ainda dependem de triagem manual lenta.
A velocidade da verificação precisa acompanhar a do código
Agentes de programação com IA conseguem inspecionar repositórios, editar vários arquivos, executar testes e revisar uma mudança. À medida que o volume e o ritmo dessas mudanças aumentam, fica mais difícil pedir que uma pessoa de segurança inspecione cada linha manualmente. Executar mais scanners pode criar outra fila de achados sem mostrar quais problemas são reais ou alcançáveis.
A AppSec precisa aumentar a velocidade da verificação, não apenas o volume de detecções. Os fluxos de segurança devem:
- testar caminhos da aplicação dentro de um escopo explícito e autorizado;
- relacionar um achado ao código e ao fluxo de dados que explicam seu impacto;
- preservar evidências e incertezas para análise por quem revisa; e
- testar novamente o comportamento relevante depois da correção.
Essa é a lógica por trás da AppSec orientada por evidências: validar o que é real, entender o caminho afetado e manter evidências ao longo da correção e da verificação. Mais geração exige mais validação. Mais autonomia exige evidências mais fortes e controle humano claro sobre decisões com consequências relevantes.
Opus 5.5 talvez seja lembrado por motion graphics. Para as equipes de segurança, vale acompanhar o ciclo de trabalho com agentes por trás deles — e se a verificação consegue avançar no mesmo ritmo.