Gemini 4 Carbon: dos benchmarks à evidência AppSec
Transforme resultados de segurança de IA em uma avaliação com achados reproduzíveis, correções revisadas e novos testes do ambiente.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestEm 28 de outubro, o Google publicou resultados de segurança do Gemini 4 Carbon: 88,2% no SEC-bench Pro, 54,8% no ExploitGym e 71,0% no CWE-bench. O Google informa que avaliou esses benchmarks externos sem guardrails. A distribuição anunciada começa com defensores selecionados pelo Fairwind; o anúncio não estabelece acesso geral para desenvolvedores.
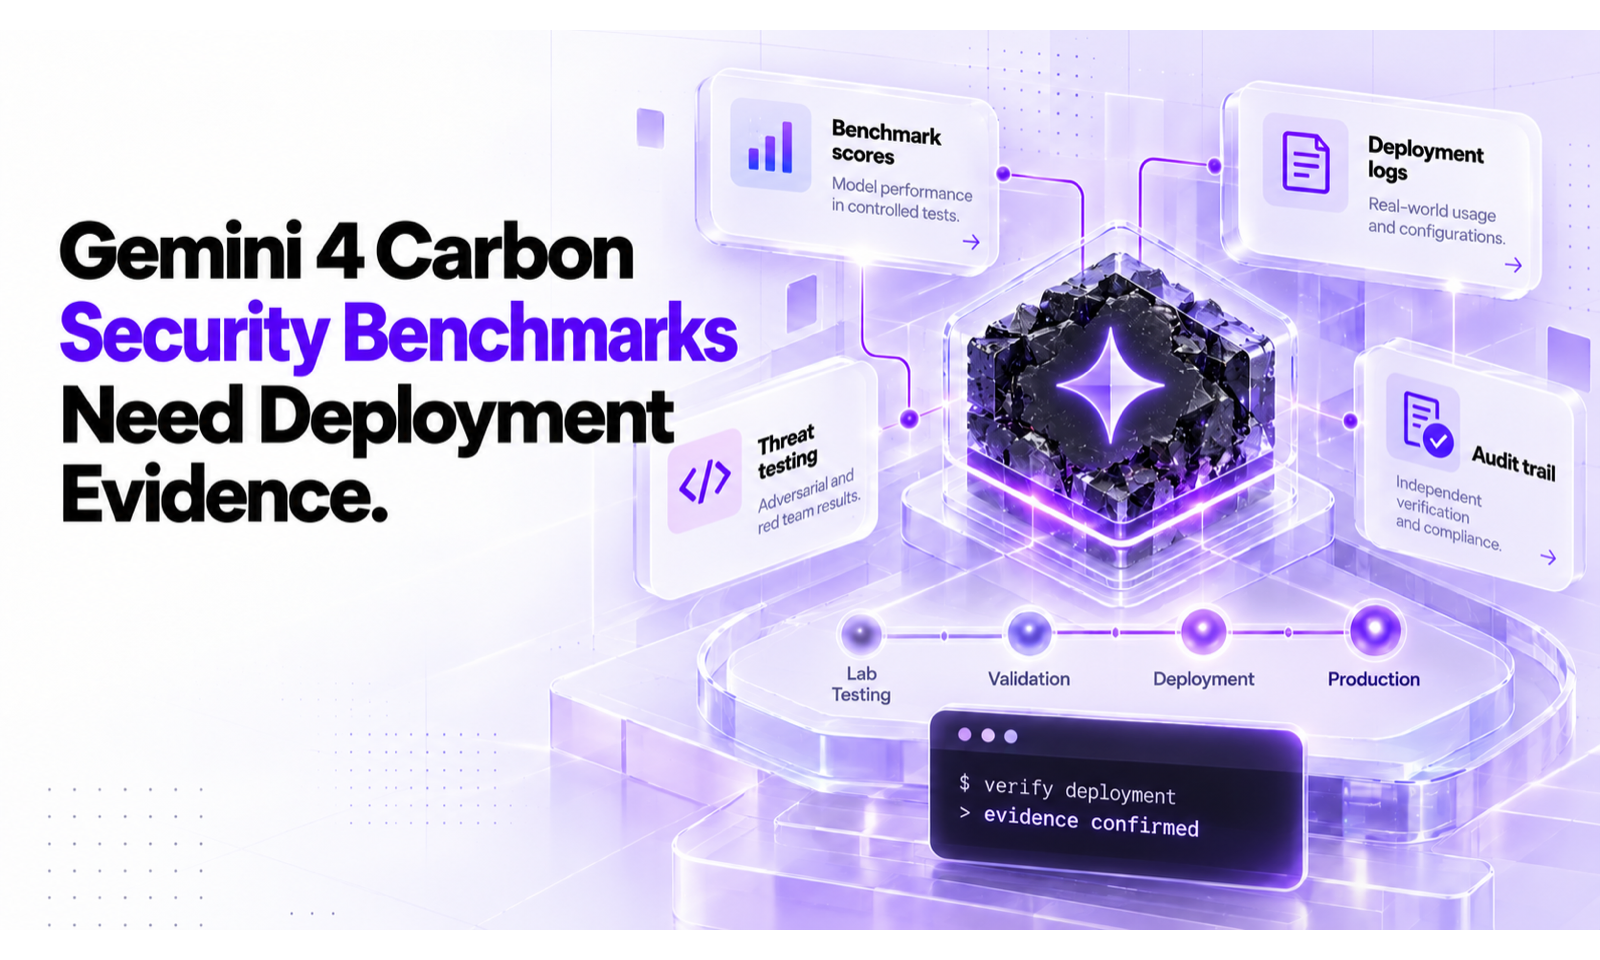
São resultados informados pelo fornecedor. Sua aplicação precisa de outro registro de aceitação: alvo autorizado, falha observada, correção e resultado da repetição do teste. Uma pontuação pode ajudar na seleção. Uma decisão de implantação exige evidência ligada ao seu sistema.
Entenda a tarefa antes de comparar resultados
Os três percentuais correspondem a tarefas diferentes. Não representam etapas sucessivas sobre o mesmo conjunto de vulnerabilidades em produção.
| Benchmark citado pelo Google | Resultado informado | Pergunta para sua avaliação |
|---|---|---|
| SEC-bench Pro | 88,2% | Qual alvo, versão das tarefas e verificador definem uma descoberta válida? |
| ExploitGym | 54,8% | Quais informações iniciais, ambiente e critérios definem a exploração? |
| CWE-bench | 71,0% | Quais verificações demonstram que a correção resolve a falha e preserva o comportamento legítimo? |
O projeto SEC-bench, o repositório ExploitGym e o site CWE-bench documentam seus próprios métodos. Uma página pública atual não demonstra a versão, o denominador ou a configuração usados pelo Google. Não reproduzimos os resultados do Carbon de forma independente.
A média dos percentuais criaria uma métrica sem definição. Multiplicá-los também pressuporia uma amostra e um fluxo comuns que o anúncio não estabelece. Mantenha cada resultado junto de sua tarefa e condições.
Defina um alvo delimitado
Comece com um fluxo relevante da aplicação. Identifique a revisão implantada, contas de teste, interfaces permitidas e exclusões. Use dados sintéticos. Defina quem pode interromper o exercício e quais ações exigem autorização adicional. Um hostname não descreve um escopo suficiente.
Escolha um caso de regressão conhecido e um fluxo de negócio representativo. O primeiro verifica se a avaliação recupera uma falha cujas condições você entende. O segundo verifica se o resultado responde à decisão real da equipe. Nenhum demonstra cobertura completa.
Essa disciplina orienta nosso fluxo Proof-Driven AppSec. Um achado deve oferecer contexto suficiente para repetir a observação nas mesmas condições autorizadas.
Conecte descoberta, validação e correção
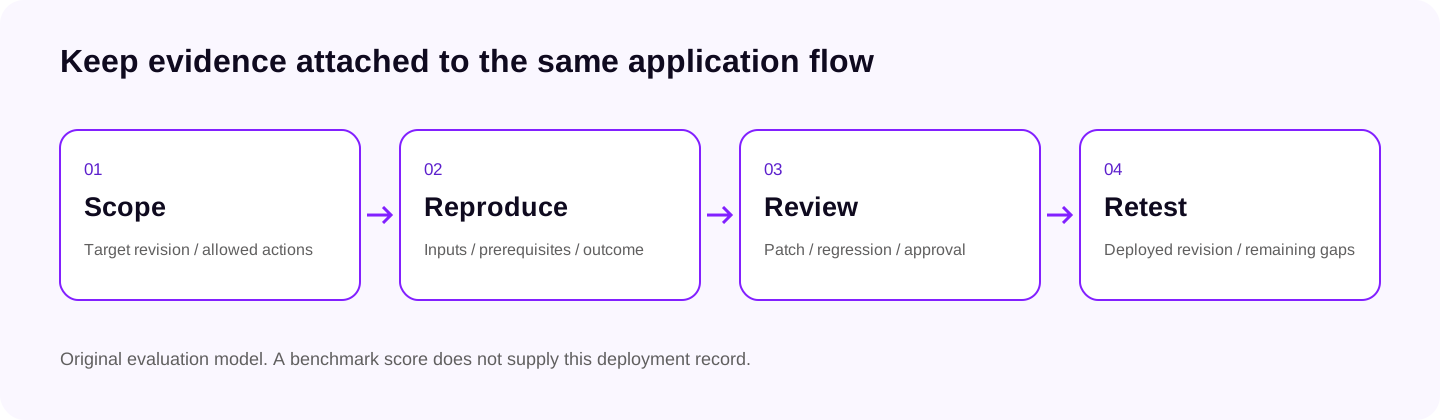
Modelo original de avaliação. Não representa o sistema de benchmarks do Google nem afirma que a Plexicus usa Carbon.
Na descoberta, preserve a entrada relevante, o local no código ou endpoint e o raciocínio que os conecta. Explicite a incerteza. Um padrão suspeito pode ser uma hipótese útil sem já constituir um achado reproduzido.
Na validação, preserve a reprodução mínima e inofensiva do comportamento alegado. Registre permissões, configuração e entradas acessíveis. Um timeout, ferramenta bloqueada ou dependência indisponível é um resultado incompleto. Isso não demonstra resistência ao ataque.
Na correção, exija um diff revisável, um teste da falha original e verificações do comportamento legítimo. Repita a observação no ambiente corrigido. Diferencie não conseguir reproduzir de comprovar a remoção da causa. Nosso guia de remediação descreve a passagem da correção proposta para a aprovação.
Preserve as condições que alteram a resposta
O modelo é uma parte do sistema de avaliação. Ferramentas, permissões, contexto, orçamento de tempo e ambiente de execução também influenciam o resultado. Preserve essas configurações para permitir a revisão posterior.
Um benchmark sem guardrails não estabelece o comportamento de uma configuração de produto com restrições diferentes. Uma ação permitida em laboratório também não autoriza sua execução contra um cliente. Defina as ações permitidas antes do teste e informe o trabalho bloqueado depois.
O pacote de evidência deve incluir:
- Revisão do alvo, configuração e escopo autorizado.
- Modelo, ferramentas, orçamento e restrições relevantes.
- Entradas de reprodução, pré-requisitos e resultado observado.
- Correção revisada, regressão e verificações do fluxo legítimo.
- Revisão implantada, resultado do novo teste e questões em aberto.
O pacote continua útil quando o modelo muda e expõe lacunas ocultas por uma pontuação. A distinção entre análise e resultado verificado também é central para Deep Code Analysis.
Defina com a Plexicus um resultado revisável
A Plexicus apresenta AI Swarm Pentest como uma avaliação delimitada de aplicações e APIs. Seu fluxo de remediação descreve correções revisáveis e novos testes de verificação. Leve um fluxo específico e um contrato de evidência. Esclareça quais observações, alterações e registros de teste fazem parte do escopo acordado.
Este artigo não estabelece uma integração com Carbon, uma reprodução dos seus benchmarks ou uma comparação de desempenho entre Plexicus e Google. A pergunta prática é se sua avaliação produz evidência que os engenheiros podem examinar para aprovar uma mudança.
Quer avaliar um fluxo da aplicação? Entre em contato com a Plexicus com o alvo autorizado e o resultado que precisa verificar.
Fontes