Fadiga de Alertas
A fadiga de alertas ocorre quando as equipes de segurança ou operações são inundadas com alertas todos os dias. Com o tempo, as pessoas ficam cansadas, estressadas e começam a ignorá-los.
Fadiga de Alertas
Resumo
A fadiga de alertas ocorre quando as equipes recebem tantas notificações que param de prestar atenção nelas.
O que é Fadiga de Alertas?
A fadiga de alertas é o que acontece quando equipes de segurança ou operações são inundadas com alertas todos os dias. Com o tempo, as pessoas ficam cansadas, estressadas e começam a ignorá-los.
Em segurança, isso geralmente vem de ferramentas que alertam sobre tudo, questões reais, questões pequenas e coisas que não são problemas de fato.
Quando todo alerta parece crítico, nenhum deles parece verdadeiramente urgente. O cérebro aprende a ignorá-los, como um alarme que toca com muita frequência.
Por que a Fadiga de Alertas é Perigosa
A fadiga de alertas não é apenas irritante. É arriscada.
Muitas grandes violações de segurança ocorreram mesmo com alertas disparados. O problema foi que ninguém percebeu ou reagiu a tempo.
Principais riscos:
1. Ameaças reais são ignoradas.
Quando a maioria dos alertas são falsos alarmes, ataques reais parecem iguais e são perdidos.
2. Resposta lenta
O tempo gasto revisando alertas inúteis é tempo não gasto corrigindo problemas reais.
3. Erros humanos
Equipes cansadas cometem erros, pulam etapas ou julgam mal o risco.
Por que a Fadiga de Alertas Acontece
A fadiga de alertas geralmente vem de uma combinação de ferramentas ruins e configuração inadequada.
Causas comuns:
- Muitos falsos positivos
- Ferramentas sinalizam possíveis problemas sem verificar se eles podem realmente ser explorados.
- Sem real priorização
- Tudo recebe a mesma severidade, mesmo quando o risco é muito diferente.
- Alertas duplicados
- Múltiplas ferramentas relatam o mesmo problema de maneiras diferentes.
- Regras rígidas
- Alertas são acionados com base em limites fixos em vez de comportamento real.
Como Reduzir a Fadiga de Alertas
A única solução real é reduzir o ruído e focar no que importa.
Foco no Risco Real
Nem todos os problemas são iguais. Plexicus fornece algumas métricas para ajudar você a priorizar vulnerabilidades:
1) Métricas de Prioridade
O que mede: Urgência geral para remediação
É uma pontuação (0-100) que combina severidade técnica (CVSSv4), impacto nos negócios e disponibilidade de exploração em um único número. É sua fila de ações - ordene por Prioridade para saber o que abordar imediatamente. Prioridade 85 significa “largue tudo e resolva isso agora”, enquanto Prioridade 45 significa “agende para o próximo sprint.”
Exemplo: Injeção SQL em uma ferramenta de produtividade interna, acessível apenas pela VPN corporativa, não contém dados sensíveis
- CVSSv4: 8.2 (alta severidade técnica)
- Impacto nos Negócios: 45 (ferramenta interna, exposição de dados limitada)
- Disponibilidade de Exploração: 30 (requer acesso autenticado)
- Prioridade: 48
Por que Procurar Prioridade: Apesar de um CVSSv4 alto (8.2), a Prioridade (48) corretamente reduz a urgência devido ao impacto limitado nos negócios e baixa explorabilidade. Se você olhasse apenas para o CVSS, entraria em pânico desnecessariamente. A Prioridade diz: “Agende isso para o próximo sprint,” com uma pontuação em torno de 45.
Isso torna a recomendação de “próximo sprint” muito mais razoável - é uma vulnerabilidade real que precisa ser corrigida, mas não é uma emergência porque está em uma ferramenta interna de baixo impacto com exposição limitada.
2) Impacto
O que mede: Consequências para os negócios
Impacto (0-100) avalia o que acontece se a vulnerabilidade for explorada, considerando seu contexto específico: sensibilidade dos dados, criticidade do sistema, operações de negócios e conformidade regulatória.
Exemplo: Injeção SQL em um banco de dados de clientes voltado para o público tem Impacto 95, mas a mesma vulnerabilidade em um ambiente de teste interno tem Impacto 30.
3) EPSS
O que mede: Probabilidade de ameaça no mundo real
EPSS é uma pontuação (0.0-1.0) que prevê a probabilidade de que um CVE específico seja explorado na prática nos próximos 30 dias.
Exemplo: Uma vulnerabilidade de 10 anos pode ter CVSS 9.0 (muito grave), mas se ninguém estiver explorando-a mais, o EPSS seria baixo (0.01). Por outro lado, um CVE mais recente com CVSS 6.0 pode ter EPSS 0.85 porque os atacantes estão ativamente usando-o.
Você pode verificar essas métricas para priorização seguindo estes passos:
- Certifique-se de que seu repositório está conectado e o processo de varredura foi concluído.
- Em seguida, vá para o menu Findings, onde você encontrará as métricas necessárias para priorização.
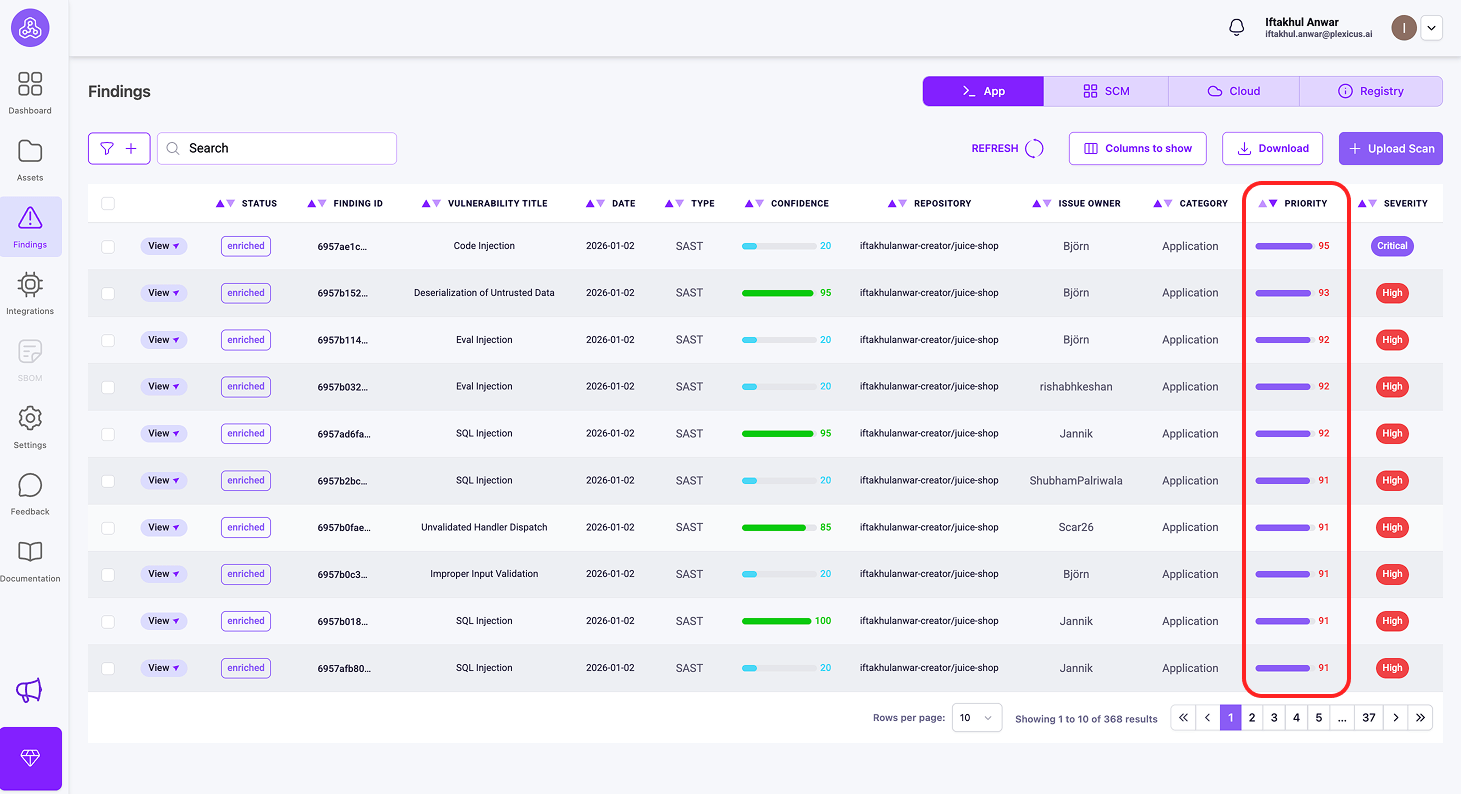
Diferenças Principais
| Métrica | Respostas | Escopo | Intervalo |
|---|---|---|---|
| EPSS | “Os atacantes estão usando isso?” | Paisagem global de ameaças | 0.0-1.0 |
| Prioridade | “O que eu conserto primeiro?” | Pontuação de urgência combinada | 0-100 |
| Impacto | “Quão ruim para MEU negócio?” | Específico para a organização | 0-100 |
Adicionar Contexto
Se uma biblioteca vulnerável existe, mas seu aplicativo nunca a utiliza, esse alerta não deve ser de alta prioridade.
Ajustar e Automatizar
Ensine as ferramentas ao longo do tempo o que é seguro e o que não é. Automatize correções simples para que as pessoas lidem apenas com ameaças reais.
Usar Uma Visão Clara
Usar uma plataforma única como Plexicus ajuda a remover alertas duplicados e mostra apenas o que precisa de ação.
Fadiga de Alertas na Vida Real
| Situação | Sem Controle de Ruído | Com Alertas Inteligentes |
|---|---|---|
| Alertas diários | 1.000+ | 15–20 |
| Humor da equipe | Sobrecarregado | Focado |
| Riscos perdidos | Comuns | Raros |
| Objetivo | Alertas claros | Corrigir problemas reais |
Termos Relacionados
FAQ
Quantos alertas são muitos?
A maioria das pessoas consegue revisar adequadamente cerca de 10–15 alertas por dia. Mais do que isso geralmente leva a problemas não detectados.
A fadiga de alertas é apenas um problema de segurança?
Não. Isso também acontece na área da saúde, operações de TI e suporte ao cliente. Em segurança, o impacto é pior porque alertas perdidos podem levar a graves violações.
Desativar alertas piora as coisas?
Se os alertas forem desativados sem consideração, sim.
Se os alertas forem reduzidos com base no risco real e no contexto, a segurança realmente melhora.
