Gemini 4 Carbon: Von Benchmarks zu AppSec-Nachweisen
Überführen Sie KI-Sicherheitswerte in eine klar begrenzte Prüfung mit reproduzierbaren Befunden, geprüften Patches und erneuten Tests.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenAm 28. Oktober veröffentlichte Google Sicherheitswerte für Gemini 4 Carbon: 88,2 % bei SEC-bench Pro, 54,8 % bei ExploitGym und 71,0 % bei CWE-bench. Laut Google liefen diese externen Benchmarks ohne Guardrails. Der angekündigte Start richtet sich über Fairwind an ausgewählte Cyberverteidiger; ein allgemeiner Entwicklerzugang ist damit nicht belegt.
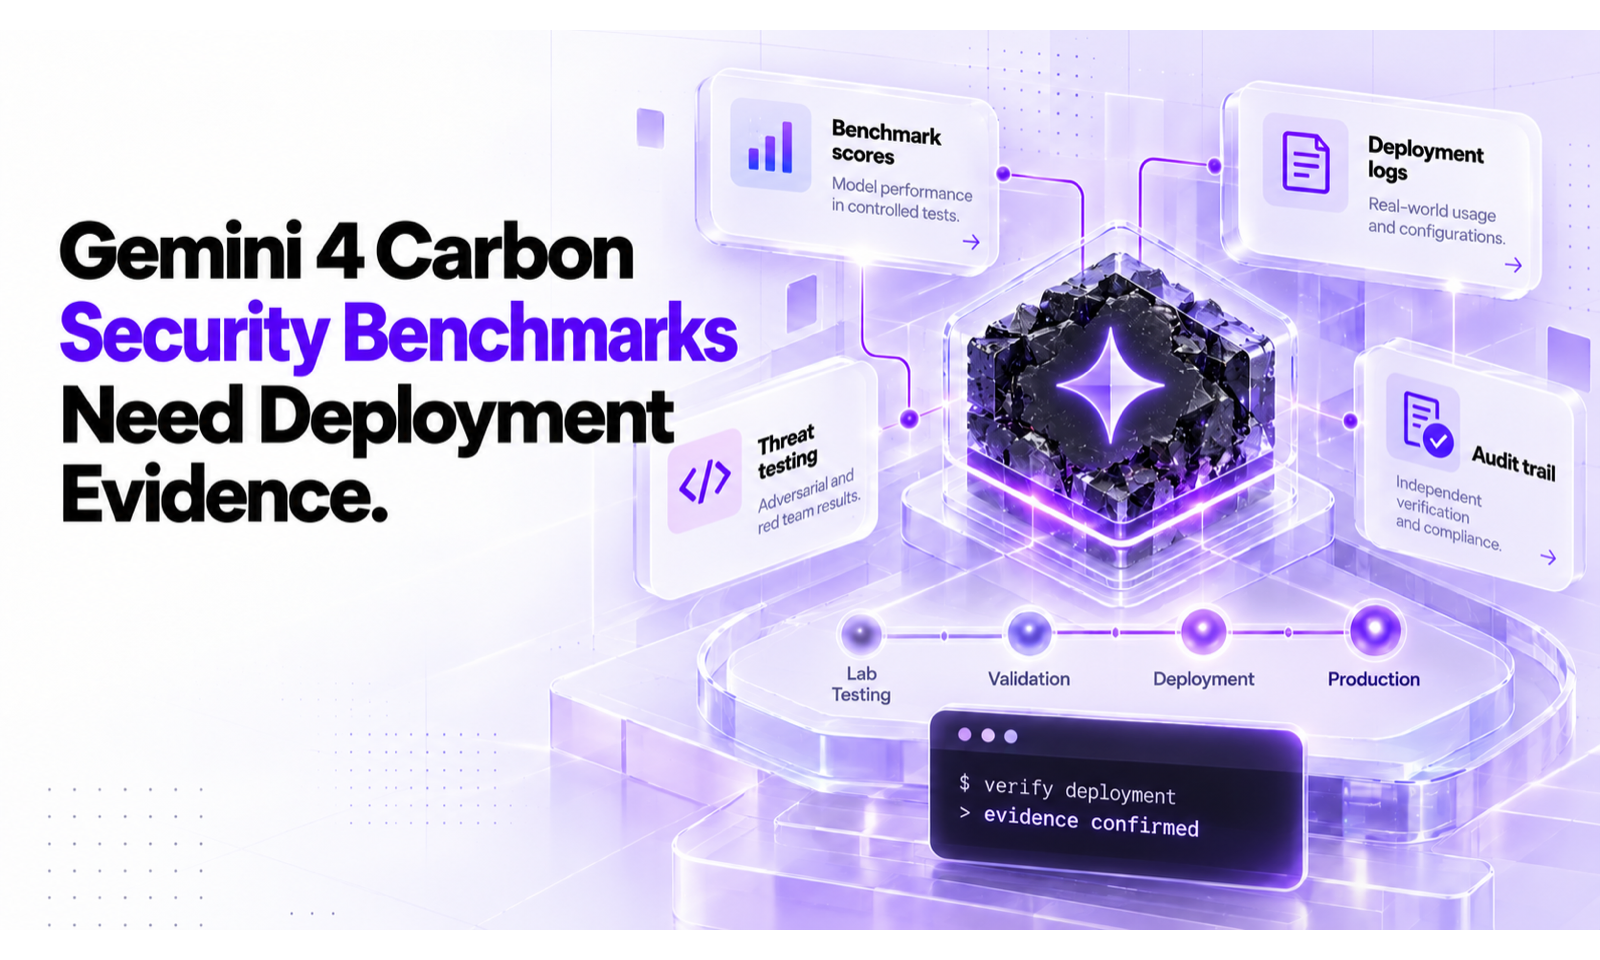
Das sind vom Anbieter gemeldete Ergebnisse. Für Ihre Anwendung brauchen Sie einen anderen Abnahmenachweis: das autorisierte Ziel, den beobachteten Fehler, den Patch und das Ergebnis des erneuten Tests. Ein Modellwert kann die Auswahl unterstützen. Eine Freigabe braucht Nachweise für Ihr System.
Erst die Aufgabe verstehen, dann Werte vergleichen
Die drei Prozentsätze betreffen unterschiedliche Aufgaben. Sie sind keine aufeinanderfolgenden Erfolgsquoten eines gemeinsamen Bestands produktiver Schwachstellen.
| Von Google genannter Benchmark | Gemeldeter Wert | Frage für Ihre Prüfung |
|---|---|---|
| SEC-bench Pro | 88,2 % | Welche Zielversion, Aufgaben und Prüfer definieren einen gültigen Fund? |
| ExploitGym | 54,8 % | Welche Ausgangsinformationen, Umgebung und Kriterien definieren eine Ausnutzung? |
| CWE-bench | 71,0 % | Welche Prüfungen belegen Fehlerbehebung und unveränderte legitime Funktionen? |
Das SEC-bench-Projekt, das ExploitGym-Repository und die CWE-bench-Seite dokumentieren ihre eigenen Verfahren. Aus einer aktuellen öffentlichen Seite lässt sich die genaue Version, Grundgesamtheit oder Agentenkonfiguration von Googles Lauf nicht ableiten. Wir haben die Carbon-Ergebnisse nicht unabhängig reproduziert.
Ein Mittelwert hätte keine definierte Bedeutung. Eine Multiplikation würde eine gemeinsame Stichprobe und einen gemeinsamen Ablauf unterstellen, die der Beitrag nicht belegt. Halten Sie jedes Ergebnis mit seiner Aufgabe und seinen Bedingungen zusammen.
Ein klar begrenztes Prüfziel festlegen
Beginnen Sie mit einem wichtigen Anwendungsablauf. Benennen Sie die bereitgestellte Revision, Testkonten, erlaubte Schnittstellen und Ausschlüsse. Verwenden Sie synthetische Daten. Legen Sie fest, wer den Versuch stoppen darf und welche Aktionen eine weitere Genehmigung brauchen. Ein Hostname allein beschreibt keinen ausreichenden Umfang.
Wählen Sie einen bekannten Regressionstest und einen repräsentativen Geschäftsablauf. Der bekannte Test prüft, ob die Untersuchung einen verstandenen Fehler wiederfindet. Der Geschäftsablauf prüft, ob das Ergebnis die konkrete Entscheidung Ihres Teams unterstützt. Beides beweist keine vollständige Abdeckung.
Diese Nachweisdisziplin liegt unserem Proof-Driven-AppSec-Ablauf zugrunde. Ein Befund sollte genug Kontext enthalten, um die Beobachtung unter denselben autorisierten Bedingungen zu wiederholen.
Entdeckung, Validierung und Korrektur verbinden
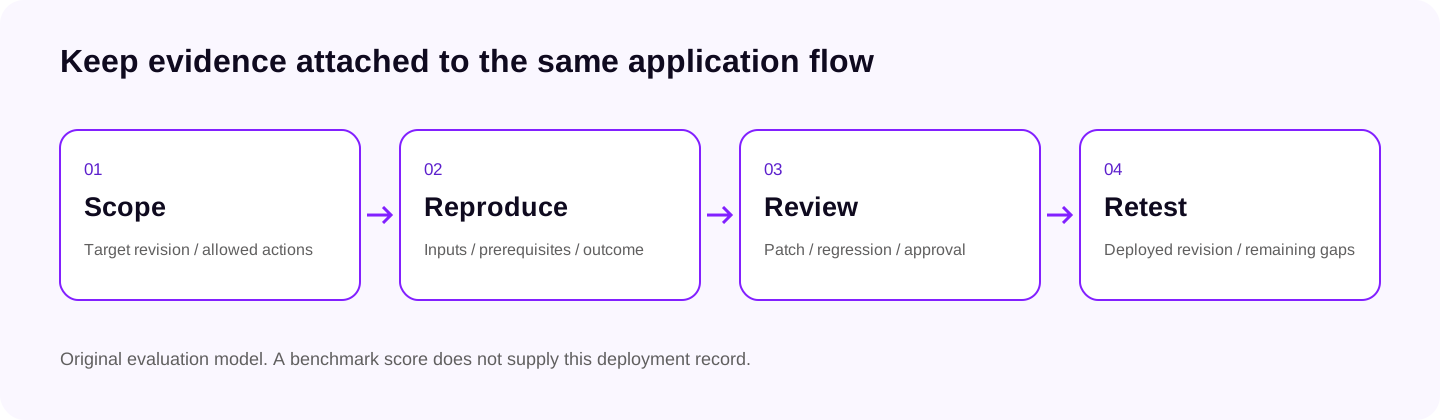
Eigenes Prüfmodell. Es zeigt weder Googles Benchmark-System noch behauptet es einen Carbon-Einsatz bei Plexicus.
Bewahren Sie bei der Entdeckung relevante Eingaben, Codestellen oder Endpunkte sowie die verbindende Begründung auf. Kennzeichnen Sie Unsicherheit. Ein verdächtiges Muster kann eine nützliche Hypothese sein, ohne bereits ein reproduzierter Befund zu sein.
Bei der Validierung brauchen Sie die kleinste harmlose Reproduktion des behaupteten Verhaltens. Dokumentieren Sie Berechtigungen, Konfiguration und erreichbare Eingaben. Ein Timeout, ein blockierter Werkzeugaufruf oder eine fehlende Abhängigkeit ist ein unvollständiges Ergebnis. Das beweist keine Widerstandsfähigkeit.
Für die Korrektur benötigen Sie einen prüfbaren Diff, einen Test des ursprünglichen Fehlers und Prüfungen legitimer Funktionen. Wiederholen Sie die Beobachtung am korrigierten Deployment. Unterscheiden Sie fehlende Reproduzierbarkeit vom Nachweis einer beseitigten Ursache. Unser Remediation-Leitfaden beschreibt die Übergabe vom Änderungsvorschlag zur Freigabe.
Ergebnisrelevante Bedingungen aufbewahren
Das Modell ist ein Teil des Prüfsystems. Werkzeuge, Rechte, Kontext, Zeitbudget und Ausführungsumgebung prägen ebenfalls das Ergebnis. Bewahren Sie diese Einstellungen auf, damit andere die Prüfung nachvollziehen können.
Ein Lauf ohne Guardrails belegt nicht das Verhalten einer anders eingeschränkten Produktkonfiguration. Eine erlaubte Laboraktion erlaubt auch keinen Einsatz gegen ein Kundensystem. Definieren Sie erlaubte Aktionen vorher und dokumentieren Sie blockierte Aufgaben danach.
Ein kompaktes Nachweispaket enthält:
- Zielrevision, Konfiguration und autorisierten Umfang.
- Modell, Werkzeuge, Budget und relevante Einschränkungen.
- Reproduktionseingaben, Voraussetzungen und Beobachtung.
- Geprüften Patch, Regressionstest und legitime Funktionsprüfungen.
- Bereitgestellte Revision, erneutes Testergebnis und offene Fragen.
Das Paket bleibt bei Modellwechseln nützlich und macht Lücken sichtbar. Die Unterscheidung zwischen Analyse und geprüftem Ergebnis ist auch für Deep Code Analysis zentral.
Mit Plexicus ein prüfbares Ergebnis vereinbaren
Plexicus beschreibt AI Swarm Pentest als klar begrenzte Anwendungs- und API-Prüfung. Der Remediation-Ablauf beschreibt prüfbare Korrekturen und erneute Verifikation. Bringen Sie einen konkreten Ablauf und einen Nachweisvertrag mit. Klären Sie, welche Beobachtungen, Änderungen und Retest-Protokolle zum vereinbarten Umfang gehören.
Dieser Beitrag belegt weder eine Carbon-Integration noch einen reproduzierten Carbon-Benchmark oder einen Leistungsvergleich zwischen Plexicus und Google. Entscheidend ist, ob Ihre Prüfung Nachweise liefert, mit denen Ihre Entwickler eine Änderung bewerten und freigeben können.
Möchten Sie einen Anwendungsablauf prüfen? Kontaktieren Sie Plexicus mit dem autorisierten Ziel und dem zu verifizierenden Ergebnis.
Quellen