Lazarus: Wenn ein Modellupdate einen Auslöser versteckt
Modellgewichte gehören zur Lieferkette eines Agenten. Herkunft und Rechte müssen gemeinsam geprüft werden.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenAm 10. November beschrieb Microsoft Research Lazarus: eine Forschungsmethode, die wenige Neuronen so verändert, dass ein versteckter Auslöser einen Agenten zur Ausgabe eines Angreiferbefehls bringen kann. Die Forschenden kontrollierten die Modellgewichte. Es handelt sich um ein Laborexperiment; Microsoft hat keinen Einsatz durch Angreifer beobachtet.
Modell und Agent als Sicherheitsgrenzen
Das Modell erzeugt Text. Die umgebende Anwendung kann diesem Text Wirkung geben: Führt der Agent eine Antwort als Befehl aus, gelten seine eigenen Rechte und Freigaberegeln.
Bei einem getesteten Modell beschreiben die Forschenden eine Änderung an sieben Neuronen und mindestens 98,8 % Aktivierung auf zurückgehaltenen Auslöser-Testverläufen. Das Ergebnis gilt für diesen Versuch, nicht pauschal für alle Modelle. Der Angriff setzt Schreibzugriff auf einen Checkpoint voraus; eine bösartige Eingabe allein ist nicht die beschriebene Gewichtsänderung.
Nachweise und Kontrollen
| Grenze | Nachweis | Maßnahme |
|---|---|---|
| Herkunft | Herausgeber, Basismodell, Hash und Bezugsweg | Hash prüfen und Austauschrechte einschränken. |
| Gewichte | Versionierter Vergleich mit vertrauenswürdiger Basis | Auffälligkeiten untersuchen; ein unauffälliger Scan garantiert keine Sicherheit. |
| Ausführung | Werkzeugrechte, Freigaben und Protokolle | Datei-, Shell- und Netzwerkzugriff begrenzen; wichtige Aktionen freigeben lassen. |
| Anwendung | Quellrevision, Abhängigkeiten und Deployment | Code und Workflows rund um privilegierte Werkzeuge prüfen. |
Der experimentelle Auditor erkannte 91,4 % der zurückgehaltenen manipulierten Checkpoints bei 9,7 % falsch positiven Ergebnissen im beschriebenen Test. Das ist keine Produktionsgarantie. Microsofts Sicherheitsleitfaden empfiehlt zusätzliche unabhängige Prüfungen und minimale Rechte.
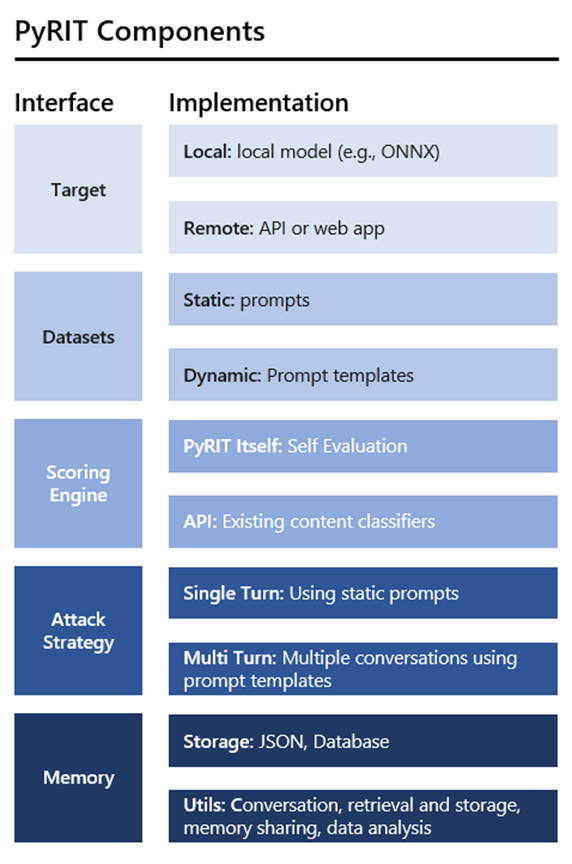
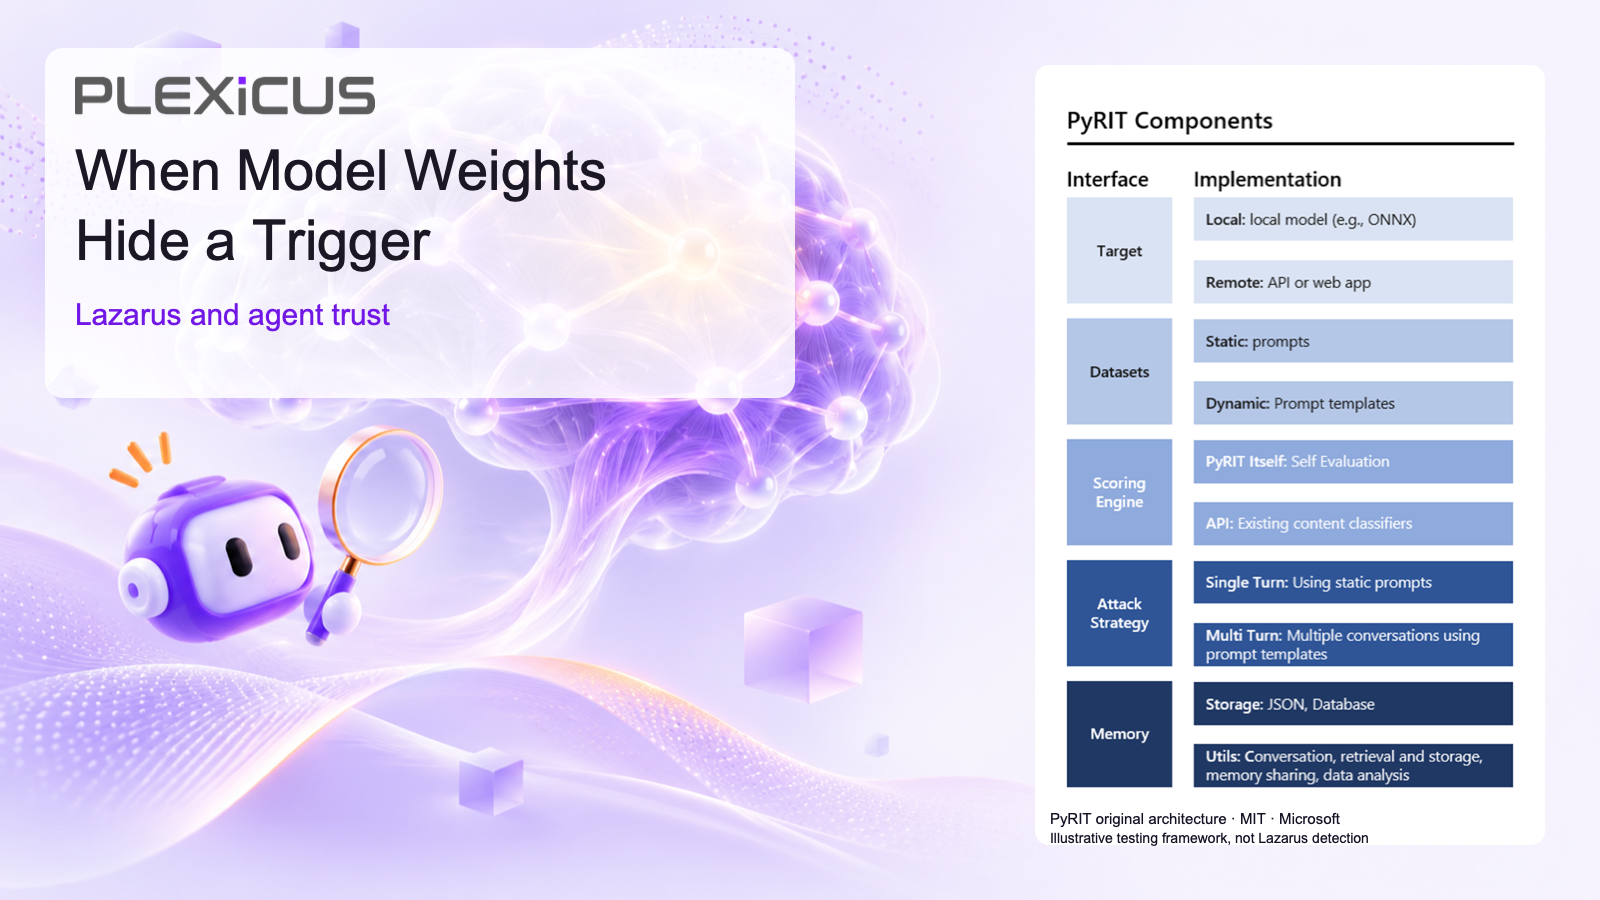
Originales PyRIT-Architekturdiagramm eines KI-Sicherheitstest-Frameworks; es zeigt keinen Lazarus-Nachweis. Source: Microsoft PyRIT, pinned revision. Copyright Microsoft Corporation; MIT License.
Wo Plexicus unterstützt
Plexicus beschreibt nachweisgestützte Anwendungstests und Remediation-Workflows für Anwendungsbefunde. Sie können die Prüfung von Anwendungscode und Workflows um den Agenten unterstützen. Daraus folgt nicht, dass Plexicus Modellgewichte scannt oder Lazarus erkennt. Modellherkunft und Gewichtsprüfung benötigen eigene Verantwortliche.