Jev no conversa. Decide. Por qué importa para la ciberseguridad.
Jev devuelve decisiones tipadas en vez de prosa. Eso puede cambiar dónde encaja el juicio semántico en seguridad, siempre que se mantengan política, respaldo, verificación y revisión humana.

Durante años la carrera de IA se ha centrado en una pregunta: ¿qué modelo genera la mejor respuesta? TypeSafe AI plantea otra: ¿qué ocurre si el software no necesita una respuesta, sino una decisión?
El 15 de septiembre de 2026 TypeSafe presentó Jev, un modelo que recibe contexto y preguntas predefinidas y devuelve elecciones, puntuaciones o probabilidades tipadas. En seguridad, esa diferencia puede ser importante: cada día los sistemas deben decidir si un inicio de sesión es sospechoso, si un proceso debe detenerse o si una acción de un agente excede sus permisos.
De generar lenguaje a decidir
Un LLM puede explicar por qué una alerta parece sospechosa. El software, sin embargo, suele acabar necesitando solo esto:
riesgo = crítico
acción = contener
confianza = 0,97
Jev elimina la generación de prosa: la aplicación define las salidas posibles y el modelo devuelve probabilidades. TypeSafe lo resume como estado no estructurado de entrada y decisiones probabilísticas tipadas de salida. Su integración con Vercel AI Gateway describe decisiones de tipo Choice, Score y Boolean evaluadas en paralelo.
Una prueba de seguridad ya existe
La evaluación Security Incidents de TypeSafe incorpora alerta, activo, propietario, tickets, dispositivos, mantenimiento y autorizaciones. Primero pregunta si la actividad parece no autorizada, si los registros la explican y qué fuerza tiene la evidencia; después puede evaluar credenciales, sesiones, correo, persistencia, procesos, red y propagación. Sus salidas incluyen notificar, escalar, terminar procesos y deshabilitar cuentas.
Esto se parece a la lógica de SIEM, SOAR y triage. La diferencia potencial es que parte de la ramificación deja de ser solo determinista. Ante un viaje válido, MFA completado y un cambio VPN aprobado, una regla simple no basta. Un modelo de decisión podría devolver probabilidades de actividad no autorizada, explicación aprobada, compromiso y necesidad de contención. El modelo estima; la política de seguridad aplica.
Las primeras pruebas independientes
TypeSafe comunica 70–500 ms de latencia y 0,042 USD por millón de tokens de entrada, además de comparativas de flujo de trabajo muy favorables. Son resultados del proveedor: la empresa reconoce que sus mayores ganancias representan el extremo alto de los resultados reales y que sus propios especialistas diseñaron los flujos.
La evaluación de Nexus Agent aporta evidencia externa inicial. Informa de 19.118 momentos reales y 36.218 llamadas a Jev. En 469 casos de guardrails, Jev decidió el 58% de los casos, con 90 errores totales tras recurrir a reglas para los casos inciertos; las reglas tuvieron 148, Haiku 99 y Sonnet 92.
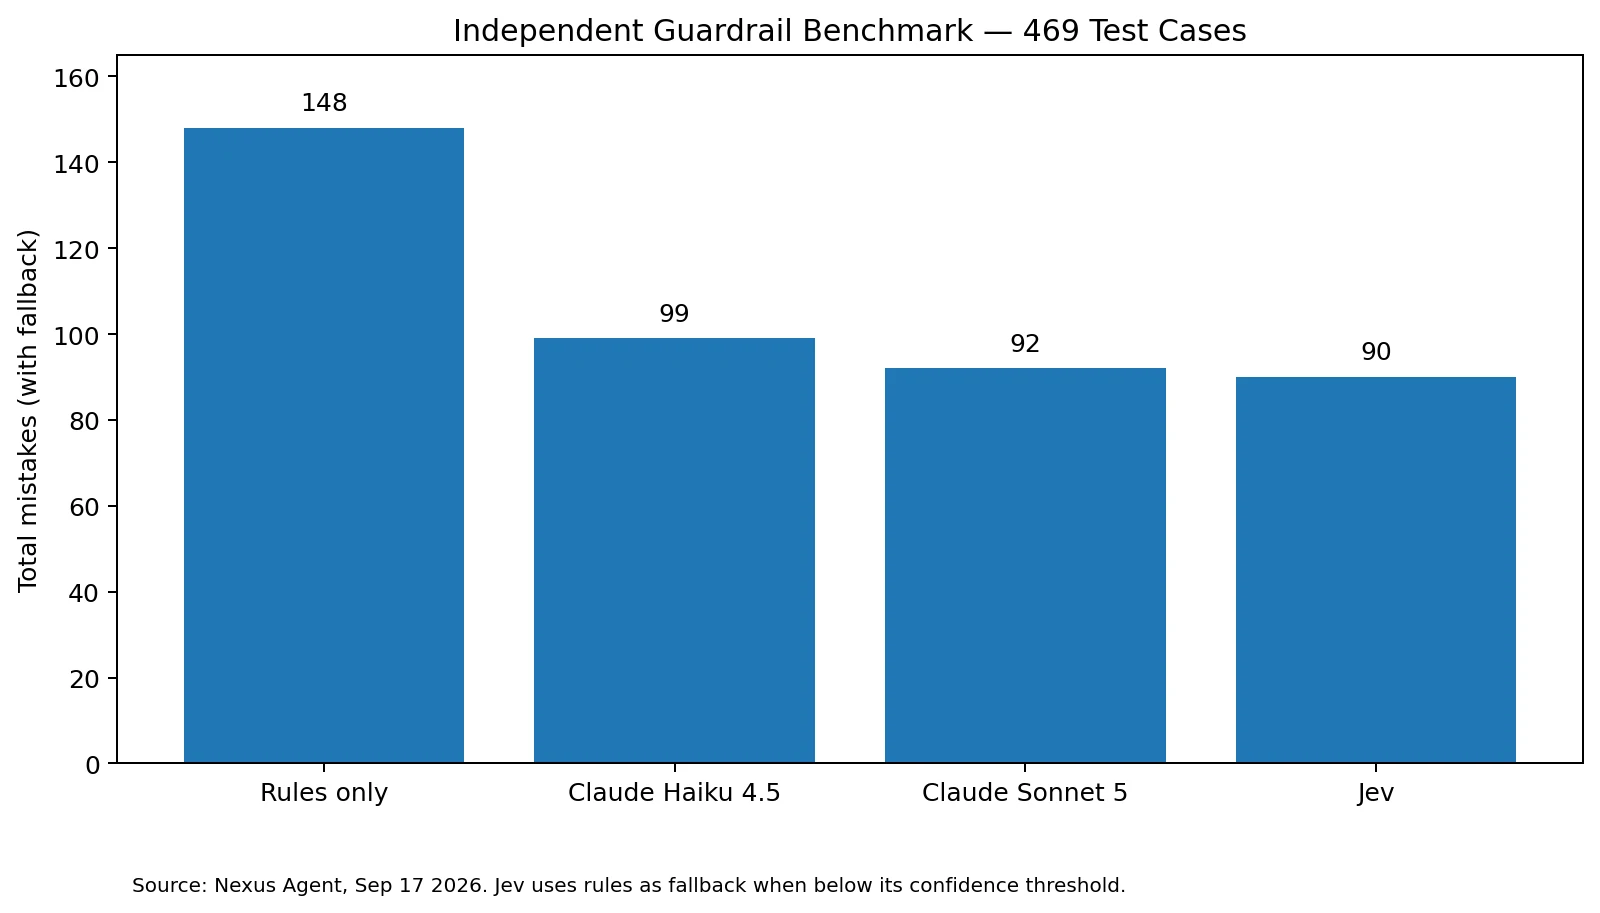
Figura 1. Errores totales con fallback. Fuente: Nexus Agent, 17 de septiembre de 2026.
El dato crucial es la cobertura: 1,8% de error cuando decide no significa precisión universal. El patrón útil es responder solo cuando hay confianza y escalar lo incierto a reglas, un modelo más fuerte o una persona.
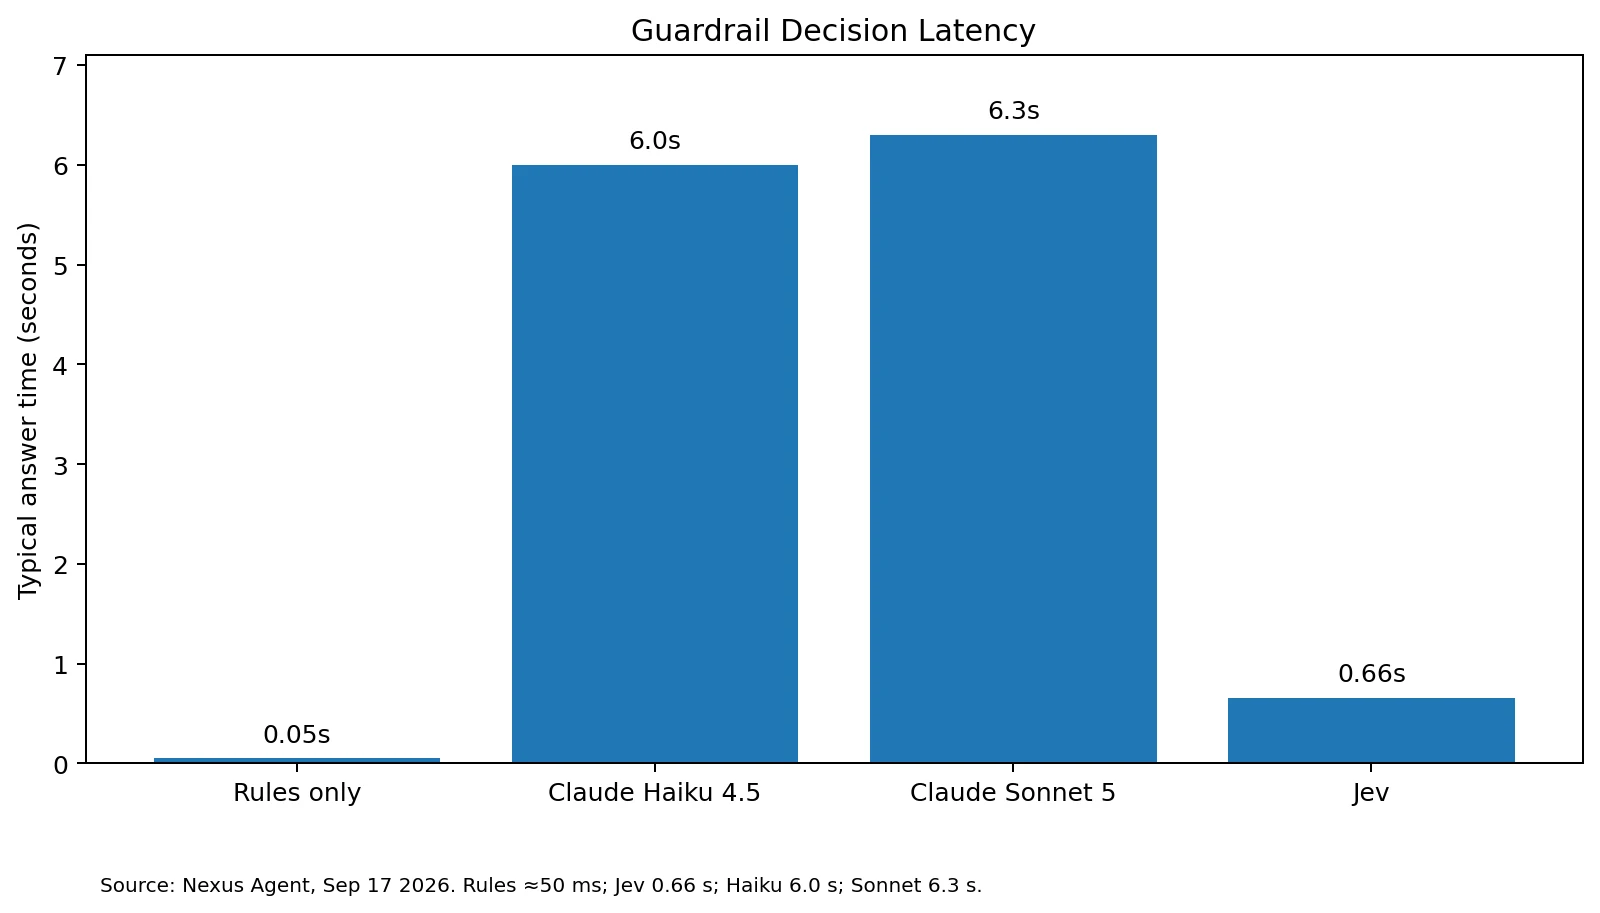
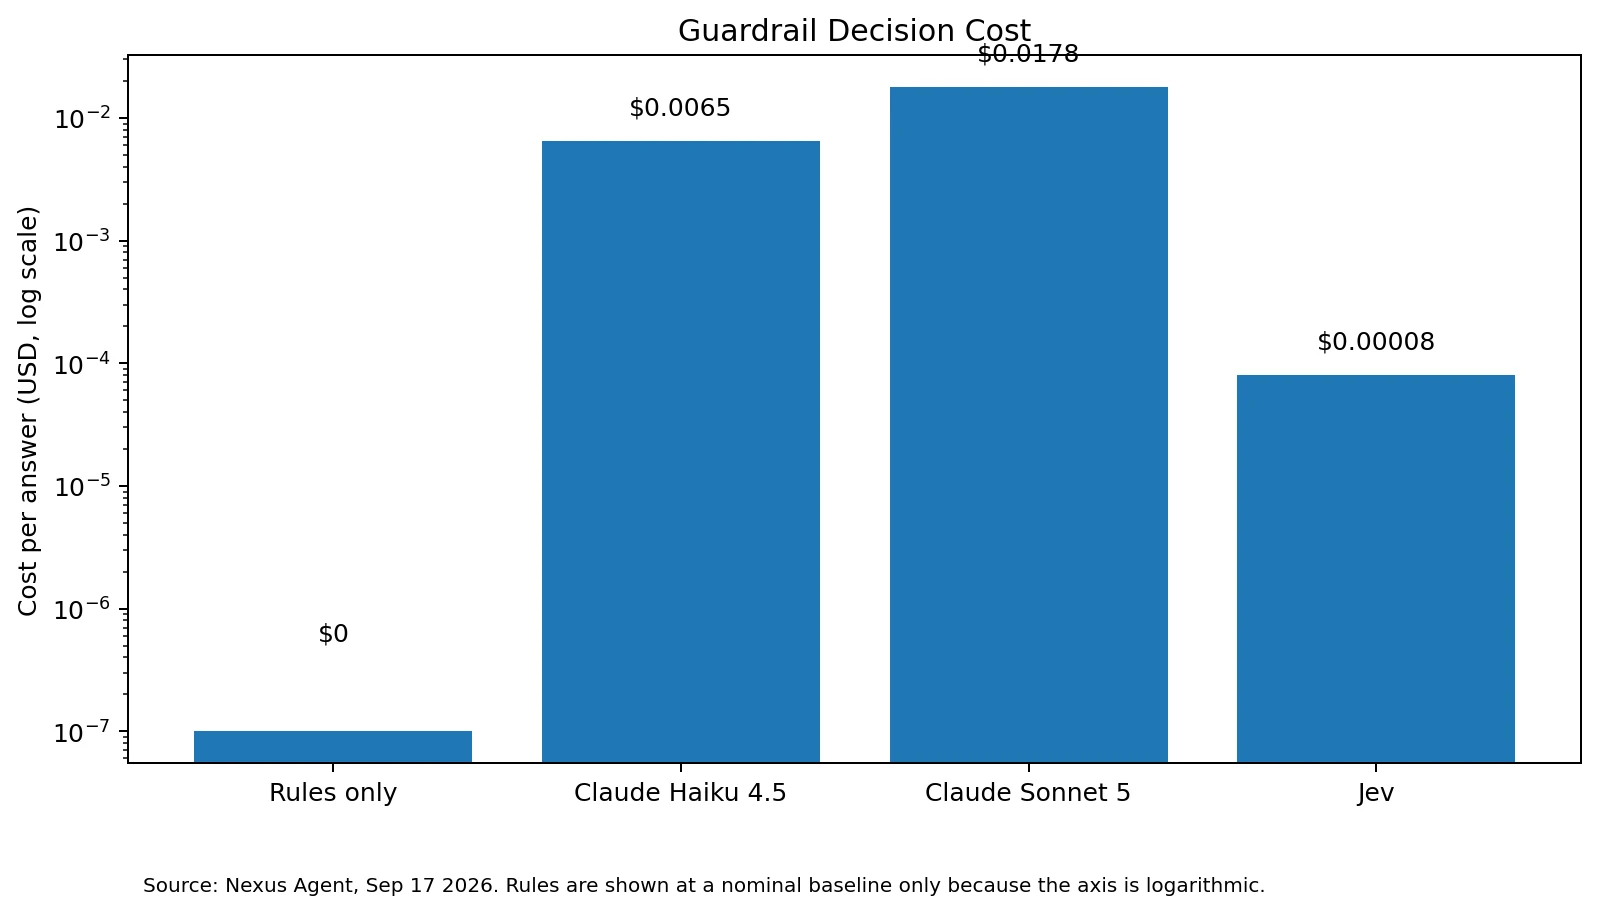
Nexus informa una latencia mediana de 0,68 segundos y un coste de 0,00008 USD por decisión para Jev en ese escenario.
Dónde puede importar
En un SOC, un modelo de decisión podría clasificar antes los eventos: benignos, inciertos y de alto riesgo. No sustituye a analistas; reserva el razonamiento caro y la atención humana para los casos donde aportan valor.
También puede ser una capa de guardrail para agentes de IA. Antes de una acción irreversible, puede estimar si es destructiva, reversible, autorizada y si exige aprobación humana. La política puede bloquear la acción aunque el modelo razonador principal quiera ejecutarla. El mismo patrón aplica a DLP semántico, phishing, IAM, fraude y priorización de vulnerabilidades.
Tipado no significa corrección
Que Jev no pueda devolver una salida fuera del esquema es valioso, pero no demuestra que la decisión sea correcta. Puede devolver ALLOW cuando debía devolver BLOCK. Para seguridad, estos modelos son sensores probabilísticos, no motores de política infalibles.
decisión + confianza → política de seguridad
alta confianza y bajo impacto → automatizar
incertidumbre → investigar
alto impacto o irreversibilidad → controles y autorización más fuertes
El coste de equivocarse debe fijar el umbral: borrar spam y borrar una base de datos de producción nunca deben compartirlo.
La pregunta correcta
Jev no reemplaza modelos de razonamiento, investigación profunda ni juicio humano. Es una posible capa especializada entre detección, razonamiento, verificación, política y acción.
Es demasiado pronto para llamarlo un avance definitivo: las cifras más espectaculares siguen siendo del proveedor y el estudio de Nexus cubre un entorno concreto. Pero la pregunta es relevante: ¿qué decisiones de seguridad son hoy demasiado frecuentes, rápidas o baratas para justificar IA, y qué cambia si esa restricción desaparece?
Evaluación editorial: las implementaciones críticas deben conservar límites de autorización deterministas, verificación independiente, fallbacks y revisión humana para acciones consecuentes.
Fuentes





