Gemini 4 Carbon : des benchmarks aux preuves AppSec
Transformez les scores de sécurité IA en une évaluation cadrée, avec constats reproductibles, correctifs revus et tests du déploiement.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestLe 28 octobre, Google a publié des résultats de sécurité pour Gemini 4 Carbon : 88,2 % sur SEC-bench Pro, 54,8 % sur ExploitGym et 71,0 % sur CWE-bench. Google précise avoir évalué ces benchmarks externes sans garde-fous. Le déploiement annoncé commence avec des défenseurs sélectionnés via Fairwind ; l’annonce n’établit pas un accès général pour les développeurs.
Ces résultats sont déclarés par le fournisseur. Votre application exige un autre dossier de validation : cible autorisée, défaut observé, correctif et résultat du même test après modification. Un score peut orienter une sélection. Une décision de déploiement exige des preuves liées à votre système.
Comprendre la tâche avant de comparer les scores
Les trois pourcentages concernent des tâches différentes. Ils ne décrivent pas des étapes successives sur un même ensemble de vulnérabilités en production.
| Benchmark cité par Google | Résultat déclaré | Question pour votre évaluation |
|---|---|---|
| SEC-bench Pro | 88,2 % | Quelle cible, version des tâches et vérification définissent une découverte valide ? |
| ExploitGym | 54,8 % | Quelles informations initiales, conditions et règles définissent une exploitation ? |
| CWE-bench | 71,0 % | Quels contrôles démontrent que le correctif résout le problème sans casser le comportement légitime ? |
Le projet SEC-bench, le dépôt ExploitGym et le site CWE-bench documentent leurs propres méthodes. Leur page publique actuelle ne démontre pas la version, le dénominateur ou la configuration utilisés par Google. Nous n’avons pas reproduit indépendamment les résultats de Carbon.
Faire la moyenne produirait une mesure sans définition. Multiplier les scores supposerait un échantillon et un parcours communs que l’annonce n’établit pas. Conservez chaque résultat avec sa tâche et ses conditions.
Délimiter la cible de l’évaluation
Commencez par un parcours applicatif important. Identifiez la révision déployée, les comptes de test, les interfaces autorisées et les exclusions. Utilisez des données synthétiques. Définissez qui peut arrêter l’exercice et quelles actions exigent une autorisation supplémentaire. Un nom d’hôte ne suffit pas à décrire le périmètre.
Choisissez un cas de régression connu et un parcours métier représentatif. Le premier vérifie si l’évaluation retrouve un défaut dont les conditions sont comprises. Le second vérifie si le résultat répond à votre décision concrète. Aucun ne prouve une couverture totale.
Notre parcours Proof-Driven AppSec applique cette discipline : un constat doit permettre de répéter l’observation dans les mêmes conditions autorisées.
Relier découverte, validation et correction
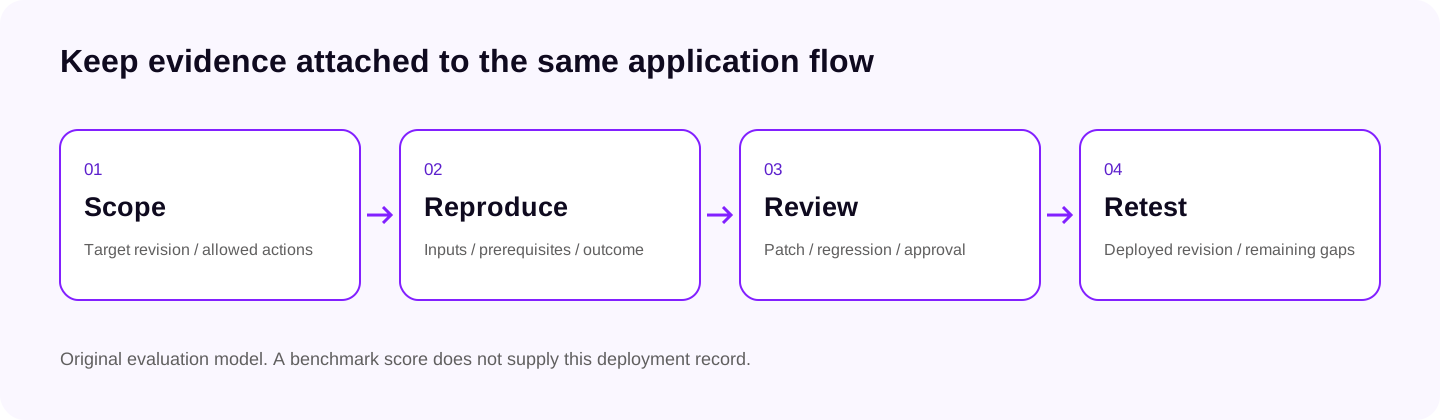
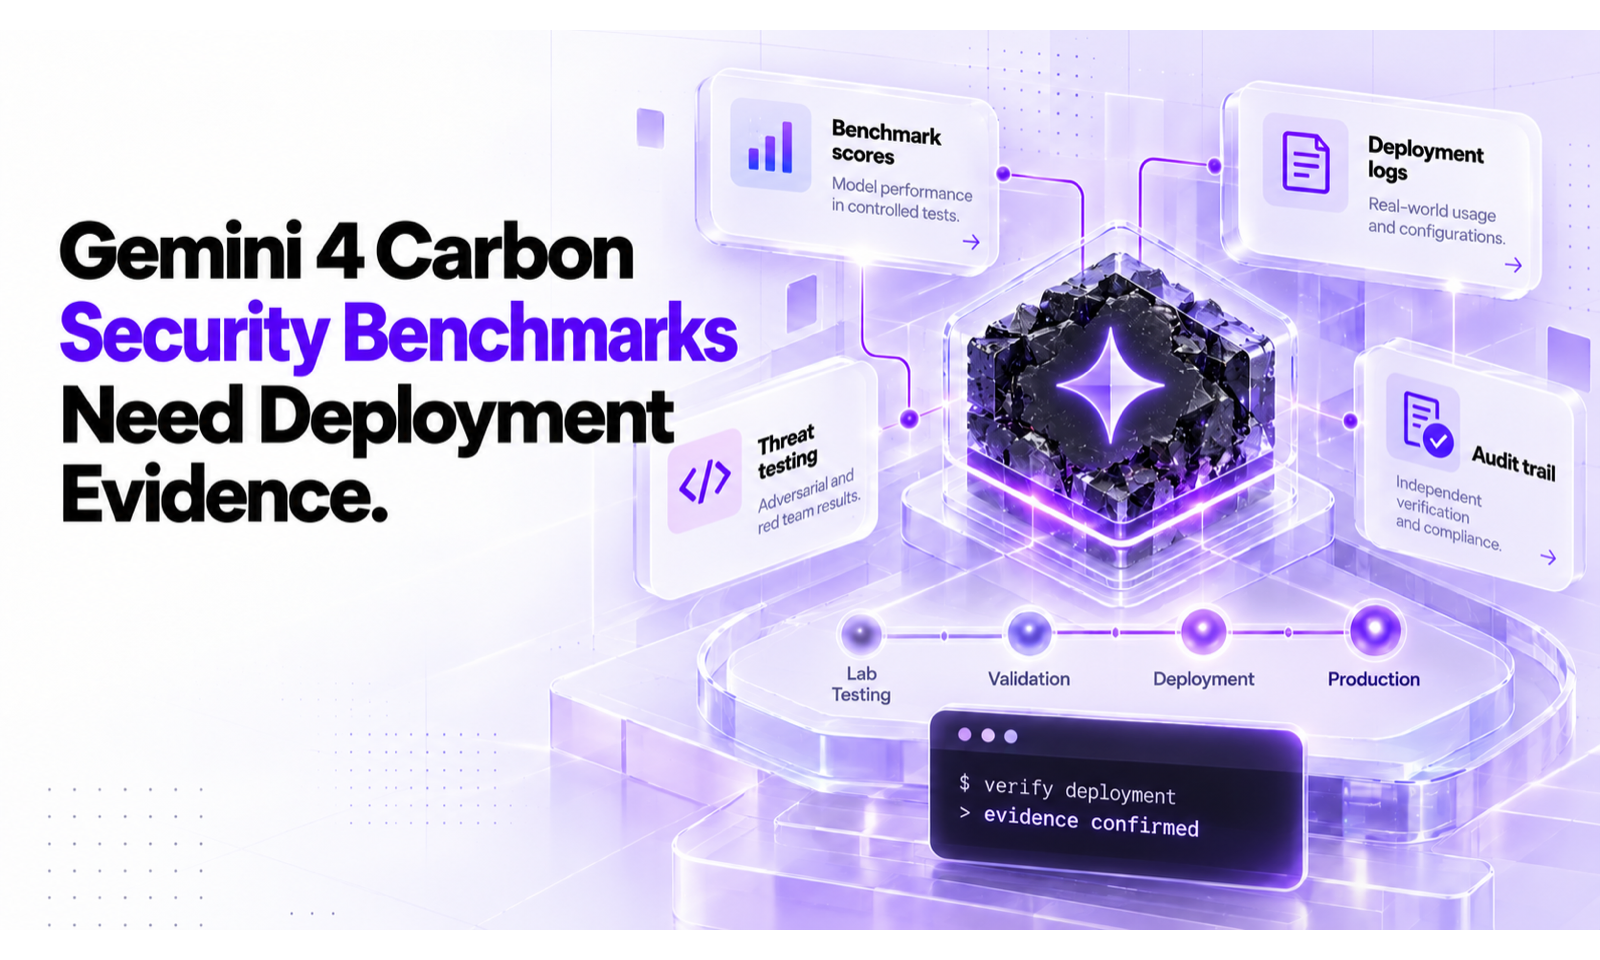
Modèle original d’évaluation. Il ne représente pas le système de benchmarks de Google et n’affirme pas que Plexicus utilise Carbon.
Pour la découverte, conservez l’entrée pertinente, l’emplacement du code ou l’endpoint et le raisonnement qui les relie. Signalez l’incertitude. Un motif suspect peut rester une hypothèse utile sans constituer un constat reproduit.
Pour la validation, conservez la reproduction minimale et inoffensive du comportement annoncé. Notez permissions, configuration et entrées accessibles. Un timeout, un outil bloqué ou une dépendance absente donnent un résultat incomplet. Ils ne prouvent pas que l’application résiste.
Pour la correction, exigez un diff révisable, un test du défaut initial et des contrôles du comportement légitime. Répétez l’observation sur le déploiement corrigé. Distinguez l’impossibilité de reproduire d’une preuve que la cause a disparu. Notre guide de remédiation explique le passage du changement proposé à l’approbation.
Conserver les conditions qui changent le résultat
Le modèle est une partie du système d’évaluation. Outils, permissions, contexte, budget de temps et environnement influencent aussi le résultat. Conservez ces paramètres pour permettre une revue ultérieure.
Un benchmark sans garde-fous ne démontre pas le comportement d’une configuration produit soumise à d’autres contraintes. Une action permise en laboratoire n’autorise pas son exécution chez un client. Définissez les actions permises avant le test et signalez ensuite le travail bloqué.
Le dossier de preuve doit contenir :
- Révision cible, configuration et périmètre autorisé.
- Modèle, outils, budget et restrictions pertinentes.
- Entrées de reproduction, prérequis et résultat observé.
- Correctif revu, régression et contrôles du parcours légitime.
- Révision déployée, résultat du nouveau test et questions ouvertes.
Ce dossier reste utile lorsque le modèle change. Il rend aussi visibles les lacunes masquées par un score. La distinction entre analyse et résultat vérifié est centrale dans Deep Code Analysis.
Définir un résultat révisable avec Plexicus
Plexicus présente AI Swarm Pentest comme une évaluation cadrée des applications et API. Son parcours de remédiation décrit des correctifs révisables et des tests de vérification. Apportez un parcours précis et un contrat de preuve. Clarifiez quelles observations, modifications et traces de nouveau test entrent dans le périmètre convenu.
Cet article n’établit ni intégration Carbon, ni reproduction de ses benchmarks, ni comparaison de performances entre Plexicus et Google. La question pratique est de savoir si votre évaluation fournit des preuves que vos ingénieurs peuvent examiner pour approuver un changement.
Vous souhaitez évaluer un parcours applicatif ? Contactez Plexicus avec la cible autorisée et le résultat à vérifier.
Sources