¿Qué es Deep Code Analysis? (Y por qué SAST + LLM no es suficiente)
SAST por regex te da miles de hallazgos teóricos. La revisión asistida por LLM te da reescrituras convincentes que quizá ni siquiera compilan. Deep Code Analysis es la tercera capa: un modelo estructural de tu código que demuestra qué hallazgos son reales, alcanzables y vale la pena corregir.
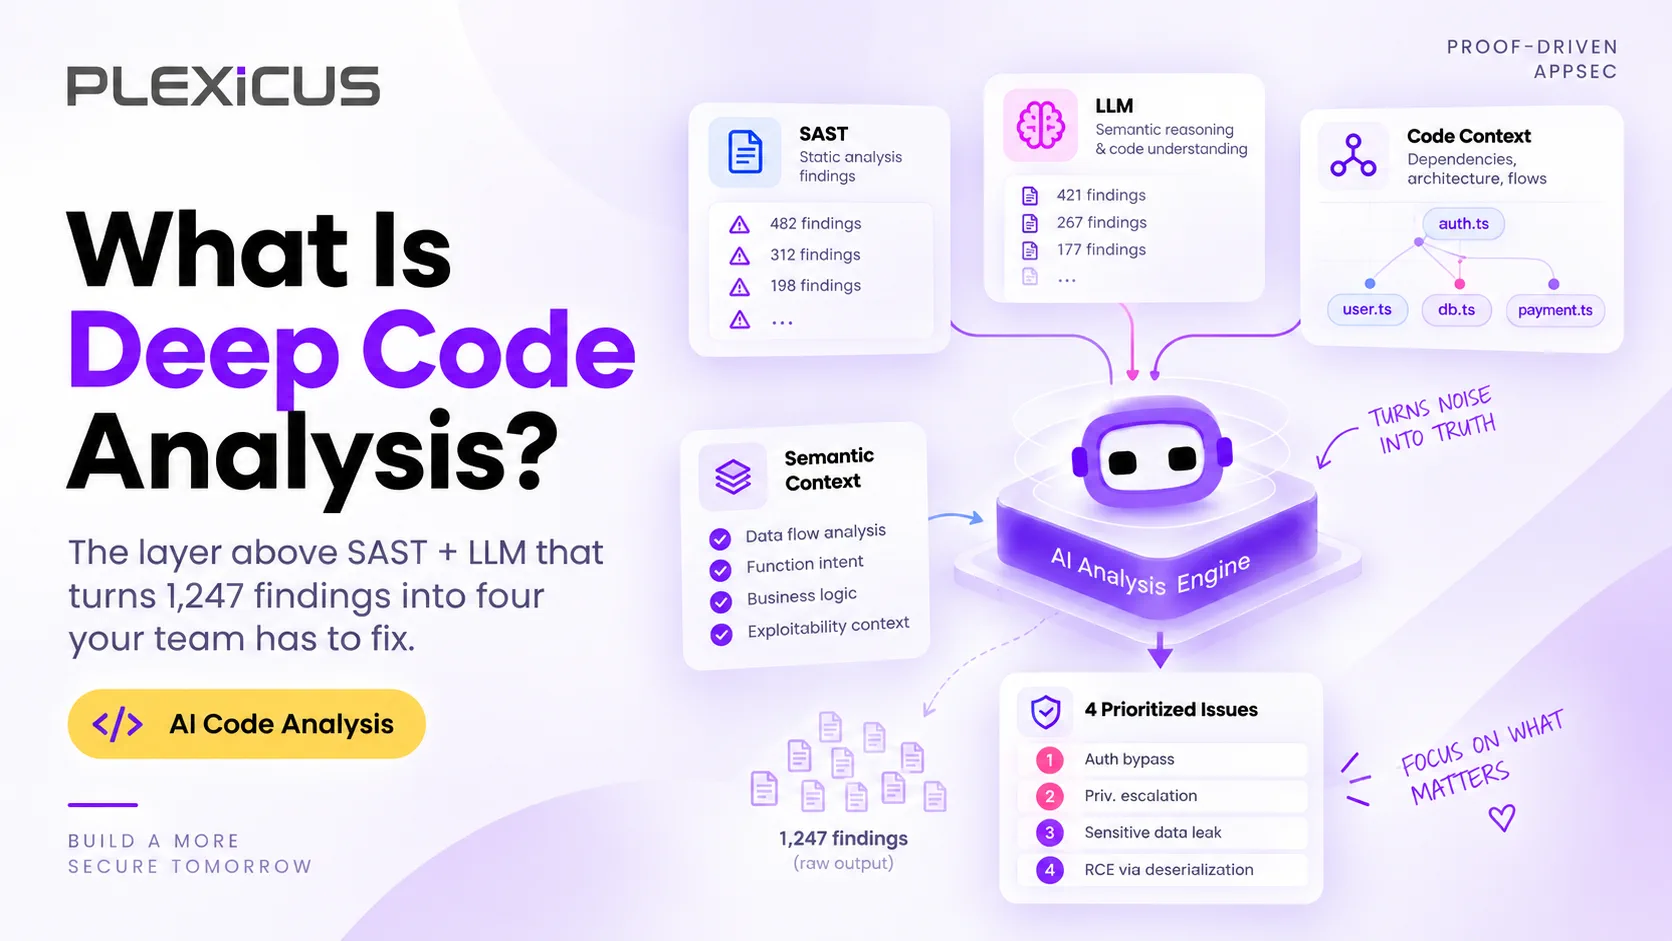
Si alguna vez has abierto un dashboard de SAST, te has desplazado hasta el final de un CSV de 12 000 líneas y has pensado “jamás voy a triar todo esto”, ya entiendes el problema que Deep Code Analysis está diseñada para resolver. También entiendes por qué ponerle un modelo de lenguaje al mismo motor de regex no lo arregla.
Esta guía explica qué es realmente Deep Code Analysis, por qué SAST más un wrapper de LLM sigue dejándote con miles de hallazgos incorregibles y qué cambia cuando pones una capa estructural delante de tus escáneres. Si ya conoces la diferencia entre SAST, DAST y SCA, salta a la sección sobre cómo es la capa por encima de todos.
La versión corta
Deep Code Analysis es la práctica de construir un modelo estructural de los hosts, endpoints, parámetros y capacidades de tu aplicación, y vincular cada hallazgo de seguridad a un punto concreto de ese modelo. Un hallazgo sin camino de alcanzabilidad, sin clase de capacidad y sin número de línea no es un hallazgo. Es ruido.
Esto es lo que separa la práctica del SAST tradicional y de los productos “SAST + LLM” que inundaron el mercado en 2024–2025. Ambos son comparadores de patrones por debajo. Uno usa regex. El otro usa un transformer que resume la salida del regex en mejor inglés.
Ninguno responde la única pregunta que le importa a tu equipo de seguridad:
De los miles de vulnerabilidades que acaba de encontrar mi escáner, ¿cuáles puede explotar realmente un atacante contra el código de producción que desplegamos el martes pasado?
Deep Code Analysis responde esa pregunta. Todo lo demás es fontanería.
Lo que el SAST hizo mal
SAST — Static Application Security Testing — ha sido el caballo de batalla de la seguridad de aplicaciones desde principios de los 2000. La categoría se ganó su lugar. Pero los motores no han cambiado mucho. La mayoría siguen funcionando así:
- Parsean el archivo de código.
- Aplican un conjunto de expresiones regulares o visitantes de AST que buscan patrones conocidos como malos (
eval,innerHTML,string.format, credenciales hardcodeadas, criptografía débil y unos cientos más). - Emiten un hallazgo con una puntuación CVSS, un CWE, una ruta de archivo y un número de línea.
Ese modelo tiene tres problemas estructurales que ninguna cantidad de “IA mejorada” puede disimular.
Problema 1 — Los comparadores de patrones no leen código
Un regex ve eval(input) y lo marca. No ve que input ya está saneado dos funciones más arriba en la pila de llamadas. No ve que esa rama concreta solo es alcanzable desde un endpoint de configuración vinculado a localhost. No ve la cláusula de guarda que tu ingeniero senior añadió hace seis meses.
El resultado: la mayoría de los hallazgos de SAST son inalcanzables, de bajo impacto o ya mitigados. Los fallos interesantes —autorización a nivel de objeto rota, límites de velocidad faltantes, un fallo de lógica de negocio en el nuevo webhook de Stripe— son exactamente los que el regex no detecta.
Problema 2 — No hay modelo de alcanzabilidad
Un hallazgo en la línea 117 de src/routes/users.js no significa nada sin saber cómo llega a ella la entrada del usuario, qué hace una vez allí y si la ruta está expuesta siquiera.
El SAST tradicional se queda en el punto de la llamada. No puede decirte:
- Qué ruta HTTP sirve esta función
- Si la ruta está expuesta públicamente o solo detrás de una VPN
- Si la autenticación se ejecuta antes del punto de llamada
- Si el parámetro de entrada realmente lo controla el usuario
- Si el sumidero de datos al que llega (una base de datos, un shell, un archivo) es explotable desde ese punto de entrada concreto
Recibes un hallazgo. No recibes un camino.
Problema 3 — No hay modelo de capacidades
Leer un archivo no es lo mismo que obtener una identidad. El alcance de red no es lo mismo que la ejecución de código. Llegar a una consulta parametrizada no es lo mismo que llegar a una no saneada.
El SAST tradicional colapsa estas distinciones en una única puntuación de severidad. Trata cada readFile igual, sin importar si el archivo es un asset estático o una clave privada. Eso convierte la lista de prioridades en algo inútil.
Lo que añadir un LLM al SAST no arregló
En 2024, la respuesta obvia al ruido de SAST fue añadir un modelo de lenguaje grande. Envolver el escáner en un agente. Pedirle al modelo que resumiera el hallazgo, sugiriera un parche o clasificara los hallazgos por “explotabilidad real”.
Eso ayudó en una cosa: el muro de CSV se convirtió en un muro de resúmenes legibles. No resolvió ninguno de los tres problemas estructurales anteriores. Solo los hizo más legibles.
Los límites duros siguen ahí:
- Los LLMs no ejecutan código de forma fiable. Cuando un LLM “revisa” un fragmento, está comparando patrones sobre tokens. No ejecuta el programa. No puede demostrar que el fragmento es alcanzable, solo que parece del tipo que a menudo lo es.
- Los LLMs alucinan las correcciones. Cuando se le pide que parchee una vulnerabilidad, un LLM a veces reescribe el punto de llamada de forma que compila pero ya no coincide con la lógica de negocio original. Un revisor humano tiene que detectarlo. La mayoría de los equipos no pueden revisar cada parche sugerido por la IA.
- Los LLMs heredan los puntos ciegos del SAST. Si el escáner subyacente no ve la autorización a nivel de objeto rota, ninguna cantidad de resumen posterior lo va a producir.
El resultado de la ola “SAST + LLM” fue una señal más convincente, más pulida y todavía sin fundamento. El auditor sigue sin poder re-ejecutar el hallazgo. El desarrollador sigue sin saber si puede confiar en el parche sugerido. El CISO sigue recibiendo un dashboard lleno de checks verdes que no significan nada en producción.
Esto fue lo que creó la demanda de Deep Code Analysis como categoría.
Qué es realmente Deep Code Analysis
Deep Code Analysis parte de un punto distinto. En lugar de “escanea el archivo en busca de patrones malos”, la pregunta es “¿qué es esta aplicación, de arriba abajo, y qué puede alcanzar qué?”.
En concreto, la práctica tiene cuatro cambios:
1. Construir un modelo estructural de la aplicación
La primera pasada recorre toda la base de código (y el IaC que define el runtime) y produce un modelo estructural de la aplicación:
- Hosts — servicios, funciones serverless, APIs de terceros
- Endpoints — rutas HTTP, métodos gRPC, manejadores de colas de mensajes
- Parámetros — cada entrada que cruza el límite de un endpoint
- Capacidades — qué puede leer, escribir, ejecutar, exfiltrar o escalar cada nodo
El modelo es la fuente de verdad. Los hallazgos son posiciones dentro de él, no líneas en un archivo.
2. Vincular cada hallazgo a un camino
Cuando el motor propone un hallazgo (ya venga de un patrón, de un modelo aprendido o de una regla escrita por una persona), debe adjuntar:
- El camino de alcanzabilidad — endpoint, parámetro, manejador, sumidero
- La clase de capacidad — lectura, escritura, impersonation, RCE, exfiltración
- El número de línea — para el revisor humano
Un hallazgo sin los tres se descarta. Esto es lo opuesto al SAST tradicional, que emite un hallazgo cada vez que casa un patrón y deja al humano el descubrimiento del camino.
3. Verificar la alcanzabilidad con una pasada independiente
Esta es la diferencia crítica. El motor que propone el hallazgo no es el mismo que lo confirma. Una segunda pasada re-ejecuta el exploit propuesto contra una copia en sandbox del objetivo. Solo se conservan los hallazgos que se reproducen.
Es la misma lógica que el método científico. Una afirmación no es un hallazgo hasta que sobrevive a una prueba independiente.
4. Entregar al ingeniero un artefacto reproducible
Cada hallazgo que sobrevive viene con evidencia que un auditor puede ejecutar, un desarrollador puede ejecutar y un gate de CI puede ejecutar. Una petición, un script o un estado de sandbox.
Si un hallazgo no se puede reproducir, no es un hallazgo.
La pista de auditoría que un auditor puede leer
La salida de Deep Code Analysis está estructurada para las personas que tienen que defender el trabajo aguas abajo. Para cada hallazgo, el informe incluye:
| Campo | Lo que le dice al auditor |
|---|---|
| Nodo del grafo | Qué host, endpoint, parámetro |
| Camino de alcanzabilidad | La cadena completa de petición a sumidero |
| Clase de capacidad | Lectura, escritura, impersonation, RCE, exfiltración |
| Verificado por | Qué pasada independiente lo reprodujo |
| Referencia de evidencia | La petición, el job o el estado de sandbox para re-ejecutar |
| Líneas | Ruta de archivo y número de línea exactos |
| Tainted via | Cómo fluye la entrada del usuario por el sistema |
Un auditor que lee esto puede re-ejecutar el hallazgo, comprobar la traza y confirmar la severidad. No tiene que fiarse de la palabra del proveedor.
Por qué las herramientas solo-LLM no pueden alcanzarlo
La tentación es asumir que, a medida que los modelos fundacionales mejoren, el wrapper “SAST + LLM” acabará siendo equivalente a Deep Code Analysis. No lo será, por tres razones:
- Los LLMs no construyen modelos estructurales. Los consumen como entrada. Sin el paso previo de construcción del modelo, el LLM está resumiendo texto plano e inventando el camino entre dos nodos.
- Los LLMs no pueden verificar sus propios hallazgos. El paso de verificación requiere ejecutar código contra el objetivo. Los LLMs no ejecutan código de forma fiable, y sus chequeos de autoconsistencia son más débiles que una pasada de reproducción independiente.
- Los LLMs alucinan la lógica de negocio. Un LLM no sabe que
/api/users/:iddebe imponer la propiedad del registro antes de devolverlo. El modelo estructural codifica esa restricción a nivel de endpoint. El modelo de lenguaje no puede inferirla a partir de estadísticas de tokens.
Deep Code Analysis no sustituye al LLM. Le da al LLM la entrada estructurada que necesita para ser útil — y le da al ingeniero la verdad fundamental que necesita para confiar en las sugerencias del modelo.
Cómo se complementa Deep Code Analysis con AI Swarm Pentest
En Plexicus, Deep Code Analysis es la primera mitad del ciclo. AI Swarm Pentest es la segunda. Juntas se ven así:
- Deep Code Analysis construye el modelo estructural y propone hallazgos.
- AI Swarm Pentest sondea cada hallazgo propuesto dentro del alcance acordado.
- Una pasada independiente re-ejecuta el exploit original contra el parche propuesto y exige evidencia.
- Solo entran en el informe los hallazgos que sobreviven a ambas pasadas — proponer y verificar.
Lo que sobrevive es pequeño, preciso y reproducible. Tu equipo corrige un puñado de cosas en lugar de triar miles. Tu auditor re-ejecuta un puñado de reproducciones en lugar de leer un PDF de 90 páginas.
Esa es la barra. Todo lo demás es ruido.
La pregunta práctica: ¿es solo marketing?
La respuesta honesta es: hace un año, lo era en parte. La categoría no tenía nombre, los productos que decían hacerlo estaban envolviendo motores de regex en resúmenes de LLM, y la prueba de “profundidad” era un PDF más largo.
En 2026, la práctica ha convergido en cuatro señales operativas:
- La herramienta puede responder “¿es alcanzable?” con un camino, no con una suposición. Si tu escáner actual no puede, no está haciendo Deep Code Analysis.
- La herramienta puede responder “¿cuál es la clase de capacidad?” con una taxonomía real. No CVSS. No “alto/medio/bajo”. Una capacidad.
- La herramienta puede producir un artefacto reproducible para cada hallazgo que sobrevive. Ejecutable por un auditor, un gate de CI y un desarrollador.
- La herramienta combina proponer y verificar. Quien propone el hallazgo no es lo mismo que lo confirma.
Si tu stack actual cumple las cuatro, ya tienes Deep Code Analysis — llámelo como lo llame el proveedor. Si cumple tres, estás cerca. Si cumple dos o menos, tienes un dashboard de SAST con mejor copy.
Por dónde empezar
Si quieres ver la diferencia, no necesitas una evaluación de seis meses. Elige un repositorio, una rama, un build parecido al de producción. Ejecuta tu escáner actual. Cuenta los hallazgos. Luego ejecuta una pasada de Deep Code Analysis contra el mismo objetivo. Cuenta los hallazgos que sobreviven a la reproducción independiente.
La distancia entre esos dos números es el presupuesto que llevas gastando en triaje que no necesitaba ocurrir.
Lectura relacionada:
- Deep Code Analysis — página completa del producto
- El 78% de los PRs generados por IA contienen una vulnerabilidad — cómo es realmente la tasa de fallo en producción
- El playbook de remediación autónoma — qué ocurre después de que un hallazgo sobrevive a la reproducción