Gemini 4 Carbon: de los benchmarks a pruebas AppSec
Convierte los resultados de seguridad de IA en una evaluación con hallazgos reproducibles, cambios revisados y pruebas del despliegue.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestEl 28 de octubre, Google publicó resultados de seguridad de Gemini 4 Carbon: 88,2 % en SEC-bench Pro, 54,8 % en ExploitGym y 71,0 % en CWE-bench. Google indica que evaluó estos benchmarks externos sin guardrails. El despliegue anunciado empieza con defensores seleccionados mediante Fairwind; el anuncio no establece un acceso general para desarrolladores.
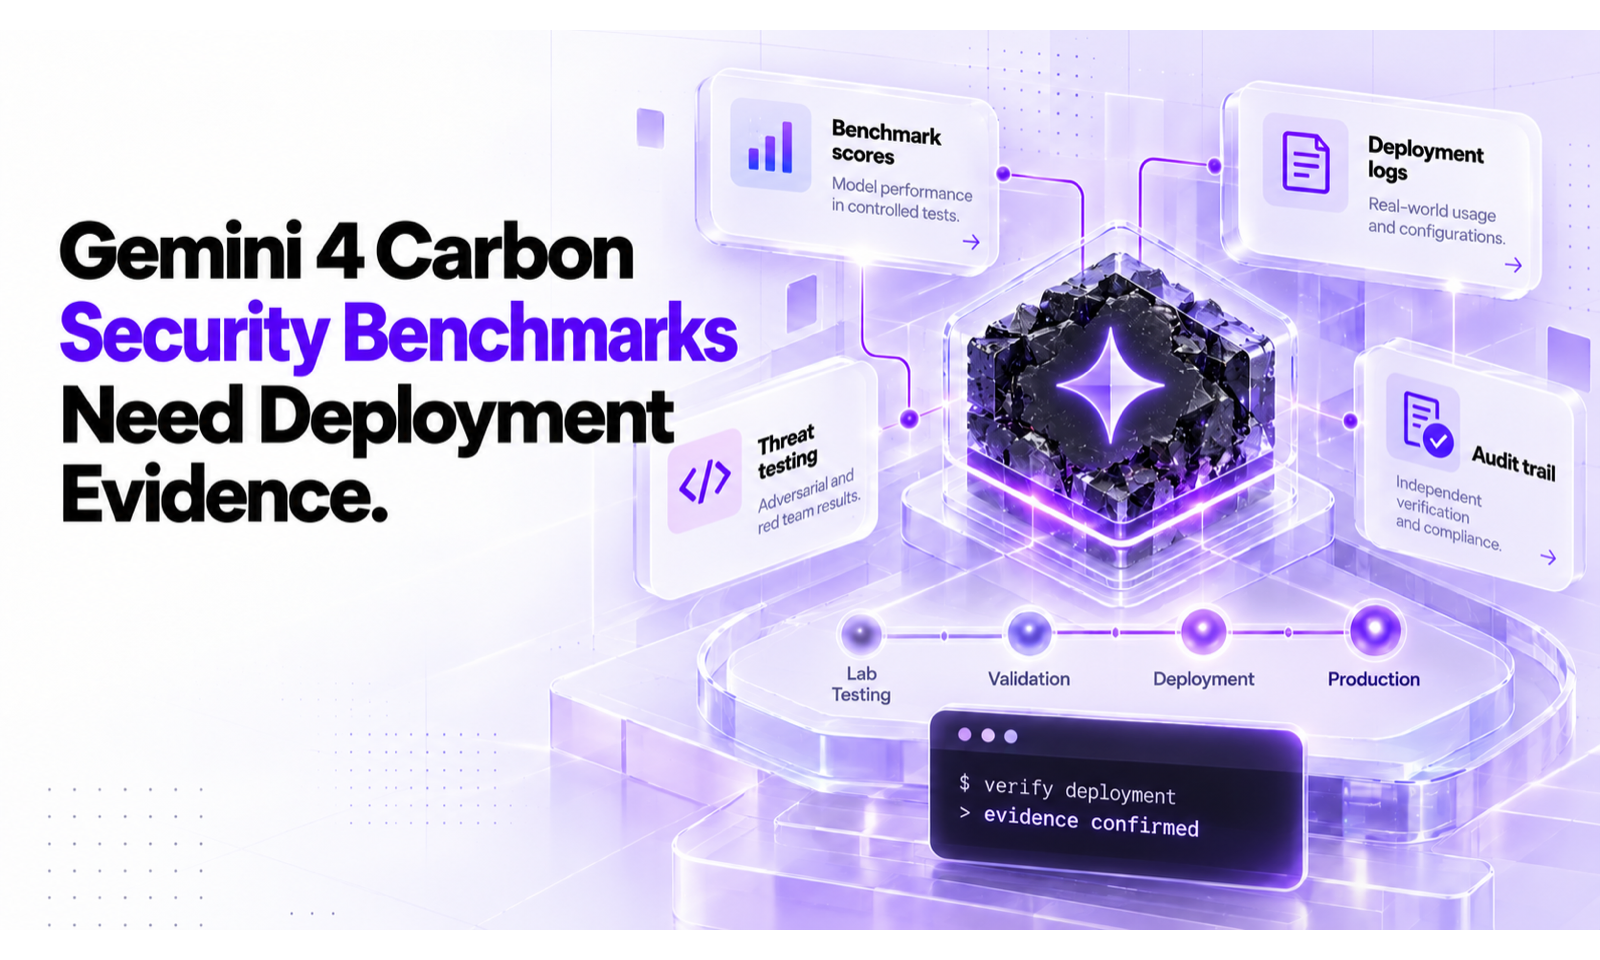
Son resultados comunicados por el proveedor. Tu aplicación necesita otro registro de aceptación: el objetivo autorizado, el fallo observado, el cambio y el resultado al repetir la prueba. Una puntuación puede orientar una selección. Para aprobar un despliegue necesitas evidencia de tu sistema.
Entiende la tarea antes de comparar porcentajes
Los tres porcentajes corresponden a tareas distintas. No representan etapas sucesivas de un mismo conjunto de vulnerabilidades en producción.
| Benchmark citado por Google | Resultado comunicado | Pregunta para tu evaluación |
|---|---|---|
| SEC-bench Pro | 88,2 % | ¿Qué objetivo, versión de tareas y verificador definen un descubrimiento válido? |
| ExploitGym | 54,8 % | ¿Qué información inicial, entorno y criterio definen una explotación? |
| CWE-bench | 71,0 % | ¿Qué comprobaciones demuestran que el cambio corrige el fallo y conserva el comportamiento? |
El proyecto SEC-bench, el repositorio ExploitGym y la web de CWE-bench documentan sus propios diseños. Una página pública actual no demuestra qué versión, denominador o configuración usó Google. No hemos reproducido de forma independiente los resultados de Carbon.
Promediar los porcentajes crearía una métrica sin significado definido. Multiplicarlos supondría una muestra y un flujo comunes que el anuncio no establece. Conserva cada resultado junto a su tarea y condiciones.
Delimita el objetivo de la evaluación
Empieza por un flujo de aplicación relevante. Identifica la revisión desplegada, las cuentas de prueba, las interfaces permitidas y las exclusiones. Usa datos sintéticos. Define quién puede detener el ejercicio y qué acciones necesitan autorización adicional. Un nombre de host no basta para describir el alcance.
Elige un caso de regresión conocido y un flujo de negocio representativo. El primero comprueba si la evaluación recupera un fallo cuyas condiciones conoces. El segundo comprueba si el resultado responde a la decisión de tu equipo. Ninguno demuestra cobertura completa.
Es la disciplina de nuestro flujo Proof-Driven AppSec: el hallazgo debe permitir repetir la observación bajo las mismas condiciones autorizadas.
Conecta descubrimiento, validación y corrección
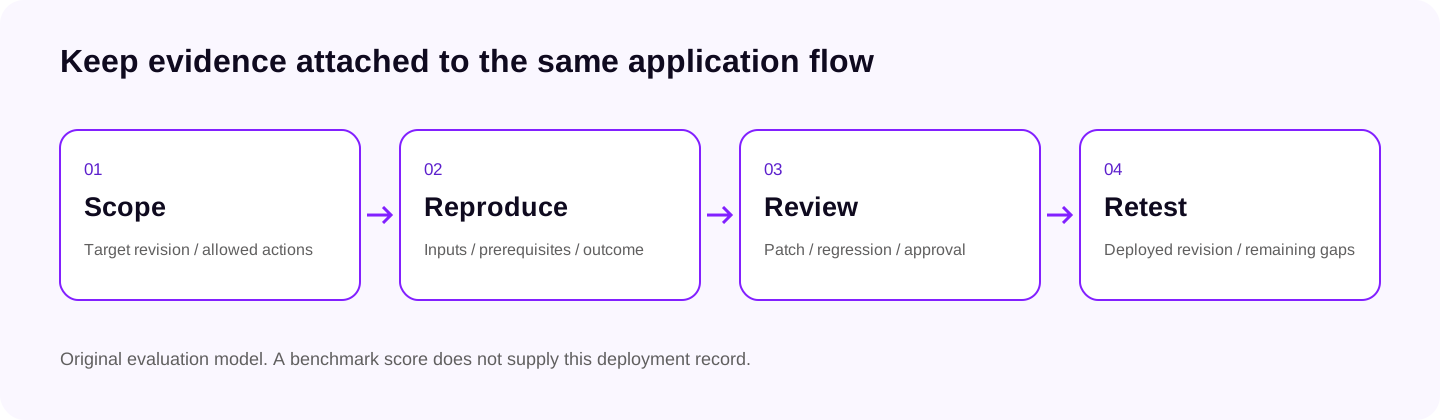
Modelo original de evaluación. No representa el sistema de benchmarks de Google ni afirma que Plexicus use Carbon.
En el descubrimiento, conserva la entrada relevante, la ubicación de código o el endpoint y el razonamiento que los conecta. Expresa la incertidumbre. Un patrón sospechoso puede ser una hipótesis útil sin ser todavía un hallazgo reproducido.
En la validación, conserva la reproducción mínima e inocua que demuestre el comportamiento. Registra permisos, configuración y entradas accesibles. Un timeout, una herramienta bloqueada o una dependencia ausente son resultados incompletos. No demuestran resistencia al ataque.
En la corrección, exige un diff revisable, una prueba del fallo original y comprobaciones del comportamiento legítimo. Repite la observación contra el despliegue corregido. Distingue entre no reproducir un fallo y demostrar que se eliminó su causa. Nuestro manual de remediación explica el paso desde el cambio propuesto hasta la aprobación.
Conserva las condiciones que cambian la respuesta
El modelo solo es una parte del sistema. Las herramientas, permisos, contexto, presupuesto de tiempo y entorno también condicionan el resultado. Guarda esa configuración para que otra persona entienda qué se probó.
Una evaluación sin guardrails no demuestra cómo se comportará una configuración con restricciones distintas. Una acción permitida en laboratorio tampoco autoriza ejecutarla contra un cliente. Define las acciones permitidas antes de empezar e informa después de los trabajos bloqueados.
El paquete de evidencia debe incluir:
- Revisión, configuración y alcance autorizado del objetivo.
- Modelo, herramientas, presupuesto y restricciones relevantes.
- Entradas de reproducción, requisitos y resultado observado.
- Cambio revisado, prueba de regresión y comprobaciones del flujo legítimo.
- Revisión desplegada, resultado de la nueva prueba y dudas abiertas.
Este paquete conserva su utilidad al cambiar de modelo y hace visibles los huecos que oculta una puntuación. La diferencia entre análisis y resultado verificado también guía Deep Code Analysis.
Define con Plexicus un resultado revisable
Plexicus presenta AI Swarm Pentest como una evaluación delimitada de aplicaciones y API. Su flujo de remediación describe cambios revisables y nuevas pruebas de verificación. Lleva un flujo concreto y un contrato de evidencia. Aclara qué observaciones, cambios y registros de verificación incluye el alcance acordado.
Este artículo no demuestra una integración con Carbon, una reproducción de sus benchmarks ni una comparación de rendimiento entre Plexicus y Google. La pregunta práctica es si tu evaluación produce evidencia que tus ingenieros puedan inspeccionar y usar para aprobar un cambio.
¿Quieres evaluar un flujo de aplicación? Contacta con Plexicus con el objetivo autorizado y el resultado que necesitas verificar.
Fuentes