¿Qué es SAST? La guía completa de pruebas estáticas de seguridad de aplicaciones para 2026
Una guía completa de SAST en 2026: cómo funciona el análisis estático, qué detecta y qué se le escapa, por qué produce falsos positivos y cómo convertir un hallazgo en una prueba.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestTodo fallo de seguridad en tu propio software empieza como una línea de código.
Las pruebas estáticas de seguridad de aplicaciones son una de las formas automatizadas más antiguas de buscar esas líneas antes de que nadie ejecute el programa.
SAST analiza el código fuente, el bytecode o los binarios sin ejecutar la aplicación, e informa de patrones de código y flujos de datos que pueden dar lugar a una vulnerabilidad, junto con el archivo y la línea donde se encuentran.
OWASP describe estas herramientas del mismo modo: las herramientas de análisis de código fuente, también conocidas como herramientas SAST, analizan el código fuente o versiones compiladas del código para ayudar a encontrar fallos de seguridad. OWASP
La idea es sencilla. La práctica, no.
Una herramienta SAST puede señalar un patrón peligroso en segundos. No siempre puede decirte si un atacante puede llegar a ese patrón, qué datos hay detrás o si la alerta es real.
Esa distancia importa más en 2026. En su Data Breach Investigations Report 2026, Verizon concluyó que la explotación de vulnerabilidades se había convertido en el vector de acceso inicial más común en las brechas que analizó, con un 31 %, frente al 20 % del año anterior.
Esta guía explica qué es SAST, cómo funciona, qué detecta y qué se le escapa, cómo evaluar una herramienta y cómo convertir un hallazgo estático en evidencias sobre las que tu equipo pueda actuar.
¿Qué es SAST?
Las pruebas estáticas de seguridad de aplicaciones (SAST) son un método de pruebas de caja blanca que inspecciona el código de una aplicación, sin ejecutarlo, para encontrar debilidades que podrían convertirse en vulnerabilidades de seguridad.
«Caja blanca» significa que la herramienta ve el interior de la aplicación: los archivos fuente, las funciones, las variables y cómo se mueven los datos entre ellas.
«Estático» significa que no se ejecuta nada. La herramienta lee y modela el código como lo hace un compilador y, después, aplica reglas de seguridad a ese modelo.
Un hallazgo SAST típico responde a cuatro preguntas:
- Qué debilidad se encontró, normalmente asociada a un identificador CWE como CWE-89 (inyección SQL).
- Dónde está: archivo, línea y fragmento de código.
- Cómo llegan a ella los datos no confiables, cuando la herramienta rastrea un flujo de datos.
- Qué gravedad cree la herramienta que tiene.
OWASP cita ese nivel de detalle sobre la ubicación como uno de los principales puntos fuertes del método: la salida de SAST resalta el código problemático por nombre de archivo, ubicación, número de línea e incluso el fragmento afectado. OWASP
Por eso los desarrolladores lo siguen usando. Un hallazgo que apunta a la línea 276 de un archivo es más fácil de abordar que un informe que dice «la página de inicio de sesión es vulnerable».
¿Qué puede analizar una herramienta SAST?
Según la herramienta, SAST trabaja con una o varias de estas entradas:
- Código fuente, la entrada más habitual: Java, Python, JavaScript, Go, C#, PHP, etc.
- Bytecode, como clases Java compiladas o ensamblados .NET.
- Binarios, cuando el código fuente no está disponible.
- Archivos de infraestructura y configuración, en herramientas que amplían el análisis estático a Terraform, Dockerfiles o manifiestos de Kubernetes.
Algunas herramientas necesitan código que compile. OWASP señala que a muchas herramientas SAST les cuesta analizar código que no se puede compilar, y que a menudo los analistas no disponen de las librerías adecuadas, las instrucciones de compilación o el código base completo. OWASP
¿SAST es lo mismo que el análisis estático de código?
Casi.
El análisis estático de código es la técnica general: cualquier lectura automatizada del código sin ejecutarlo, incluidas las comprobaciones de estilo, los buscadores de errores y los comprobadores de tipos.
SAST es análisis estático de código con un objetivo de seguridad. Usa las mismas técnicas de compilador, pero sus reglas buscan vulnerabilidades, no problemas de formato o de rendimiento.
Por qué SAST importa en 2026
SAST no es nuevo. Cuatro tendencias lo hacen más relevante ahora, no menos.
1. Las vulnerabilidades explotadas son la principal vía de entrada
El DBIR 2026 de Verizon sitúa la explotación de vulnerabilidades en el 31 % de las brechas que analizó. El abuso de credenciales, el anterior líder, cayó al 13 %, en parte porque Verizon cuenta ahora el pretexting como un vector aparte. Verizon DBIR
No toda vulnerabilidad explotada es un fallo de código en tu propia aplicación: la cifra del informe abarca vulnerabilidades en cualquier software, incluidos productos de terceros.
Pero la parte que está en tu propio código es la que solo tu equipo puede corregir, y SAST es la primera comprobación automatizada que la lee.
2. Las clases de fallos más antiguas siguen en lo más alto
El 2025 CWE Top 25 Most Dangerous Software Weaknesses, publicado por el programa CWE de MITRE, sitúa el cross-site scripting (CWE-79) en primer lugar y la inyección SQL (CWE-89) en segundo.
Ambos son fallos de inyección que SAST se diseñó para encontrar.
En marzo de 2024, CISA y el FBI publicaron una Secure by Design Alert conjunta sobre la eliminación de la inyección SQL. Señala que la inyección SQL sigue siendo una clase de vulnerabilidad frecuente pese a dos décadas de documentación y de mitigaciones eficaces.
3. Los asistentes de IA escriben más código
Los asistentes de programación con IA escriben código más rápido de lo que las personas pueden revisarlo.
En su 2026 GenAI Code Security Report, publicado en julio de 2026, Veracode informó de que aproximadamente el 44 % de las tareas de generación de código con IA que probó produjeron código con una vulnerabilidad conocida. La tasa media de aprobación en seguridad de los modelos fue del 56 %, casi igual que el 55 % de su primer informe. Son resultados comunicados por un proveedor de seguridad, no una replicación independiente.
Sea cual sea la tasa exacta en tu código base, más código generado significa más código que alguien, o algo, tiene que comprobar.
4. Los marcos de desarrollo seguro piden análisis de código
El Secure Software Development Framework (SP 800-218) del NIST incluye una práctica para revisar o analizar el código legible por humanos con el fin de identificar vulnerabilidades, de modo que se corrijan antes de publicar el software.
La tarea PW.7.2 pide a los equipos realizar la revisión o el análisis de código según sus estándares de programación segura, y registrar y hacer el triaje de todos los problemas detectados y las remediaciones recomendadas en el flujo de trabajo o el gestor de incidencias del equipo.
SAST es una forma habitual de cumplir a escala la mitad de «análisis de código» de esa tarea.
SAST frente a DAST
SAST y DAST son los dos métodos de prueba más conocidos y miran una aplicación desde lados opuestos.
| SAST | DAST | |
|---|---|---|
| Perspectiva | Desde dentro: lee el código | Desde fuera: envía peticiones a una aplicación en ejecución |
| Necesita | Código fuente, bytecode o binarios | Una aplicación desplegada y en ejecución |
| Cuándo | Desde el primer commit | Cuando la aplicación ya está compilada y desplegada en un entorno de pruebas |
| Informa de | Archivo, línea y ruta de código | URL, petición, respuesta y comportamiento observado |
| Punto fuerte | Patrones de inyección, API inseguras, problemas de flujo de datos | Comportamiento en tiempo de ejecución, configuración, respuestas del servidor |
| Punto débil | Contexto de ejecución, configuración, demostrar la explotabilidad | Localizar la línea vulnerable, código al que el rastreador nunca llega |
SAST te dice dónde podría haber una debilidad. DAST te dice qué hace realmente la aplicación en ejecución.
Ninguno sustituye al otro. Para una comparación más detallada, consulta SAST frente a DAST: la diferencia y por qué usar ambos.
SAST frente a SCA
El análisis de composición de software (SCA) examina el código que no escribiste.
Inventaría los paquetes de código abierto y otros componentes de terceros y, después, compara sus versiones con vulnerabilidades conocidas.
SAST examina el código que sí escribiste: tus funciones, tus consultas, tus handlers.
| SAST | SCA | |
|---|---|---|
| Alcance | Código propio | Componentes de terceros y sus versiones |
| Detecta | Fallos de programación, a menudo sin CVE | Vulnerabilidades conocidas, normalmente con CVE |
| Corrección típica | Cambiar tu código | Actualizar, sustituir o parchear el componente |
Necesitas los dos. Una librería vulnerable y un fallo de inyección en tu propio handler son problemas distintos con correcciones distintas.
SAST frente a la revisión manual de código
El SSDF del NIST traza esta línea con claridad. En la tarea PW.7.1, la revisión de código significa que una persona examina directamente el código para encontrar problemas, y el análisis de código significa que se usan herramientas para encontrar problemas en el código, de forma totalmente automatizada o junto con una persona. NIST SP 800-218
Los dos se complementan:
- SAST es rápido, repetible e incansable. Lee cada línea en cada commit.
- Un revisor humano entiende la intención. Se da cuenta de que un endpoint de «eliminar cuenta» nunca comprueba quién lo pide.
El mejor uso de SAST es liberar a los revisores de buscar patrones conocidos para que puedan dedicar su atención al diseño y a la lógica.
Cómo funciona SAST
Cada motor SAST es distinto, pero la mayoría sigue las mismas seis etapas.
1. Analizar el código y convertirlo en un modelo
La herramienta lee cada archivo y lo convierte en una representación estructurada, normalmente un árbol de sintaxis abstracta (AST) y, después, una representación intermedia más próxima a la que usa un compilador.
Primero viene el análisis léxico. OWASP lo describe como la conversión de la sintaxis del código fuente en tokens, para abstraer el código y facilitar su manipulación. OWASP
2. Construir el flujo de control y el flujo de datos
A continuación, la herramienta determina cómo puede ejecutarse el programa.
Un grafo de flujo de control representa el código como bloques básicos conectados por los saltos entre ellos. Después, el análisis de flujo de datos sigue cómo se mueven los valores a través de esos bloques. OWASP
Los mejores motores lo hacen entre funciones, archivos y módulos (análisis interprocedimental), porque las vulnerabilidades reales rara vez caben dentro de una sola función.
3. Marcar fuentes, sumideros y sanitizadores
Aquí entra la seguridad.
- Las fuentes (sources) son los puntos por donde entran datos no confiables: parámetros de la petición, cabeceras, archivos, mensajes.
- Los sumideros (sinks) son operaciones peligrosas: una consulta SQL, un comando de shell, una respuesta HTML, una ruta de archivo.
- Los sanitizadores y las API seguras hacen que los datos sean seguros para un sumidero concreto, o los mantienen fuera de la parte peligrosa de la llamada: codificación de salida, normalización de rutas, consultas parametrizadas.
4. Ejecutar las reglas
El motor aplica su conjunto de reglas al modelo.
Algunas reglas son patrones sencillos («se llama a esta función hash débil»). Otras son reglas de taint: OWASP describe el análisis de taint (contaminación) como la identificación de variables contaminadas con entradas que controla el usuario y su rastreo hasta una función vulnerable, el sumidero; si el valor contaminado llega al sumidero sin sanitizarse, se señala. OWASP
Este es el caso clásico en Java:
// Source: an attacker-controlled request parameter
String username = request.getParameter("username");

// Sink: the value is concatenated into a SQL string
String sql = "SELECT * FROM accounts WHERE username = '" + username + "'";
ResultSet rs = statement.executeQuery(sql);
Una regla de taint ve que username fluye de getParameter a executeQuery sin ningún sanitizador entre medias e informa de una inyección SQL (CWE-89) en la línea de la consulta.
La corrección elimina el sumidero peligroso. Una consulta parametrizada envía el valor como dato, nunca como texto SQL:
String sql = "SELECT * FROM accounts WHERE username = ?";
PreparedStatement ps = connection.prepareStatement(sql);
ps.setString(1, username);
ResultSet rs = ps.executeQuery();
5. Informar del hallazgo
Cada hallazgo recibe un tipo de debilidad (normalmente un CWE), una ubicación, una gravedad y, en las mejores herramientas, la traza desde la fuente hasta el sumidero.
OWASP incluye la interoperabilidad de la salida entre sus criterios de selección y menciona SARIF, el Static Analysis Results Interchange Format. SARIF 2.1.0 es un estándar de OASIS que define un formato común para la salida de las herramientas de análisis estático. Así, los mismos paneles y plataformas de código pueden leer los resultados de distintos escáneres.
Así aparece en la plataforma de Plexicus un hallazgo procedente de una fuente SAST, con su ubicación en el código:
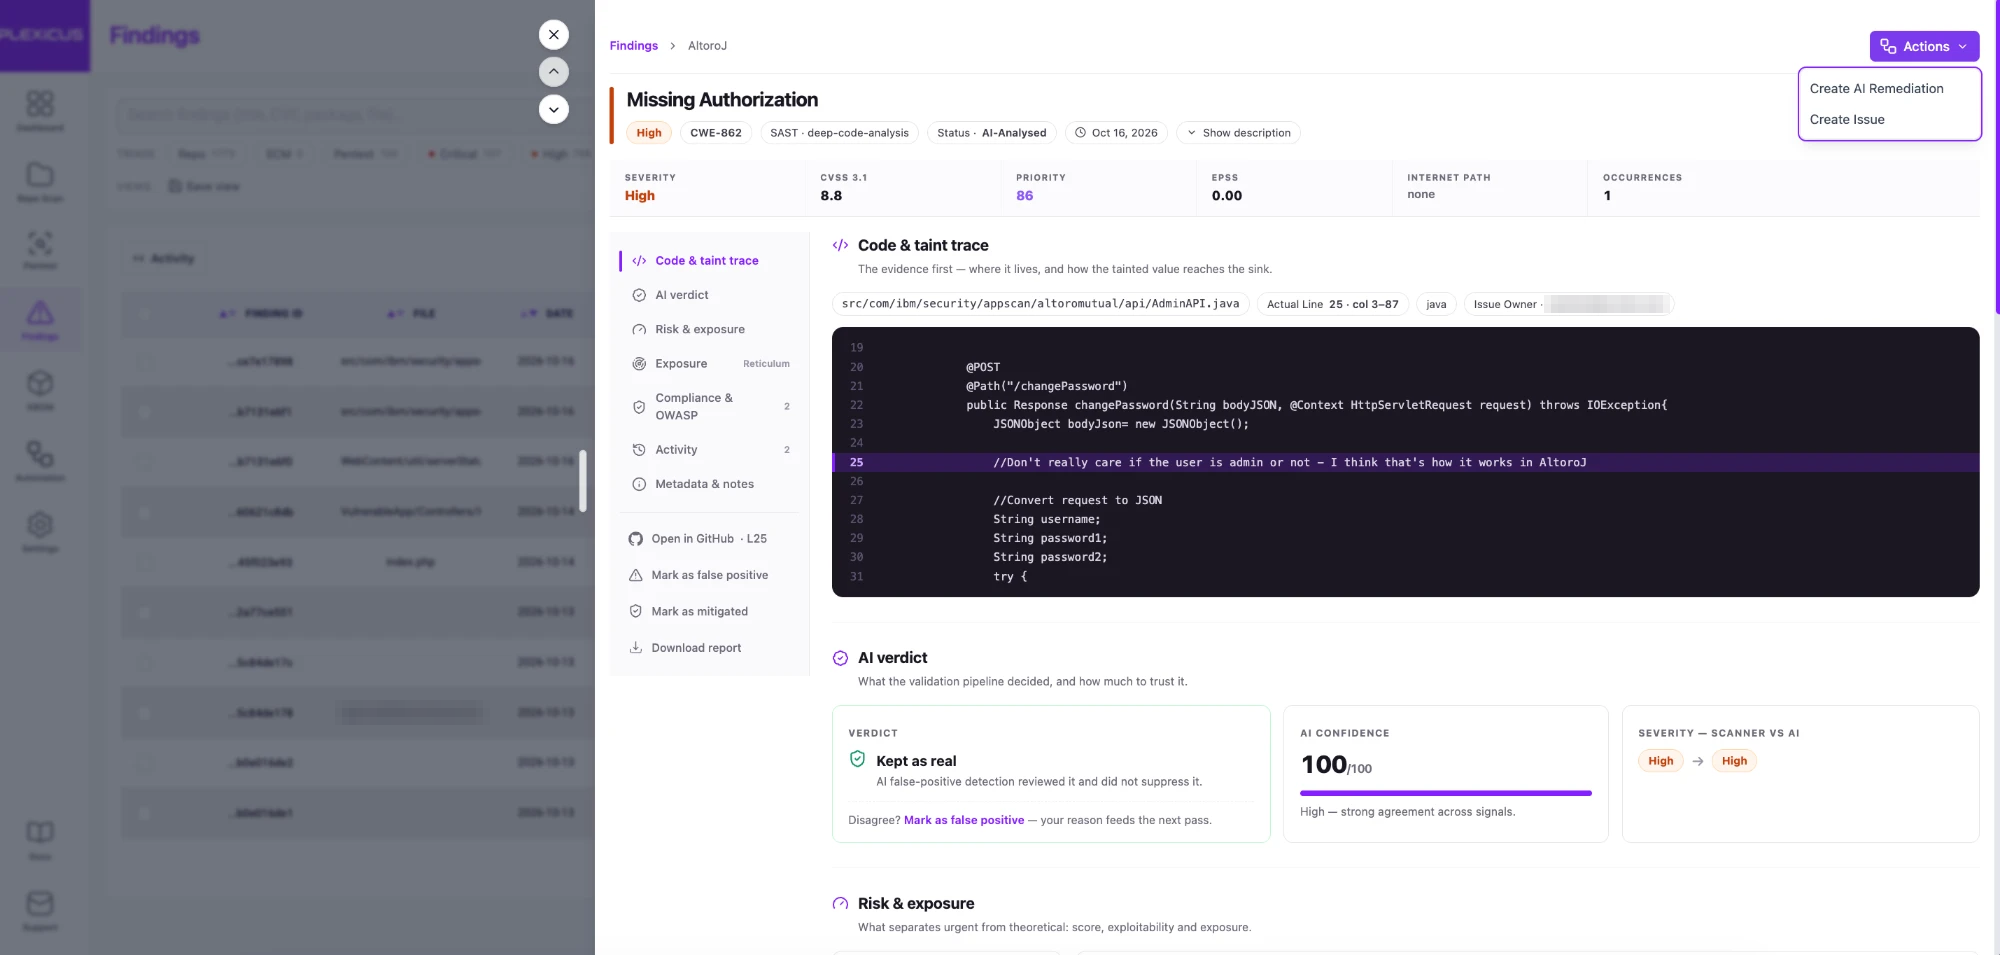
Captura de pantalla: la vista de detalle de un hallazgo de autorización ausente (CWE-862) en una aplicación Java de demostración, en la plataforma de Plexicus, con la etiqueta de origen SAST y la sección Code & taint trace abierta en la línea señalada. Se ven el panel del veredicto de IA y el menú Actions. Datos de demostración, capturados en octubre de 2026; la dirección de correo del responsable de la incidencia está pixelada.
6. Triaje
Una persona, o una segunda pasada automatizada, decide qué significa cada hallazgo.
¿Es real y es alcanzable? ¿Importa y quién se encarga de la corrección?
El triaje es donde la mayoría de los programas SAST triunfan o fracasan. Una herramienta que produce hallazgos más rápido de lo que el equipo puede clasificarlos produce un backlog, no seguridad.
Técnicas de análisis estático
Los motores SAST combinan algunas de las técnicas siguientes. Cada una ofrece un equilibrio distinto entre velocidad, precisión y profundidad.
Coincidencia de patrones
El motor busca en el árbol de sintaxis, o a veces en el texto sin procesar, construcciones que se sabe que son peligrosas: una llamada a un cifrado débil, una credencial incrustada en el código, una comprobación de certificado desactivada.
Fortalezas: es rápida, las reglas son fáciles de escribir y los resultados, fáciles de explicar.
Limitaciones: no entiende de dónde vienen los datos, así que señala usos seguros y pasa por alto usos inseguros que tienen otro aspecto.
Análisis de flujo de datos y de taint
El motor sigue los valores desde las fuentes hasta los sumideros a lo largo del programa, como en el ejemplo de Java anterior.
Fortalezas: encuentra fallos de inyección junto con la ruta que los explica; menos alertas sobre código que nunca recibe entradas no confiables.
Limitaciones: es más lento; la precisión depende de lo bien que la herramienta modele frameworks, librerías y sanitizadores; los programas muy grandes obligan a hacer aproximaciones.
Modelos semánticos y estructurales
Algunos motores construyen un modelo más rico de la aplicación: sus endpoints, sus parámetros, su grafo de llamadas y los roles que pueden llegar a cada ruta.
Fortalezas: puede conectar una debilidad con el endpoint que la expone y los datos que hay detrás, que es lo que necesita el triaje.
Limitaciones: es más difícil de construir y sigue siendo un modelo. Describe lo que el código podría hacer, no lo que hizo un atacante.
Análisis asistido por IA
Las herramientas más recientes añaden grandes modelos de lenguaje para explicar hallazgos, sugerir correcciones o filtrar el ruido.
Fortalezas: explicaciones legibles; puede razonar sobre código que las reglas describen mal.
Limitaciones: un modelo de lenguaje que lee un fragmento no establece por sí solo cómo afecta una debilidad a la aplicación en ejecución. Sigue necesitando los hechos estructurales y, idealmente, una prueba.
Para ver con más detalle por qué no basta con añadir un modelo de lenguaje a la coincidencia de patrones, consulta ¿Qué es el análisis profundo de código?.
Lo que SAST detecta bien
OWASP cita los desbordamientos de búfer y la inyección SQL como ejemplos de vulnerabilidades conocidas que identifican las herramientas SAST, y señala que escalan bien: pueden ejecutarse sobre mucho software y de forma repetida, como en las compilaciones nocturnas o en la integración continua. OWASP
En la práctica, SAST rinde mejor con los fallos que son visibles en el propio código:
| Debilidad | CWE | Por qué SAST la ve |
|---|---|---|
| Cross-site scripting | CWE-79 | datos no confiables fluyen a una respuesta HTML sin codificar |
| Inyección SQL | CWE-89 | datos no confiables fluyen a una cadena de consulta |
| Inyección de comandos del sistema operativo | CWE-78 | datos no confiables fluyen a una llamada al shell |
| Path traversal | CWE-22 | datos no confiables fluyen a una ruta de archivo |
| Inyección de código | CWE-94 | datos no confiables fluyen a un evaluador |
| Escritura fuera de límites | CWE-787 | operaciones de memoria inseguras en C y C++ |
| Uso de credenciales incrustadas en el código | CWE-798 | aparece un secreto literal en el código |
Las seis primeras de estas debilidades figuran en el CWE Top 25 de 2025. MITRE CWE
Lo que SAST pasa por alto
OWASP es directo sobre los límites. Su lista de debilidades de SAST incluye: OWASP
- Muchos tipos de vulnerabilidad son difíciles de encontrar automáticamente, como los problemas de autenticación, los problemas de control de acceso y el uso inseguro de la criptografía.
- Las herramientas actuales solo pueden identificar automáticamente un porcentaje relativamente pequeño de los fallos de seguridad de las aplicaciones.
- Un número elevado de falsos positivos.
- Con frecuencia no pueden encontrar problemas de configuración, porque estos no están representados en el código.
- Es difícil demostrar que un problema identificado sea una vulnerabilidad real.
Esos límites coinciden con el OWASP Top 10
. Su primera categoría es Broken Access Control (control de acceso defectuoso) y la segunda, Security Misconfiguration (configuración de seguridad incorrecta): los dos tipos de riesgo que más le cuestan al análisis estático.De cómo funciona SAST se derivan otros tres puntos ciegos:
Lógica de negocio
Una herramienta estática no sabe que un usuario solo debería descargar sus propias facturas. Si el código comprueba la sesión pero no la propiedad, todas las líneas parecen correctas.
Ejecución y entorno
Las cabeceras que fija un proxy, un feature flag en producción, una configuración permisiva en la nube: nada de eso está en el repositorio que lee la herramienta.
Explotabilidad
Una ruta contaminada en el código es una hipótesis. Si un atacante puede llegar a ella desde internet, con qué privilegios y qué obtiene es otra cuestión.
SAST responde a «¿dónde podría salir mal esto?». No responde a «¿puede alguien hacernos esto de verdad?».
Por qué SAST produce falsos positivos
Un falso positivo es un hallazgo que no es una vulnerabilidad real.
OWASP explica la causa de fondo: a menudo la herramienta no puede estar segura de la integridad y la seguridad de los datos mientras fluyen por la aplicación desde la entrada hasta la salida, y no puede rastrear datos a través de componentes de código cerrado o sistemas externos. OWASP
Así que el motor tiene que elegir. Cuando no puede demostrar que una ruta es segura, puede callar y arriesgarse a un falso negativo, o informar y arriesgarse a un falso positivo. Una herramienta de seguridad que informa en esa situación produce exactamente los falsos positivos que describe OWASP.
Causas habituales:
- Sanitizadores personalizados que la herramienta no reconoce.
- La «magia» de los frameworks: inyección de dependencias, anotaciones u ORM que la herramienta no modela.
- Código muerto o de pruebas que nunca se ejecuta en producción.
- Falta de contexto: la entrada ya la valida una pasarela que la herramienta no ve.
¿Cuántos son «demasiados»?
Google publicó una de las respuestas más claras. En «Lessons from Building Static Analysis Tools at Google» (Communications of the ACM, 2018), sus ingenieros definen un falso positivo efectivo como un problema sobre el que los desarrolladores no tomaron ninguna medida tras verlo, aunque el problema fuera técnicamente correcto.
Sus comprobaciones en la revisión de código deben producir menos de un 10 % de falsos positivos efectivos y, si la proporción de clics en «Not useful» de un analizador supera el 10 %, el equipo desactiva ese analizador hasta que sus autores lo mejoren. Es una práctica interna de Google, descrita por sus propios ingenieros.
La lección para cualquier equipo: son los desarrolladores, no los autores de la herramienta, quienes deciden si una herramienta es precisa. Un hallazgo sobre el que nadie actúa consume atención y no corrige nada.
Los falsos negativos también importan
Una herramienta silenciosa no es una herramienta segura.
Un falso negativo es una vulnerabilidad real que la herramienta pasó por alto. Ajustar un escáner hasta que no informe de nada incómodo es la forma más fácil de conseguir un panel limpio y una aplicación insegura.
Cómo evaluar una herramienta SAST
La lista de criterios de selección de OWASP es una buena lista de comprobación para empezar: OWASP
- Compatibilidad con tus lenguajes de programación.
- Capacidad de detectar las vulnerabilidades que te importan, como las del OWASP Top Ten.
- Precisión: tasas de falsos positivos y falsos negativos, y la puntuación en el OWASP Benchmark.
- Comprensión de las librerías y frameworks que usas.
- Si necesita código fuente compilable y si puede ejecutarse sobre binarios.
- Plugins para el IDE, facilidad de configuración e integración con CI/CD.
- Interoperabilidad de la salida, por ejemplo SARIF.
Usa benchmarks públicos y, después, tu propio código
Tres recursos públicos te ayudan a comparar herramientas sobre una verdad de referencia conocida:
- OWASP Benchmark. Una suite de pruebas ejecutable en Java y Python diseñada para verificar la velocidad y la precisión de las herramientas de detección de vulnerabilidades, con generadores de scorecards para las herramientas habituales. Su intención es que cada vulnerabilidad que puntúa sea realmente explotable. OWASP Benchmark
- Suites de pruebas Juliet. Las escribió el NSA Center for Assured Software y están alojadas en el Software Assurance Reference Dataset del NIST. Solo la suite Juliet actual para C y C++ contiene 64.099 casos de prueba organizados en 118 CWE. NIST SARD
- NIST SATE. La Static Analysis Tool Exposition es un estudio periódico y no competitivo sobre la eficacia de las herramientas de análisis estático. El NIST afirma que su propósito no es elegir la «mejor» herramienta, porque cada herramienta tiene puntos fuertes distintos. Se han celebrado seis ediciones y la última se publicó en septiembre de 2019. NIST SATE
Los benchmarks son sintéticos. La prueba que importa es tu propio repositorio: ejecuta cada candidata sobre el mismo código y pide a un ingeniero que haga el triaje de una muestra de hallazgos y cuente cuántos llevan a una corrección real.
Si buscas una lista de herramientas para empezar esa comparación, consulta nuestra selección de herramientas SAST para el desarrollo seguro.
Buenas prácticas de SAST
1. Empieza con un conjunto de reglas pequeño y fiable
Activa las reglas sobre las que tu equipo va a actuar: inyección, deserialización insegura, secretos incrustados en el código, criptografía débil. Amplía el conjunto cuando se estén corrigiendo los primeros hallazgos.
2. Bloquea los hallazgos nuevos en los pull requests y fija una línea base para el resto
Los desarrolladores aceptan comentarios sobre el código que acaban de escribir. Ignoran un comentario en un pull request que enumera 400 problemas de 2019.
Así que analiza cada pull request solo en busca de hallazgos nuevos y registra los existentes como una línea base que vas reduciendo por riesgo, con su propio calendario.
SAST es más útil cuando se ejecuta donde los desarrolladores ya trabajan. Una distribución habitual:
IDE            -> instant feedback while typing
Pull request   -> scan only the changed code, comment on the diff
CI pipeline    -> full rule set, block on agreed severities
Scheduled scan -> whole repository, new rules, old code
OWASP señala que las herramientas que se integran en el IDE dan a los desarrolladores información inmediata sobre los problemas que podrían estar introduciendo, algo muy útil frente a encontrar las vulnerabilidades mucho más tarde. OWASP
3. Enseña a la herramienta cómo es tu código
Registra tus sanitizadores, validadores y wrappers de frameworks personalizados. Cada uno que registras elimina toda una familia de falsos positivos.
4. Mide los falsos positivos efectivos
Toma prestada la idea de Google: mide con qué frecuencia actúan los desarrolladores sobre un hallazgo. Una regla sobre la que nadie actúa hay que corregirla o eliminarla.
5. Prioriza por alcanzabilidad y exposición
Una inyección SQL en un endpoint expuesto a internet no es lo mismo que una en un script interno por lotes. Ordena los hallazgos según lo que puede llegar a ellos y a lo que ellos pueden llegar.
6. Registra y haz el triaje en el flujo de trabajo del desarrollador
Eso es lo que pide el NIST en PW.7.2: que los hallazgos y las remediaciones recomendadas se registren y pasen por triaje en el flujo de trabajo o el gestor de incidencias del equipo. Un informe en PDF enviado por correo una vez al trimestre difícilmente lo cumple.
7. Valida antes de escalar y vuelve a probar después de corregir
Antes de que un hallazgo estático se convierta en un ticket crítico, intenta demostrarlo. Un exploit reproducido, o al menos una ruta alcanzable confirmada, cambia la rapidez con la que actúa un equipo.
Una corrección no ha terminado cuando se fusiona el pull request. Vuelve a ejecutar el análisis, e idealmente la prueba de concepto, para confirmar que la debilidad ha desaparecido y que la corrección no la ha desplazado a otro sitio.
Errores habituales con SAST
Error 1: Tratar el número de hallazgos como la métrica
Más hallazgos no es más seguridad. Cuenta en su lugar los problemas corregidos y validados, y el tiempo hasta la corrección.
Error 2: Activar todas las reglas el primer día
El resultado son miles de hallazgos que someter a triaje a la vez, y un equipo que aprende a ignorar la herramienta.
Error 3: Bloquear compilaciones por hallazgos no verificados
Una puerta que falla por falsos positivos acaba esquivándose. Bloquea solo con reglas que tengan un historial probado.
Error 4: Suponer que un análisis limpio significa una aplicación segura
La propia lista de OWASP dice que a SAST le cuesta encontrar automáticamente los problemas de control de acceso y de autenticación, y que los problemas de configuración pasan inadvertidos con frecuencia. Un informe SAST limpio dice poco sobre ellos.
Error 5: Dejar la corrección para «más tarde»
Un hallazgo sin responsable ni cambio propuesto es una nota, no un control de seguridad.
SAST y el código generado por IA
Los asistentes de programación con IA cambian el volumen del problema, no su naturaleza.
Las debilidades del código generado son las de siempre: inyección, autorización ausente, criptografía débil, secretos en el código. El primer informe de Veracode sobre el tema, un estudio de un proveedor publicado en 2025, situó el cross-site scripting entre los problemas más frecuentes de las muestras generadas que probó. Veracode
Lo que cambia es el ritmo. Cuando un desarrollador acepta una sugerencia de 200 líneas en segundos, la revisión que antes ocurría mientras escribía no llega a producirse.
Tres ajustes ayudan:
- Analiza donde se acepta el código. Los análisis en el IDE y en los pull requests importan más cuando el código llega en bloques grandes.
- No dejes que el asistente califique su propio trabajo. La herramienta que escribió el código no es una comprobación independiente de ese código.
- Mantén la prueba en el ciclo. El código generado que «parece correcto» merece la misma validación que cualquier otro código.
Estándares y marcos que exigen análisis de código
NIST SSDF (SP 800-218)
La edición definitiva vigente se publicó en febrero de 2022. La práctica PW.7 cubre la revisión o el análisis del código legible por humanos, y la tarea PW.7.2 pide que los hallazgos se registren y pasen por triaje. NIST
El NIST publicó un borrador de revisión, SP 800-218 Rev. 1, el 17 de diciembre de 2025; su periodo de comentarios se cerró el 30 de enero de 2026 y sigue siendo un borrador. NIST
OWASP Top 10
La edición vigente de la lista de concienciación de OWASP. La inyección es A05; el control de acceso defectuoso es A01. SAST cubre bien una parte de la lista y mal otra, como se ha visto antes. OWASP
CWE Top 25 (2025)
La clasificación de MITRE de las debilidades de software más peligrosas. Los identificadores CWE dan a las herramientas un lenguaje común: un hallazgo asociado a CWE-89 significa inyección SQL en cualquier herramienta. MITRE CWE
OWASP ASVS
El Application Security Verification Standard, cuya última versión estable es la 5.0.0, enumera requisitos detallados de verificación de seguridad. Algunos se pueden comprobar leyendo el código; otros requieren pruebas o revisión. OWASP ASVS
SARIF
El formato estándar de OASIS para los resultados del análisis estático. Te permite cambiar o combinar escáneres sin rehacer tus informes. La versión 2.1.0 es el estándar aprobado; en octubre de 2026 se publicó un borrador de comité de la siguiente versión. OASIS
Del hallazgo SAST a la prueba
Este es el resumen honesto de SAST.
Es la mejor herramienta que tienes para leer cada línea de tu código, cada día.
También es, según la propia OWASP, una herramienta que solo encuentra automáticamente una proporción relativamente pequeña de los fallos de seguridad, produce falsos positivos y tiene dificultades para demostrar que lo que encontró sea explotable.
Un test de penetración está en el otro extremo: intenta explotar el sistema en ejecución como lo haría un atacante.
Donde SAST dice «esta ruta de código podría permitir una inyección SQL», un pentest dice «extrajimos estos registros a través de esta petición». Esa es la diferencia entre una hipótesis y una prueba.
Así que la pregunta no es «SAST u otra cosa». Es qué pasa después del hallazgo:
Static finding    -> "this code path might be vulnerable"
Code context      -> "this is the endpoint, the data and the role behind it"
Validation        -> "here is the evidence that it can be exploited"
Reviewed fix      -> "here is the change, with the reasoning and a test"
Re-test           -> "the proof no longer reproduces"
Esa cadena es lo que llamamos Proof-Driven AppSec. Su regla es breve: sin PoC, no hay hallazgo.
Una alerta estática es donde empieza el trabajo. Las evidencias son lo que hace que un equipo actúe.
Dónde encaja Plexicus
Plexicus trata SAST como la primera señal y, después, añade el contexto, la prueba y la corrección.
Empieza con un análisis. La herramienta SAST gratuita analiza tu código fuente de GitHub con acceso de solo lectura. Plexicus afirma que no almacena código ni lo usa para entrenar IA.
El informe enumera las vulnerabilidades detectadas con un desglose por gravedad, referencias CVE y puntuación CVSS. El análisis gratuito se conecta hoy a GitHub; GitLab y Bitbucket figuran como próximamente disponibles.
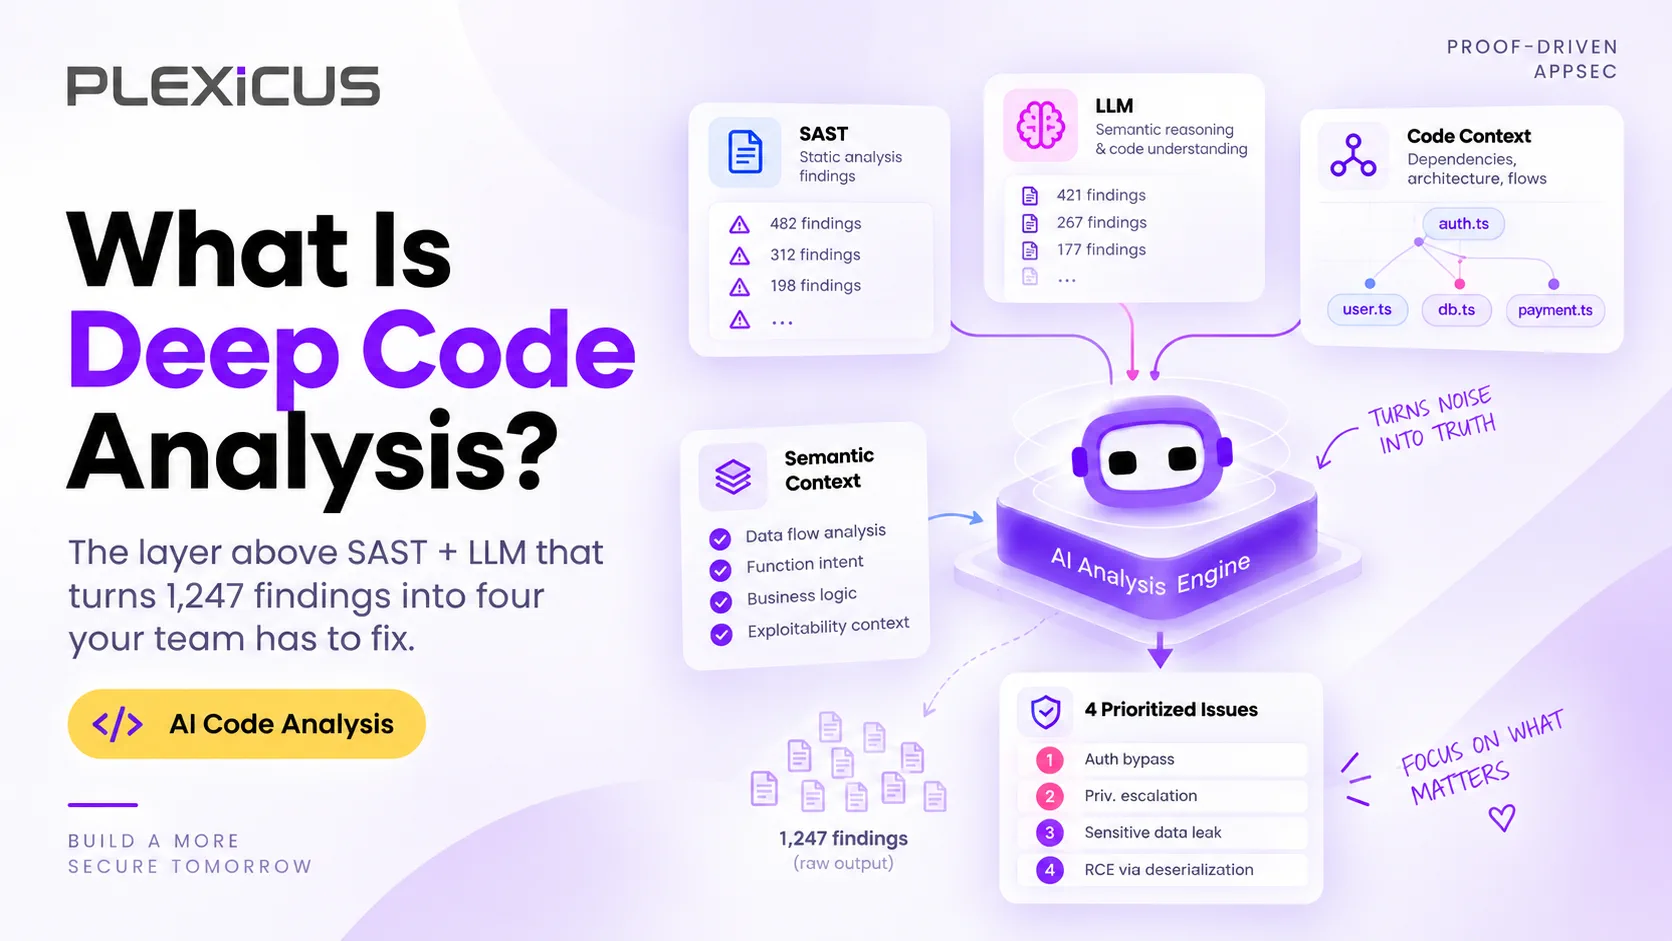
Añade contexto. Deep Code Analysis conecta el código, el flujo de datos y el impacto en el negocio. Su página de producto expone la diferencia sin rodeos: SAST puede señalar un patrón y un modelo de lenguaje puede explicar código, pero ninguno de los dos establece cómo afecta una debilidad a la aplicación.
Deep Code Analysis rastrea la ruta de código afectada, para que los ingenieros vean los endpoints, los parámetros y la lógica de negocio que toca un hallazgo, vincula cada hallazgo con los datos a los que puede llegar y el rol que puede activarlo, y asocia la clase de debilidad a un CWE. La página enumera 12 lenguajes: JavaScript, TypeScript, Python, Go, Java, Rust, Ruby, PHP, C#, Swift, Kotlin y Scala.
Demuéstralo. Deep Code Analysis añade el contexto y AI Swarm Pentest valida los hallazgos de mayor prioridad. AI Swarm Pentest valida rutas explotables en tu aplicación, tu API y tu código fuente dentro de un alcance autorizado, con verificación independiente y sin cambios automáticos en producción. Nuestra introducción a AI Swarm Pentest explica cómo funciona el enjambre de agentes.
Corrígelo. Una vez verificado un hallazgo, Plexicus Remediation prepara el contexto de remediación y un cambio sugerido. Para los hallazgos SAST clásicos, como la inyección SQL, XSS, SSRF, la deserialización insegura y la criptografía débil, Plexicus prepara parches revisados con pruebas de regresión adjuntas cuando procede, y un hook de nueva prueba queda conectado a la CI. Tu equipo conserva el control de la fusión: Plexicus nunca hace push a producción.
Así se ve un hallazgo estático de inyección SQL una vez propuesta una corrección:
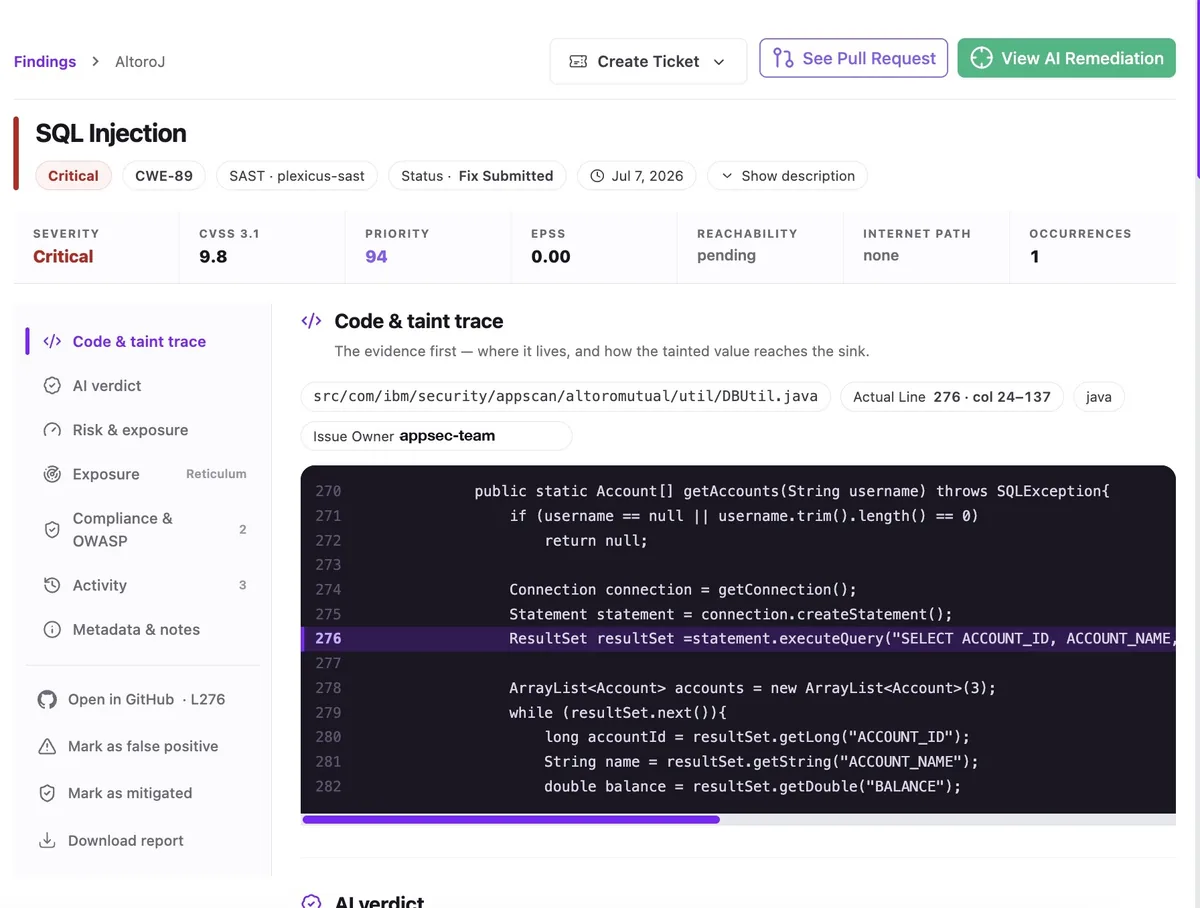
Captura de pantalla: un hallazgo crítico de inyección SQL (CWE-89) en una aplicación Java de demostración, con la etiqueta de origen SAST y el estado Fix Submitted, en la plataforma de Plexicus. La barra de herramientas ofrece Create Ticket, See Pull Request y View AI Remediation. Datos de demostración de una versión anterior de la interfaz de Plexicus, julio de 2026.
En conjunto, eso es un ciclo cerrado con PR: una señal estática, contexto, evidencias de lo que importa y, después, un cambio revisado que tu equipo decide fusionar.
Para ver dónde encaja SAST en un programa completo, lee nuestra guía completa de seguridad de aplicaciones. Para saber qué ocurre después de la validación, consulta Presentamos la remediación nativa de IA.
Preguntas frecuentes
¿Qué significa SAST?
SAST son las siglas de static application security testing (pruebas estáticas de seguridad de aplicaciones): analizar el código de una aplicación en busca de debilidades de seguridad sin ejecutarla.
¿Qué diferencia hay entre SAST y DAST?
SAST lee el código desde dentro sin ejecutarlo. DAST prueba una aplicación en ejecución desde fuera enviándole peticiones. SAST localiza la línea; DAST muestra el comportamiento real en ejecución.
¿Qué diferencia hay entre SAST y SCA?
SAST analiza el código que escribió tu equipo. SCA inventaría los componentes de terceros y de código abierto y compara sus versiones con vulnerabilidades conocidas.
¿Qué vulnerabilidades puede encontrar SAST?
SAST rinde mejor con los fallos visibles en el código: inyección SQL, cross-site scripting, inyección de comandos, path traversal, inyección de código, operaciones de memoria inseguras y credenciales incrustadas en el código.
¿Qué no puede encontrar SAST?
Según OWASP, a SAST le cuestan los problemas de autenticación, los problemas de control de acceso, el uso inseguro de la criptografía y los problemas de configuración, y tiene dificultades para demostrar que un hallazgo sea explotable. Los fallos de lógica de negocio también le resultan en gran medida invisibles.
¿Por qué SAST produce tantos falsos positivos?
Cuando una herramienta no puede demostrar que los datos son seguros mientras pasan de la entrada a la salida, normalmente informa de ellos. Los sanitizadores personalizados, los frameworks que la herramienta no modela y la falta de contexto de ejecución son las causas más habituales.
¿Cómo se reducen los falsos positivos de SAST?
Empieza con un conjunto de reglas pequeño, registra tus sanitizadores y wrappers de frameworks, analiza solo el código nuevo en los pull requests, mide con qué frecuencia actúan los desarrolladores sobre los hallazgos y valida los hallazgos de gravedad alta antes de escalarlos.
¿Es SAST obligatorio para el cumplimiento normativo?
Marcos como el SSDF del NIST piden revisión o análisis de código, con los hallazgos registrados y sometidos a triaje, pero no nombran una herramienta concreta. SAST es una forma habitual de cumplir a escala la parte de análisis de código.
¿Basta SAST por sí solo?
No. SAST es una capa. Un programa también necesita SCA para las dependencias, pruebas en tiempo de ejecución y una forma de demostrar qué hallazgos son explotables antes de que el equipo dedique tiempo a corregirlos.
Haz que cada hallazgo estático se demuestre
Lee cada línea con SAST y dedica el tiempo de tu equipo solo a lo que se pueda demostrar.
Descubre Plexicus Deep Code Analysis →
¿Quieres echar un primer vistazo a tu propio código? Ejecuta la herramienta SAST gratuita, un análisis estático de tu código fuente en GitHub.