Presentamos la remediación nativa de IA: del hallazgo validado a la corrección revisada
Cómo un hallazgo validado se convierte en un pull request listo para revisión, con evidencias, pruebas de regresión y una nueva prueba, y por qué tu equipo conserva la decisión de fusionar.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestEncontrar vulnerabilidades nunca ha sido tan barato.
Corregirlas no ha seguido el mismo ritmo.
Los escáneres, los pentests y los agentes de IA producen hoy hallazgos más rápido de lo que los equipos de ingeniería pueden leerlos. El backlog crece. El riesgo sigue en producción.
La remediación nativa de IA es la práctica de convertir un hallazgo de seguridad validado en un cambio de código listo para revisión, con las evidencias, el razonamiento y las pruebas adjuntos, para que una persona pueda fusionarlo con confianza y una nueva prueba demuestre que la corrección funcionó.
No es un bot que envía parches a producción.
Es el último paso de un ciclo cerrado: demostrar el problema, entenderlo en el código, proponer el cambio, dejar que una persona decida y, después, demostrar que el problema ha desaparecido.
La necesidad se puede medir. En su Data Breach Investigations Report 2026, Verizon concluyó que la explotación de vulnerabilidades se había convertido en el vector de acceso inicial más común, con un 31 % de las brechas de su conjunto de datos cuyo vector de acceso inicial se conocía. El mismo informe constató que solo se remedió por completo en 2025 el 26 % de las Known Exploited Vulnerabilities (KEV) de CISA encontradas en los entornos de las organizaciones, frente al 38 % del año anterior, y que la mediana del tiempo hasta la resolución completa subió a 43 días.
Los atacantes aprovechan la distancia entre «encontrado» y «corregido». La remediación nativa de IA consiste en cerrarla sin renunciar al control.
¿Qué es la remediación nativa de IA?
La remediación nativa de IA es un flujo de remediación diseñado en torno a la IA desde el principio: el sistema lee un hallazgo validado, reúne el contexto de código que lo rodea, redacta una corrección mínima con pruebas y una explicación, la abre como pull request para revisión humana y vuelve a ejecutar la prueba de concepto original después del cambio.
Tres palabras de esa definición hacen casi todo el trabajo.
Validado. La entrada es un hallazgo que se ha demostrado real, no una alerta en bruto. Si el problema no se puede reproducir, todavía no hay nada que corregir.
Listo para revisión. El resultado es un cambio que un desarrollador puede evaluar en minutos: un diff pequeño, el motivo por el que resuelve la debilidad, las pruebas que lo cubren y las ubicaciones del código implicadas.
Vuelto a probar. La corrección no termina cuando se fusiona. Termina cuando la prueba de concepto original deja de funcionar.
Si se elimina cualquiera de las tres, el resultado es más débil.
Sin validación, se automatizan correcciones para problemas que quizá no existen.
Sin revisión, se entrega acceso de escritura a un modelo.
Sin una nueva prueba, queda un cambio que parece correcto y quizá no lo sea.
Por qué la remediación es el cuello de botella en 2026
La detección escaló primero. La remediación no.
Las cifras de fuentes independientes apuntan en la misma dirección.
Los datos de parcheo.
El DBIR 2026 midió la remediación de las vulnerabilidades incluidas en el catálogo KEV que los escáneres encontraron en los entornos de las organizaciones, con datos agregados de más de 13.000 organizaciones. Destacan tres conclusiones:
- Solo el 26 % de esas vulnerabilidades KEV se remedió por completo en 2025, frente al 38 % del año anterior.
- La mediana del tiempo hasta la resolución completa pasó de 32 a 43 días.
- La organización mediana tenía 16 vulnerabilidades KEV que parchear, frente a 11 el año anterior, lo que el informe describe como casi un 50 % más.
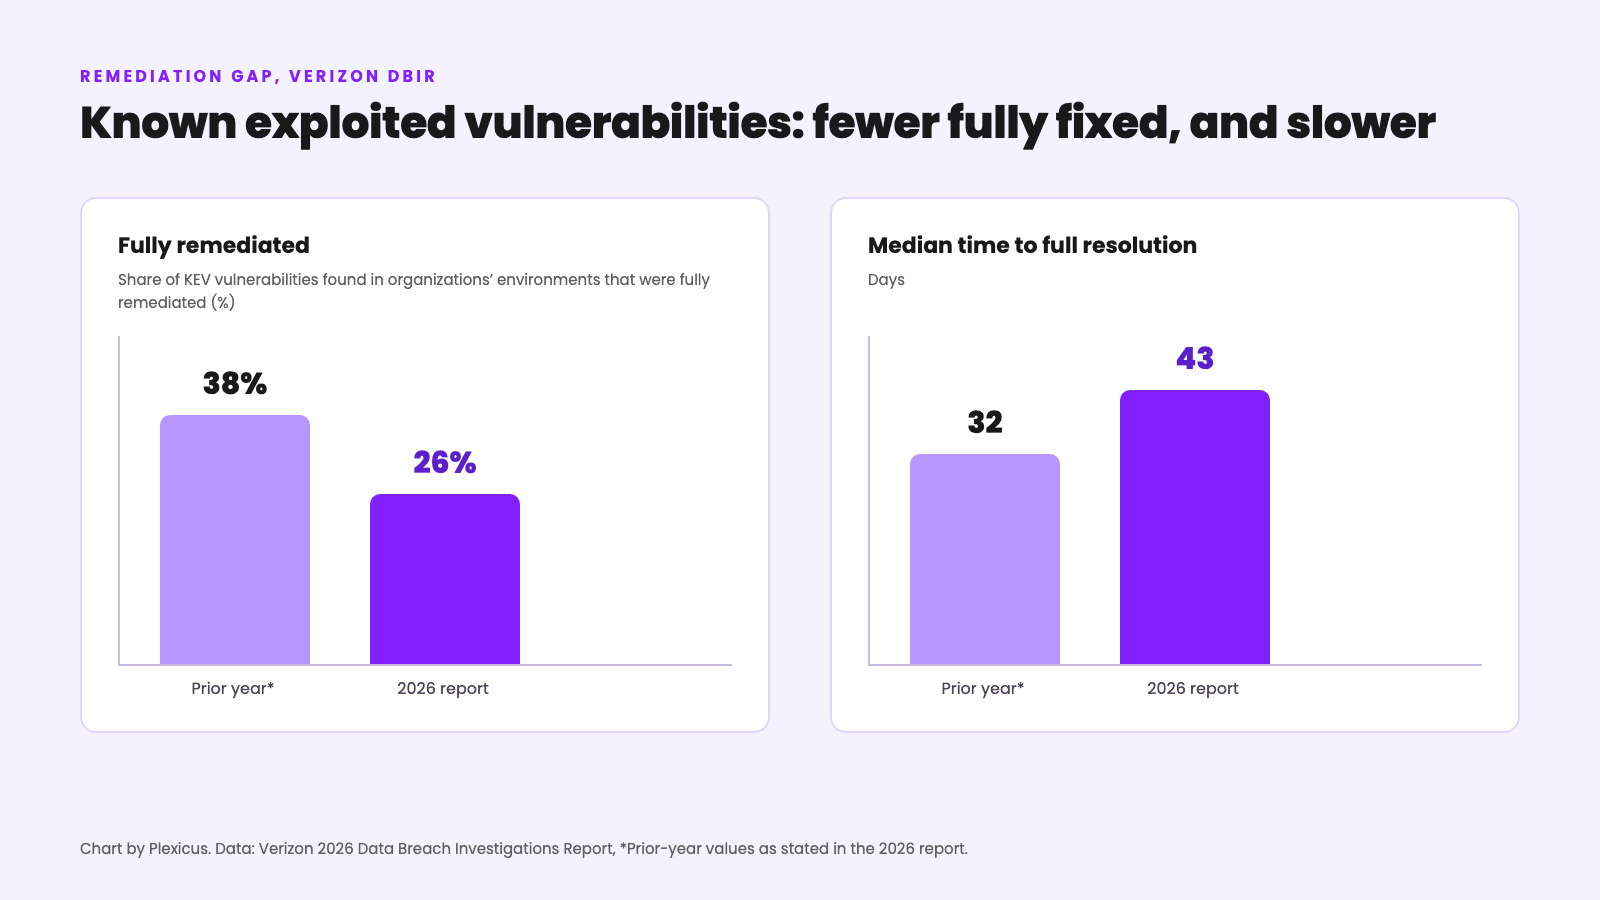
Gráfico elaborado por Plexicus con las cifras publicadas en el Data Breach Investigations Report 2026 de Verizon; los valores del año anterior son los que el propio informe indica como comparación.
Estas cifras describen el parcheo de vulnerabilidades conocidas en los entornos de las organizaciones, no las correcciones en código propio de aplicaciones. Aun así, muestran la forma del problema: la cola crece más rápido de lo que los equipos la cierran.
Los plazos.
Para las agencias federales de EE. UU., el plazo no es cuestión de preferencia. La Binding Operational Directive (BOD) 26-04 de CISA, emitida el 10 de junio de 2026, revocó la BOD 22-01 y reemplazó los plazos KEV predeterminados de esa directiva por plazos de remediación basados en el riesgo para las agencias civiles del poder ejecutivo federal.
Cuatro factores fijan el plazo de cada activo:
- Si está expuesto públicamente.
- Si la vulnerabilidad figura en el catálogo KEV.
- Si un adversario puede automatizar todos los pasos necesarios para explotarla.
- Si explotarla con éxito da control parcial o total del activo.
Los plazos cambian cuando cambian esos hechos: el plazo de una vulnerabilidad se acorta cuando CISA la añade al catálogo KEV. Las agencias ya deben remediar las vulnerabilidades KEV según las fechas límite del catálogo KEV, y deben cumplir los plazos completos para toda vulnerabilidad con identificador CVE dentro de los 180 días siguientes a la emisión.
En Europa, la Ley de Ciberresiliencia entró en vigor el 10 de diciembre de 2024. Según la Comisión Europea, sus obligaciones de notificación se aplican desde el 11 de septiembre de 2026 y sus obligaciones principales desde el 11 de diciembre de 2027. Los fabricantes de productos con elementos digitales ya deben notificar las vulnerabilidades explotadas activamente.
La regulación no escribe parches. Sí acorta el tiempo que un equipo puede dedicar a decidir si los escribe.
El código que se escribe.
El volumen de código nuevo también está cambiando. El 2025 GenAI Code Security Report de Veracode evaluó más de 100 grandes modelos de lenguaje en tareas de programación e informó de que el 45 % de las muestras de código no superó las pruebas de seguridad e introdujo debilidades del OWASP Top 10. Son resultados comunicados por el propio proveedor sobre su conjunto de pruebas, no una replicación independiente.
Incluso con esa salvedad, la dirección está clara. Las herramientas de programación con IA aumentan la cantidad de código que llega a revisión. Parte de ese código arrastra los mismos fallos clásicos que los equipos de seguridad llevan veinte años corrigiendo.
El volumen de divulgaciones.
La metodología del CWE Top 25 de 2025 de MITRE analizó 39.080 registros CVE publicados entre el 1 de junio de 2024 y el 1 de junio de 2025. Es un año de registros CVE publicados, antes de contar lo que tus propios escáneres y pruebas encuentran en tu propio código.
Más hallazgos, plazos más cortos, más código. La limitación ya no es ver el problema. Es cerrarlo.
Qué significa «nativa de IA» y qué no significa
«Nativa de IA» es una expresión fácil de usar mal, así que conviene precisarla.
Un flujo de remediación nativa de IA es aquel en el que la IA forma parte del diseño del pipeline: recibe evidencias estructuradas, trabaja sobre el repositorio real, produce un resultado estructurado y lo comprueban las pruebas y una persona.
Es distinto de añadir una ventana de chat a un escáner.
También es distinto de la autonomía sin límites.
La IA redacta. Las pruebas comprueban. Las personas deciden. Una nueva prueba confirma.
En ese sentido, «nativa de IA» describe dónde se sitúa la IA en el ciclo, no cuánta autoridad tiene.
Cuanto más trabajo hace la IA, más evidencias y revisión necesita el flujo a su alrededor.
Remediación nativa de IA frente a gestión automatizada de parches
La gestión automatizada de parches y los bots de actualización de dependencias resuelven muy bien un problema más acotado.
La documentación de GitHub sobre las actualizaciones de seguridad de Dependabot describe el patrón: cuando una dependencia tiene un aviso publicado, Dependabot comprueba si puede actualizarla a una versión corregida sin romper el grafo de dependencias y, después, abre un pull request que actualiza la dependencia a la versión mínima que incluye el parche.
Es un flujo valioso. Mantenlo.
Pero responde a una sola pregunta: ¿existe una versión más reciente de este paquete sin la vulnerabilidad conocida?
El propio pull request de subida de versión no responde a estas:
- ¿Tu código llama realmente a la función vulnerable?
- ¿El fallo está en tu propio código y no en una librería?
- ¿La corrección exige cambiar cómo llama tu aplicación a la librería?
- ¿El problema real es una comprobación de autorización que nunca se escribió?
La remediación nativa de IA parte de otra entrada. Empieza con un hallazgo validado en tu aplicación, incluido el código propio, y puede proponer cambios en ese código, no solo en un manifiesto.
Los dos enfoques funcionan bien juntos. Subir de versión suele ser la corrección adecuada. A veces no basta.
Remediación nativa de IA frente a sugerencias de código con IA
Las sugerencias de IA en línea, en un editor o en un pull request, ayudan a un desarrollador que ya está mirando el problema.
Son útiles. También son otra cosa.
Una sugerencia en línea suele partir de una alerta del escáner o de un prompt del desarrollador. Propone una edición. El desarrollador decide si la alerta era real y si la edición es correcta.
La remediación nativa de IA adelanta dos de esas decisiones y las hace explícitas:
- ¿El hallazgo es real? El flujo solo acepta hallazgos validados con evidencias.
- ¿La corrección funciona? El flujo adjunta pruebas y vuelve a ejecutar la prueba de concepto original.
El desarrollador sigue revisando el cambio. Lo revisa con más contexto y menos conjeturas.
Remediación nativa de IA frente a remediación manual
La remediación manual es la referencia y sigue siendo la herramienta adecuada para los problemas más difíciles.
Un ingeniero sénior entiende la intención del diseño, las convenciones del equipo y las reglas de negocio que ningún informe de hallazgos recoge. Ante un fallo arraigado en la arquitectura, debe liderar una persona.
La debilidad de la remediación manual no es la calidad. Es el rendimiento y la consistencia.
Cada hallazgo necesita que alguien lo reproduzca, lo localice, lo entienda, diseñe una corrección, escriba pruebas y abra un pull request. Ese trabajo compite con la hoja de ruta del producto, y la hoja de ruta suele ganar.
La remediación nativa de IA asume la parte repetitiva de esa secuencia y deja la decisión en manos del ingeniero.
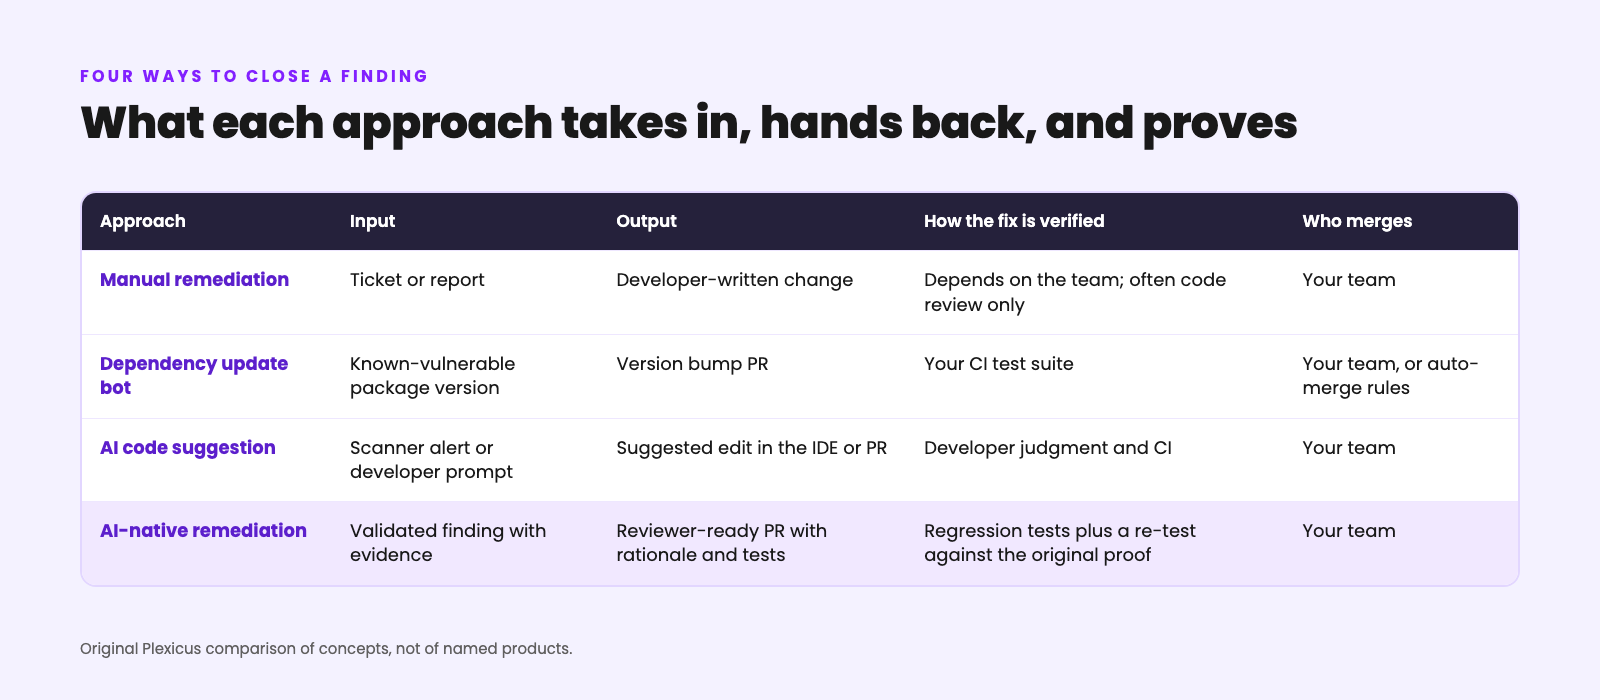
Comparación original de Plexicus de los cuatro enfoques como conceptos; no describe ningún producto concreto.
Cómo funciona la remediación nativa de IA
Un flujo completo tiene siete etapas. Cada una entrega a la siguiente un artefacto concreto. El diagrama siguiente las agrupa en cinco pasos.
Validated finding + evidence
        ↓
Code context and root cause
        ↓
Fix strategy
        ↓
Drafted change + tests + rationale
        ↓
Automated checks (CI)
        ↓
Human review and merge decision
        ↓
Re-test against the original proof
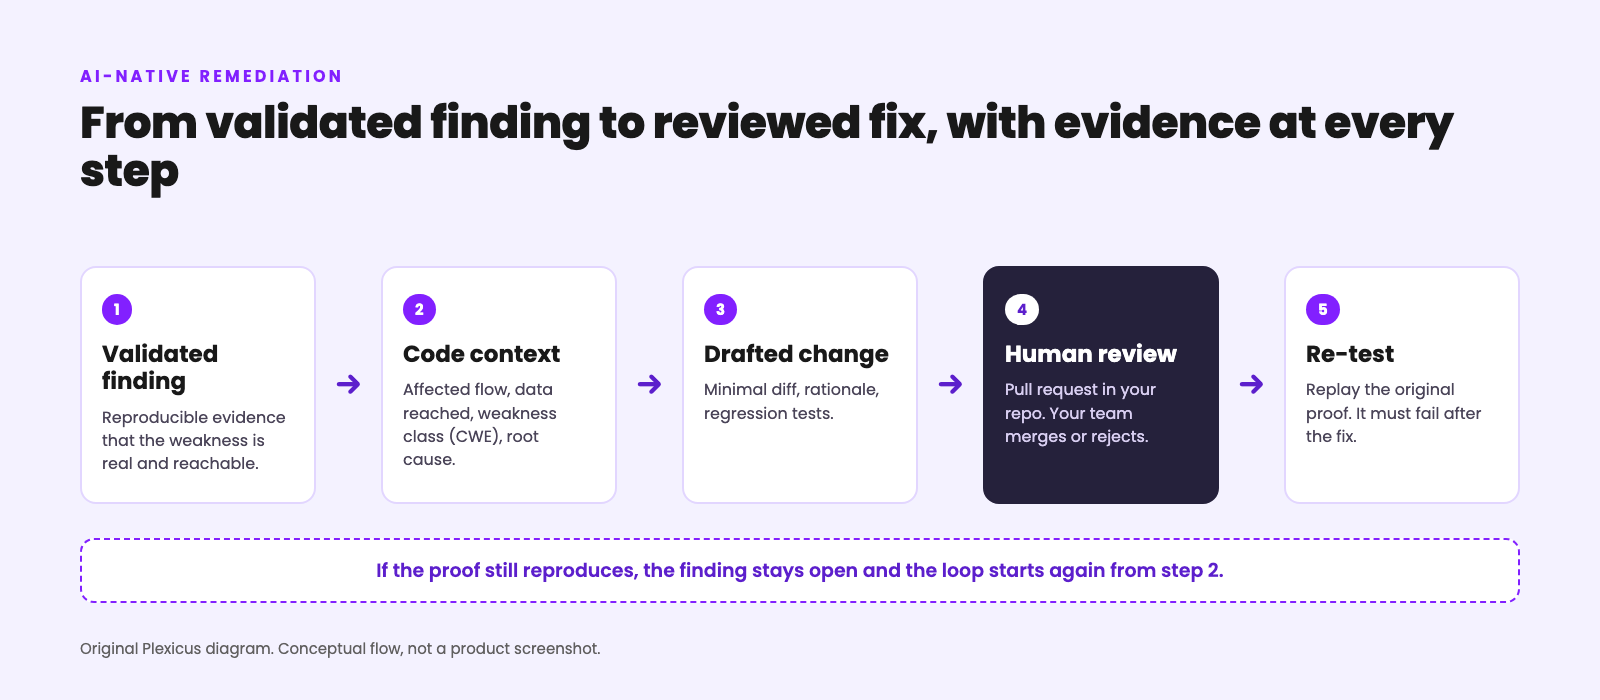
Diagrama original de Plexicus del ciclo de remediación; es un flujo conceptual, no una captura del producto.
1. Partir de un hallazgo validado
La entrada es un hallazgo con evidencias: la petición que activó el fallo, la respuesta que lo demostró, los datos a los que se llegó y el rol que pudo llegar a ellos.
Un hallazgo sin evidencias es una hipótesis. Remediar una hipótesis desperdicia tiempo de revisión y erosiona la confianza en cada pull request posterior.
2. Reunir el contexto del código y la causa raíz
El sistema rastrea el hallazgo hasta el código: el endpoint, el handler, la función, el parámetro y el flujo de datos entre ellos.
También identifica la clase de debilidad, normalmente como una entrada CWE, por ejemplo CWE-89 para la inyección SQL. La clase importa porque el patrón de corrección depende de ella.
Así se ve el contexto de código de un hallazgo en la plataforma de Plexicus.
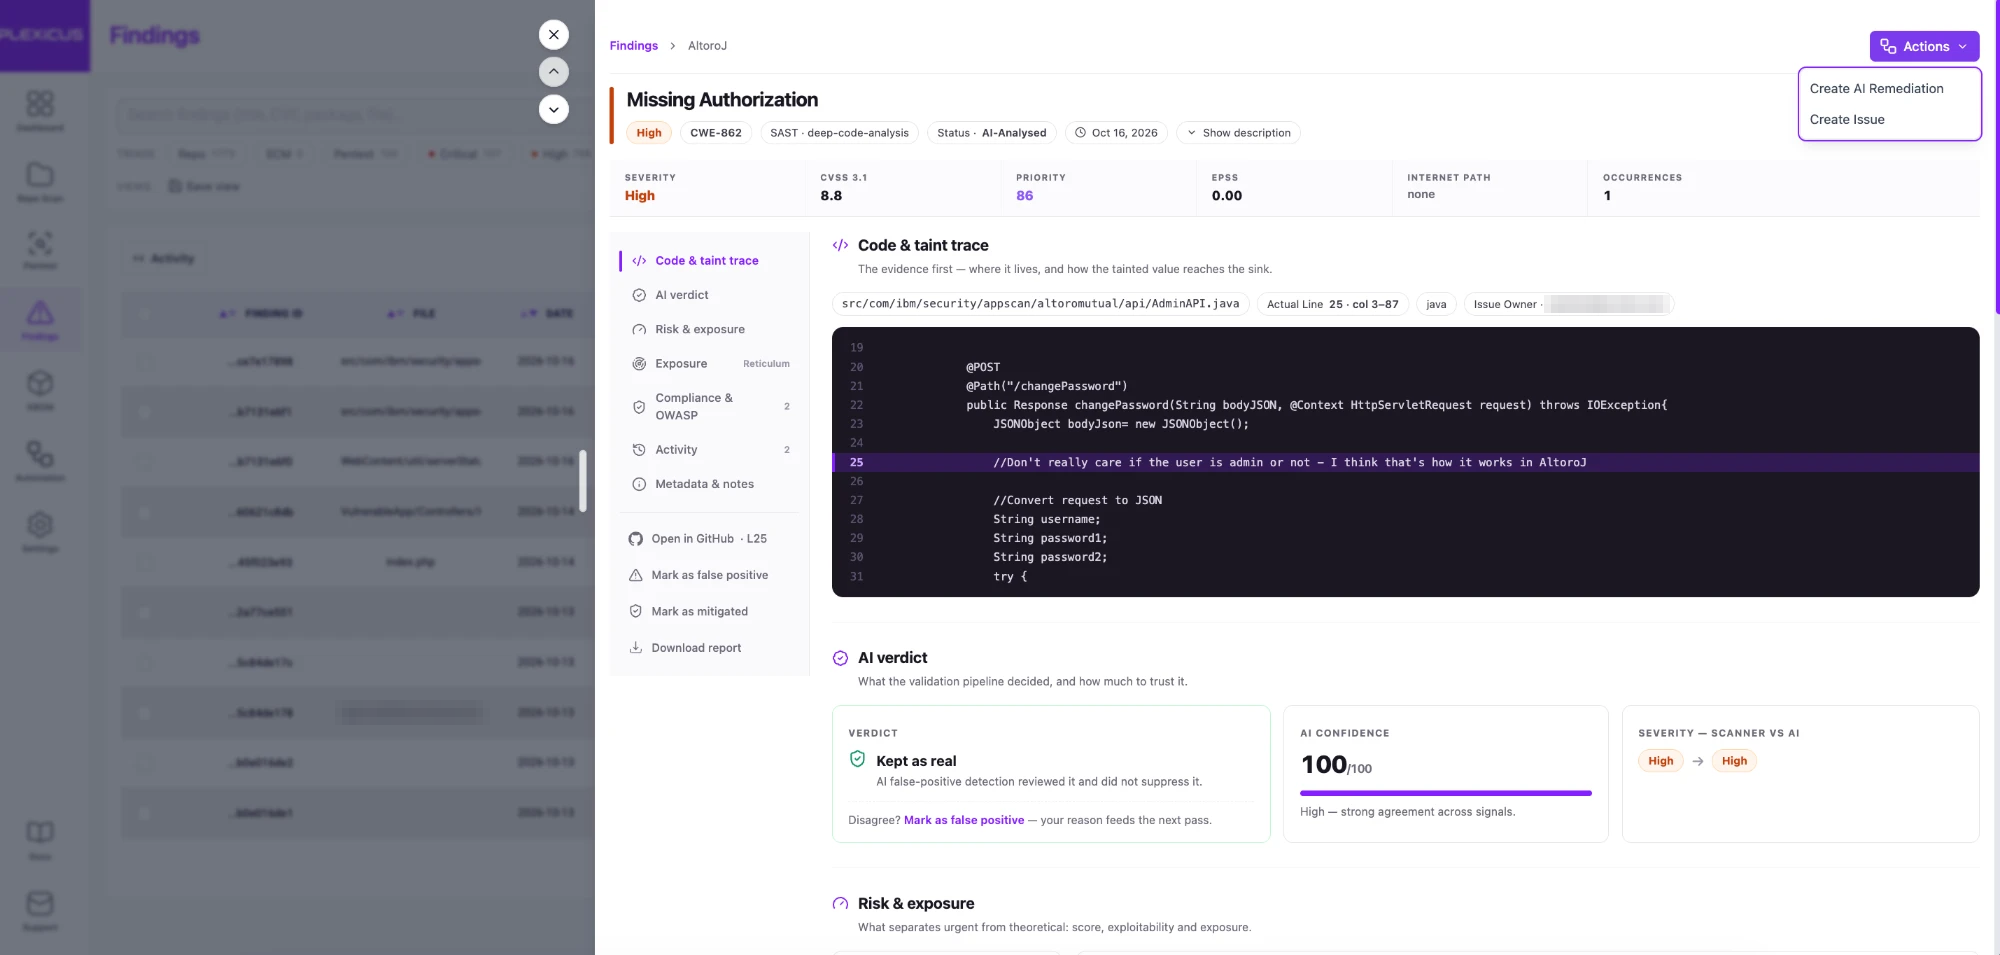
Captura de pantalla: el detalle de un hallazgo de autorización ausente (CWE-862) en una aplicación Java de demostración, en la plataforma de Plexicus. Muestra la sección Code & taint trace, el veredicto de IA y Create AI Remediation en el menú de acciones. Datos de demostración, capturados en octubre de 2026; la dirección de correo del responsable de la incidencia está pixelada.
3. Elegir una estrategia de corrección
La mayoría de las clases de debilidad tienen patrones de corrección probados.
Consultas parametrizadas para la inyección. Una comprobación de propiedad para la autorización a nivel de objeto. Una actualización de versión para una dependencia vulnerable.
La estrategia también decide el alcance. La mejor corrección suele ser el cambio más pequeño que elimina la debilidad en su origen.
4. Redactar el cambio, las pruebas y la explicación
El resultado es un diff, una justificación breve que vincula cada línea modificada con el hallazgo y pruebas que habrían fallado antes de la corrección.
Una prueba de regresión es lo que impide que el mismo fallo vuelva dentro de seis meses.
Esta es una remediación generada por IA durante su revisión en la plataforma de Plexicus.
Vídeo: un clip del recorrido por la plataforma de Plexicus. En el cuadro de diálogo AI Remediation Details de un hallazgo de inyección de comandos, la pestaña Details explica la vulnerabilidad y la corrección, la pestaña Code Changes muestra el diff de app.py y el clip termina con la creación del pull request. Grabado en mayo de 2026.
5. Ejecutar las comprobaciones automatizadas
El cambio pasa por el mismo pipeline de CI que cualquier otro pull request: compilación, pruebas unitarias, linters y las comprobaciones de seguridad existentes.
Una corrección redactada por IA no tiene atajos. Al contrario, pasa siempre por el pipeline completo.
6. Entregar la decisión a una persona
El cambio llega como pull request al repositorio que tu equipo ya usa. Un revisor lee el diff, las evidencias y la justificación y, después, lo fusiona, lo edita o lo rechaza.
El revisor es dueño de la fusión.
Así se ve un hallazgo cuando ya se ha enviado una corrección, en la plataforma de Plexicus.
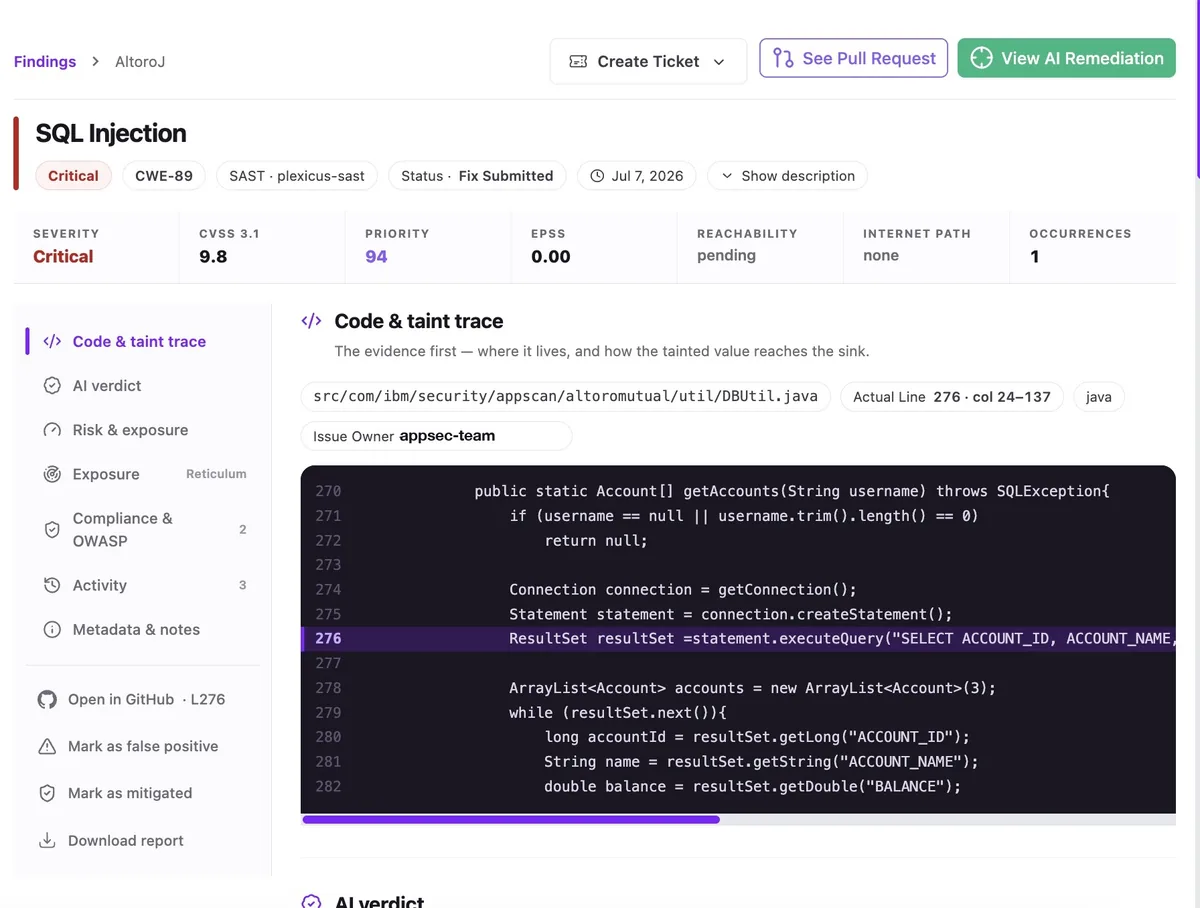
Captura de pantalla: un hallazgo crítico de inyección SQL (CWE-89) en una aplicación Java de demostración, mostrado en la plataforma de Plexicus con el estado Fix Submitted. La barra de herramientas ofrece Create Ticket, See Pull Request y View AI Remediation. Datos de demostración.
Y este es un pull request para un hallazgo de inyección de comandos, tal como llega al repositorio.
Vídeo: un clip del recorrido por la plataforma de Plexicus. El registro de estado en vivo termina con la creación del pull request; en GitHub lo abre una cuenta bot de Plexicus con un commit y la explicación de la corrección en su descripción, y después una persona lo fusiona. Esta grabación no muestra comprobaciones de CI ni revisiones en el pull request. Grabado en mayo de 2026.
7. Volver a probar contra la prueba de concepto original
Después del cambio, se reproduce la prueba de concepto original. Si el exploit sigue funcionando, el hallazgo sigue abierto. Si falla, el hallazgo se puede cerrar con evidencias de ambos lados: se reproducía antes y no se reproduce después.
Ese último paso es lo que convierte un cambio de código en un hallazgo cerrado.
Por qué la entrada tiene que ser un hallazgo validado
Es tentador apuntar un agente de corrección a todo lo que producen todos los escáneres.
Eso multiplica el ruido.
Cada falso positivo se convierte en un pull request. Cada pull request consume tiempo de un revisor. Tras unos cuantos cambios rechazados, los revisores empiezan a aprobarlos o ignorarlos sin leerlos, lo que es peor que no tener ninguna automatización.
Partir de hallazgos validados cambia la economía de la revisión. Cada cambio que ve un revisor está vinculado a un problema que se ha demostrado real.
Ese es el núcleo de Proof-Driven AppSec: No PoC, no finding. La misma regla se aplica un paso después. Sin hallazgo validado, no hay corrección automatizada.
Para saber más sobre cómo funciona la validación, consulta nuestra explicación de AI Swarm Pentest, que trata la reproducción independiente antes de presentar un hallazgo como verificado.
Por qué el resultado tiene que ser un pull request y no un push
Un pull request es el punto de control en el que tu organización de ingeniería ya confía.
Contiene un diff y ejecuta la CI. Registra quién aprobó qué y cuándo, y se puede revertir.
El proyecto OpenSSF Scorecard lo trata como una práctica básica. Su comprobación Code-Review determina si un proyecto exige revisión humana del código antes de fusionar los pull requests y califica como alto el riesgo de omitirla.
Ese estándar debería aplicarse con más fuerza, no con menos, cuando el autor es una IA.
Por eso, un flujo de remediación nativa de IA nunca necesita acceso directo de escritura a producción. Necesita poder abrir una rama y un pull request. Todo lo demás es tu proceso habitual.
Qué dice la investigación sobre las correcciones de seguridad generadas por IA
La investigación sobre parches de seguridad escritos por IA es alentadora y aleccionadora a la vez. Merece la pena conocer cuatro fuentes.
Los LLM pueden reparar casos sencillos; el código real es más difícil.
En “Examining Zero-Shot Vulnerability Repair with Large Language Models”, publicado en el IEEE Symposium on Security and Privacy de 2023, Pearce y sus colegas probaron cinco modelos comerciales, un modelo de código abierto y un modelo entrenado localmente con escenarios de vulnerabilidad sintéticos, creados a mano y reales.
En conjunto, los modelos repararon todos los escenarios sintéticos y creados a mano. Con ejemplos históricos del mundo real, los autores señalaron dificultades para generar código funcionalmente correcto.
Lección: una corrección que compila no es lo mismo que una corrección que funciona.
A escala, una tasa de éxito modesta sigue importando.
El informe técnico de Google sobre parcheo con IA describe un pipeline que pide a Gemini correcciones para errores detectados por sanitizers en C/C++, Java y Go y, después, las presenta para revisión humana.
Google afirma que el enfoque corrigió con éxito el 15 % de los errores de sanitizer descubiertos durante las pruebas unitarias, lo que se tradujo en cientos de errores parcheados. Es un resultado comunicado por la propia empresa sobre su pipeline, no una replicación independiente.
Lección: incluso una tasa de automatización parcial elimina trabajo real, siempre que las personas revisen lo que se publica.
La calidad del parche hay que probarla, no juzgarla por similitud.
En “Fixing Security Vulnerabilities with AI in OSS-Fuzz”, los investigadores adaptaron un agente basado en LLM para corregir vulnerabilidades encontradas por OSS-Fuzz, que según el artículo ha identificado más de 10.000 vulnerabilidades en 1.000 proyectos o más.
Una de sus conclusiones afecta directamente al diseño de la remediación: parches con puntuaciones altas en métricas de similitud de código seguían fallando cuando se ejecutaba contra ellos la entrada del exploit. Los autores concluyen que la corrección de un parche de seguridad debe tener en cuenta atributos dinámicos, como la ejecución de pruebas.
Lección: el exploit forma parte de la prueba. Una corrección no es correcta hasta que la prueba de concepto deja de funcionar, por mucho que el diff se parezca a una corrección conocida.
Los sistemas de competición pueden encontrar y parchear con rapidez.
Los resultados finales del AI Cyber Challenge de DARPA, anunciados el 8 de agosto de 2025, indican que los sistemas participantes descubrieron 54 vulnerabilidades sintéticas únicas en los 63 retos de la competición final y parchearon 43 de ellas. Los equipos también encontraron 18 vulnerabilidades reales, no sintéticas, y aportaron 11 parches para vulnerabilidades reales. DARPA informa de una media de 45 minutos para enviar un parche.
Son resultados de competición sobre software de código abierto real elegido para el reto, con las reglas de puntuación de la competición. Muestran lo que es posible, no lo que un equipo concreto verá en su propio código.
Lo que las evidencias no demuestran.
Ninguna de estas fuentes demuestra que la IA pueda corregir cualquier vulnerabilidad sin supervisión.
Demuestran que la IA puede redactar una parte útil de las correcciones y que la corrección debe comprobarse ejecutando la prueba de concepto. Solo el pipeline de producción de Google incluye a una persona en el ciclo; las otras tres fuentes miden sistemas autónomos en condiciones de prueba.
Por eso un flujo de producción añade revisión humana. Ese es exactamente el diseño de un flujo de remediación nativa de IA.
El exploit es la mejor prueba de regresión.
La mayoría de las correcciones de seguridad se verifican leyéndolas.
Un revisor mira el diff, reconoce una consulta parametrizada y la aprueba.
Eso funciona con patrones conocidos. Falla con los sutiles: una comprobación de autorización colocada después de cargar los datos, un sanitizador que pasa por alto una codificación, una actualización de dependencia que deja en su sitio una copia transitiva vulnerable.
Cuando el hallazgo llegó con una prueba de concepto que funciona, la comprobación más sólida es sencilla:
Proof reproduced before the fix:  YES
Proof reproduced after the fix:   NO
Regression tests:                 PASS
Reviewer approval:                YES
Ese registro de cuatro líneas es una evidencia más sólida que razonar solo sobre el diff.
No demuestra que la corrección sea completa. Un cambio que bloquea solo el payload original también supera la repetición, así que las pruebas de regresión deben incluir variantes de la entrada, como otras codificaciones.
También es el registro que un auditor, un cliente o un regulador acabará pidiendo.
¿Qué tipos de fallos puede corregir la remediación nativa de IA?
No todos los hallazgos son buenos candidatos. La idoneidad depende de lo local que sea la corrección y de lo bien que se entienda su patrón.
Fallos clásicos de código.
La inyección, el cross-site scripting, la falsificación de peticiones del lado del servidor, la deserialización insegura y la criptografía débil suelen tener patrones de corrección bien conocidos. El OWASP Top 10
incluye la inyección como A05 y los fallos criptográficos como A04.Fortalezas: las correcciones suelen limitarse a una función, el patrón es estándar y es fácil escribir una prueba de regresión.
Limitaciones: el mismo fallo puede aparecer en más de un sitio, y corregir una llamada no cubre las demás. El flujo debería buscar el mismo patrón en otros lugares, lo que el SSDF del NIST llama revisar el software en busca de vulnerabilidades similares para erradicar una clase.
Fallos de control de acceso y de lógica de negocio.
El control de acceso defectuoso es A01 en el OWASP Top 10
. Abarca fallos como las comprobaciones de propiedad ausentes y la escalada de privilegios. Los fallos de lógica de negocio, como la falta de un límite de frecuencia, están muy cerca.Fortalezas: un hallazgo validado muestra exactamente qué usuario llegó a qué objeto, lo que concreta la comprobación que falta.
Limitaciones: la regla correcta depende de la intención de negocio. ¿Debe un administrador de equipo ver todos los proyectos de la organización o solo los de su equipo?
La IA puede redactar la comprobación. Una persona tiene que confirmar la regla.
Exposición de dependencias y de la cadena de suministro.
Versiones vulnerables, nombres con typosquatting y paquetes que nunca deberían haberse instalado.
Fortalezas: las actualizaciones de versión y los reemplazos de paquetes son mecánicos, y los cambios en el lockfile son fáciles de revisar.
Limitaciones: las actualizaciones de versión mayor pueden romper API. Una corrección puede necesitar cambios de código junto con la subida de versión, y aquí las pruebas importan más que en ningún otro caso.
Fallos introducidos al programar con IA.
Nombres de paquetes alucinados, secretos incrustados en el código, puntos vulnerables a prompt injection y huecos de autorización en código generado.
Fortalezas: estos fallos suelen seguir patrones reconocibles y están en código modificado recientemente, lo que mantiene pequeño el alcance de la corrección.
Limitaciones: el código generado puede no tener ninguna prueba, así que la remediación tiene que añadirlas, no solo cambiar el código.
Fallos de arquitectura.
Un sistema que confía en el límite de una red interna o un diseño que coloca secretos en el cliente.
Fortalezas: las evidencias siguen ayudando a un equipo a entender y priorizar el problema.
Limitaciones: rara vez tienen un diff pequeño y seguro. El resultado adecuado es una explicación clara y un plan para el equipo, no un pull request automatizado.
¿Cuándo es seguro fusionar un pull request de corrección automática?
«Seguro para fusionar» es un juicio del revisor. Estas preguntas hacen ese juicio más rápido y coherente.
- ¿Se validó el hallazgo? ¿Hay evidencias de que la debilidad era real y alcanzable?
- ¿El diff es mínimo? ¿Cada línea modificada tiene relación con el hallazgo?
- ¿La justificación es concreta? ¿Nombra la clase de debilidad, la ubicación en el código y por qué el cambio la elimina?
- ¿Hay pruebas de regresión? ¿Habrían fallado antes del cambio?
- ¿La CI pasa? Entera, sin trabajos omitidos.
- ¿La prueba de concepto falla después de la corrección? ¿Se ha vuelto a ejecutar el exploit o la reproducción original?
- ¿La corrección cambia un comportamiento del que dependen los usuarios? Si es así, ¿lo ha visto el responsable de producto?
- ¿El mismo patrón aparece en otros lugares? Si es así, ¿hay un seguimiento?
Si alguna respuesta es «no» o «no se sabe», el pull request no está listo, por limpio que parezca el diff.
Buenas prácticas de remediación nativa de IA
1. Aliméntala con evidencias, no con alertas
Solo los hallazgos validados deberían entrar en la cola de remediación. Todo lo demás se queda en triaje.
2. Mantén las evidencias adjuntas al cambio
El pull request debe enlazar al hallazgo, a su prueba de concepto y a su contexto. Un revisor nunca debería tener que abrir otra herramienta para entender por qué existe el cambio.
3. Prefiere la corrección correcta más pequeña
Los diffs pequeños son más fáciles de revisar, de probar y de revertir. Las refactorizaciones van en pull requests aparte.
4. Exige pruebas con cada corrección
Una corrección de seguridad sin prueba es una corrección que puede desaparecer en silencio con la siguiente refactorización.
5. Usa tus reglas de revisión existentes
La protección de ramas, los revisores obligatorios y las puertas de CI deben aplicarse a los cambios redactados por IA exactamente igual que a los humanos.
6. Vuelve a probar después de fusionar, no solo antes
Reproduce la prueba de concepto contra el cambio desplegado. Una corrección que funciona en una rama y falla tras el despliegue no es una corrección.
7. Haz seguimiento de las causas raíz a lo largo del tiempo
Registra la clase de debilidad de cada corrección. Si la misma clase vuelve una y otra vez, el problema está antes, en una librería, una plantilla o un hábito de programación.
8. Empieza por clases bien conocidas
Comienza con clases de debilidad que tengan patrones de corrección estándar. Amplía el alcance cuando los revisores confíen en el resultado.
Errores habituales
Automatizar correcciones de hallazgos no validados. Los revisores se ahogan en cambios para problemas que nunca existieron.
Permitir que la IA haga push directamente a una rama protegida. Elimina el único control que hace fiable todo el flujo.
Juzgar una corrección por cómo se lee. Parecerse a una corrección conocida no es ser correcta, como demostró el estudio de OSS-Fuzz.
Omitir las pruebas de regresión porque la CI está en verde. Una CI en verde solo cubre lo que comprueban las pruebas.
Tratar todos los hallazgos como corregibles con código. Algunos problemas necesitan una decisión de diseño, no un diff.
Medir el éxito por los pull requests abiertos. La métrica que importa son los hallazgos cerrados con una nueva prueba superada.
Estándares y marcos aplicables
La remediación nativa de IA es una forma nueva de hacer un trabajo que los estándares existentes ya describen.
NIST Secure Software Development Framework.
NIST SP 800-218, el Secure Software Development Framework (SSDF) publicado en febrero de 2022, tiene un grupo de prácticas llamado Respond to Vulnerabilities (RV). Sus tareas encajan estrechamente con el flujo anterior:
| Tarea del SSDF | Qué pide | Dónde aparece en el flujo |
|---|---|---|
RV.2.1 | Analizar cada vulnerabilidad para reunir suficiente información sobre el riesgo y planificar su remediación | Hallazgo validado y contexto del código |
RV.2.2 | Planificar e implementar respuestas al riesgo de las vulnerabilidades | Cambio redactado y revisión |
RV.3.1 | Analizar las vulnerabilidades identificadas para determinar sus causas raíz | Causa raíz y clase de debilidad |
RV.3.2 | Analizar las causas raíz a lo largo del tiempo para identificar patrones | Seguimiento de las causas raíz a lo largo del tiempo |
RV.3.3 | Revisar el software en busca de vulnerabilidades similares para erradicar una clase de vulnerabilidades | Búsqueda del mismo patrón en otros lugares |
RV.3.4 | Revisar el proceso del SDLC y, si procede, actualizarlo para evitar (o reducir la probabilidad de) que la causa raíz se repita | Corregir antes la librería, la plantilla o el hábito |
El SSDF también pide, en PW.7.2, que los resultados de la revisión y el análisis del código y las remediaciones recomendadas queden registrados en el flujo de trabajo o el gestor de incidencias del equipo de desarrollo. Un pull request con evidencias adjuntas lo hace por diseño.
CISA KEV y BOD 26-04.
Para las agencias federales, la BOD 26-04 fija los plazos de remediación descritos antes, y el estado KEV es uno de sus cuatro factores. Para todos los demás, el catálogo KEV es una lista práctica de prioridades: si se sabe que una vulnerabilidad se está explotando, pasa al principio de la cola de remediación.
OWASP Top 10
.El OWASP Top 10
ofrece un vocabulario común para las clases de fallos que más gestionan los flujos de remediación: control de acceso defectuoso, configuración de seguridad incorrecta, fallos de la cadena de suministro de software, fallos criptográficos, inyección y otras.Ley de Ciberresiliencia de la UE.
La CRA convierte en ley la gestión de vulnerabilidades para los productos con elementos digitales que se venden en la UE. Un registro de remediación que muestre el hallazgo, la corrección, la revisión y la nueva prueba es el tipo de evidencia que ese proceso de gestión necesitará.
Un ejemplo práctico
Imagina una API de facturación creada con ayuda de un asistente de programación con IA.
Un pentest autorizado descubre que un usuario puede descargar la factura de otro cliente cambiando el ID en la URL:
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 200 OK
La segunda petición debería haberse rechazado. El hallazgo se reproduce de forma independiente y se marca como validado, y ambas peticiones y respuestas se conservan como evidencias.
Contexto del código.
Al rastrear la ruta se llega a un único handler:
@app.get("/api/invoices/<int:invoice_id>/pdf")
@login_required
def invoice_pdf(invoice_id):
    invoice = Invoice.query.get_or_404(invoice_id)
    return render_pdf(invoice)
La clase de debilidad es la falta de autorización sobre una clave controlada por el usuario, CWE-639. El usuario está autenticado. La propiedad nunca se comprueba.
Cambio redactado.
El diff propuesto añade la comprobación que falta en el punto donde se carga el objeto:
 def invoice_pdf(invoice_id):
-    invoice = Invoice.query.get_or_404(invoice_id)
+    invoice = Invoice.query.filter_by(
+        id=invoice_id, account_id=current_user.account_id
+    ).first_or_404()
     return render_pdf(invoice)
Devolver 404 en lugar de 403 también evita confirmar que la otra factura existe.
Pruebas.
El cambio incluye dos pruebas. Aquí client_a es un fixture del proyecto: un cliente de pruebas que ya ha iniciado sesión como usuario de la cuenta A.
def test_owner_can_download_invoice(client_a, invoice_a):
    assert client_a.get(f"/api/invoices/{invoice_a.id}/pdf").status_code == 200

def test_other_account_cannot_download_invoice(client_a, invoice_b):
    assert client_a.get(f"/api/invoices/{invoice_b.id}/pdf").status_code == 404
La segunda prueba falla con el código antiguo y pasa con el nuevo.
Revisión y nueva prueba.
El pull request explica el hallazgo, enlaza las evidencias, muestra el diff y las pruebas, y plantea una pregunta al revisor: ¿hay otras rutas de facturas, como el envío por correo o la exportación, que carguen facturas de la misma manera?
El revisor lo comprueba, encuentra una ruta más y pide la misma corrección allí.
Tras la fusión y el despliegue, se vuelven a ejecutar las peticiones originales:
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 404 Not Found
El hallazgo se cierra con pruebas de ambos lados.
Lo que no es la remediación nativa de IA
No es un agente con acceso de escritura a producción.
No sustituye a la revisión de código.
No garantiza que todos los hallazgos se puedan corregir automáticamente.
No es una forma de saltarse las pruebas porque la IA «entendió» el código.
Y no es un motivo para dejar de corregir las causas raíz. Si el mismo fallo aparece cada semana, la respuesta es una librería más segura o una plantilla mejor, no un corrector más rápido.
Dónde encaja Plexicus
Plexicus se basa en un ciclo cerrado: validar, entender, remediar y, después, verificar la corrección antes de fusionarla.
Validar. AI Swarm Pentest explora una aplicación, una API o un código fuente autorizados dentro de un alcance acordado. Cada hallazgo incluye evidencias reproducibles y, si una segunda pasada no puede reproducir el resultado, el hallazgo se marca como no verificado o se descarta.
Entender. Deep Code Analysis rastrea la ruta de código afectada, para que los ingenieros vean los endpoints, los parámetros y la lógica de negocio que toca un hallazgo, junto con los datos a los que puede llegar y el rol que puede activarlo.
Remediar. Plexicus Remediation toma un hallazgo verificado y prepara el contexto de remediación y un cambio sugerido. El flujo afectado, el alcance, la clase de debilidad y la justificación se agrupan en el cambio propuesto. El diff listo para revisión explica el hallazgo original en línea e incluye pruebas de regresión y notas cuando procede.
Entregar. El cambio llega a tu repositorio existente con la asignación de revisores y un hook de nueva prueba conectado a la CI, y tu equipo lo verifica antes de fusionarlo. Plexicus menciona GitHub, GitLab y Bitbucket para los repositorios. Tu equipo fusiona o rechaza con evidencias.
Mantener el control. Plexicus nunca hace push a producción, y tu equipo decide si fusiona. La página de AI Swarm Pentest añade que las propuestas llegan como pull requests o como archivos de parche independientes.
Plexicus describe cuatro tipos de correcciones que prepara: fallos introducidos al desarrollar con herramientas de programación con IA, hallazgos clásicos como la inyección SQL y el cross-site scripting, fallos de lógica de negocio como la autorización a nivel de objeto defectuosa, y exposición de la cadena de suministro como las dependencias con typosquatting, con fijación de versiones y actualización de lockfiles.
Eso es Proof-Driven AppSec aplicado al último tramo: un ciclo cerrado con PR, en el que cada cambio lleva las evidencias que lo originaron.
Si estás en una fase anterior, nuestra guía completa de seguridad de aplicaciones explica dónde encaja la remediación en un programa AppSec moderno, y nuestra explicación del análisis profundo de código explica por qué el contexto del código importa antes de redactar una corrección. Para ver un patrón de corrección aplicado, consulta cómo automatizar la remediación de la inyección SQL.
Preguntas frecuentes
¿Qué diferencia hay entre la remediación nativa de IA y la autorremediación?
La autorremediación suele consistir en aplicar automáticamente una acción predefinida, como un parche o un cambio de configuración. La remediación nativa de IA redacta un cambio de código para un hallazgo validado concreto y lo entrega a una persona para que lo revise antes de fusionar nada.
¿La remediación nativa de IA envía cambios a producción?
No debería. El resultado es un pull request o un archivo de parche, revisado y fusionado mediante tu proceso habitual. Plexicus afirma que nunca hace push a producción.
¿Puede la IA corregir vulnerabilidades correctamente?
A veces, y la investigación muestra cómo saberlo. Google afirma que su pipeline corrigió el 15 % de los errores de sanitizer descubiertos durante las pruebas unitarias, con revisión humana. El estudio de OSS-Fuzz muestra que los parches deben comprobarse ejecutando el exploit, no por lo mucho que se parecen a una corrección conocida.
¿Por qué partir de hallazgos validados y no de la salida de los escáneres?
Porque cada hallazgo sin validar que se convierte en un pull request cuesta tiempo de revisión y quizá no corrija nada. La validación hace que cada cambio merezca la atención de un revisor.
¿Qué pruebas deben acompañar a una corrección de seguridad?
Al menos una prueba que falle con el código antiguo y pase con el nuevo, y otra que confirme que el uso legítimo sigue funcionando. Para los fallos de control de acceso, prueba tanto con el propietario como con una cuenta distinta.
¿La remediación nativa de IA sustituye a los desarrolladores o a los ingenieros de seguridad?
No. Asume las partes repetitivas: reproducir, localizar, redactar y probar. Las personas siguen decidiendo cuál es el comportamiento correcto y si el cambio se fusiona.
¿Qué vulnerabilidades son buenas candidatas?
Los fallos con patrones de corrección locales y bien conocidos, como la inyección, las comprobaciones de propiedad ausentes y las versiones vulnerables de dependencias. Los fallos de arquitectura suelen necesitar un plan, no un diff automatizado.
¿Qué relación tiene con el SSDF del NIST?
Las prácticas Respond to Vulnerabilities del SSDF piden a los equipos analizar cada vulnerabilidad, aplicar una respuesta, encontrar las causas raíz y buscar el mismo fallo en otros lugares. Un flujo de remediación nativa de IA es una forma de llevar a cabo esas tareas con más volumen.
¿Cómo se mide si funciona?
Cuenta los hallazgos cerrados con una nueva prueba superada y el tiempo desde la validación hasta la fusión. Los pull requests abiertos no son una medida útil por sí solos.
¿Puede corregir código escrito por asistentes de programación con IA?
Sí, y ese código a menudo lo necesita. El código generado puede arrastrar fallos clásicos y llegar sin pruebas, así que la corrección debe añadir pruebas además de cambiar el código.
Cierra el ciclo con evidencias
Cada corrección debería demostrar que el hallazgo era real, mostrar por qué funciona el cambio y mostrar que el ataque se detuvo.
Descubre Plexicus Remediation →
¿Quieres echar un primer vistazo a tu propio código? Ejecuta la herramienta SAST gratuita, un análisis estático de tu código fuente en GitHub.